


Python网络爬虫入门:安装requests库与淘宝首页数据爬取解析

本文详细介绍Python网络爬虫的基础概念与核心功能,涵盖搜索引擎、图片抓取、金融分析及营销数据采集等应用场景。教程演示如何在Windows环境下通过pip安装requests第三方库,并提供完整的Python代码示例,展示如何获取淘宝首页HTML源码及使用BeautifulSoup进行初步数据解析,同时强调爬取频率控制与法律合规性注意事项。
网络爬虫基础与应用场景
1.网络爬虫的基本概念
网络爬虫(亦称网络蜘蛛或机器人程序)是一种模拟客户端发送网络请求并接收响应的自动化程序,它依据预设规则自动抓取互联网信息。只要浏览器能够执行的操作,原则上爬虫均能实现。
2.网络爬虫的功能
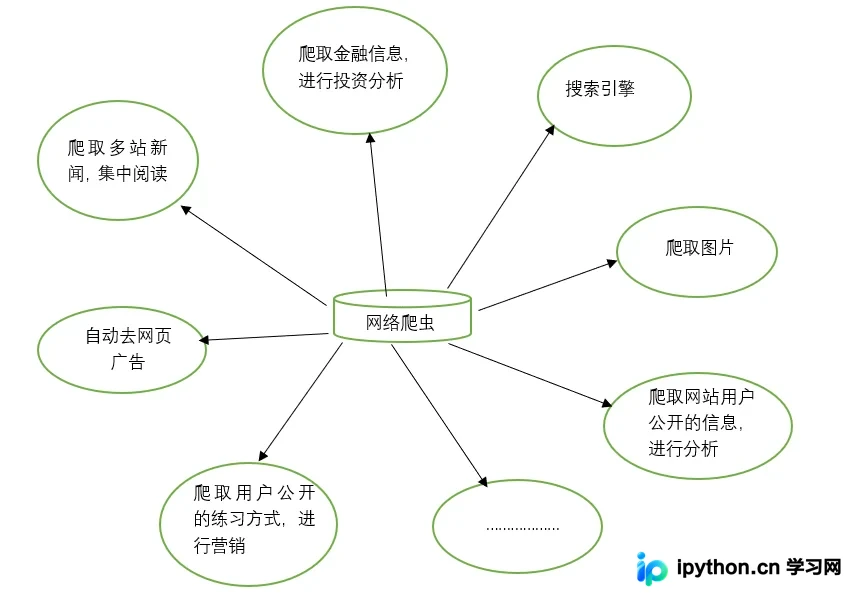
网络爬虫能够替代人工执行多项任务,例如构建搜索引擎、批量下载网站图片供集中浏览,以及在金融投资领域自动采集金融数据以辅助投资决策。
针对用户偏好多个新闻网站但频繁切换浏览不便的问题,可利用爬虫将分散在多站点的新闻信息统一抓取并集中展示,提升阅读效率。
在浏览网页时,若希望过滤广告干扰,可通过爬虫技术将目标网页的核心信息提取出来,从而自动屏蔽广告内容,优化信息获取体验。
在营销场景中,高效获取目标客户及其联系方式至关重要。相较于低效的手工搜索,利用爬虫设定特定规则,可自动从互联网中采集目标用户数据,为营销活动提供支持。
对于非网站管理员而言,手动统计网站用户活跃度、发帖量或热门文章是一项庞大工程。借助爬虫可自动采集这些数据,便于后续深入分析,用户只需编写爬虫程序并设定好抓取规则即可。
此外,爬虫还能实现诸多高级功能。总体而言,爬虫的出现使得原本需要人工访问互联网信息的操作得以自动化,从而更高效地利用互联网中的有效信息。
环境配置:安装requests库
3.安装第三方库
在执行数据爬取与解析之前,需在Python运行环境中下载并安装第三方库requests。
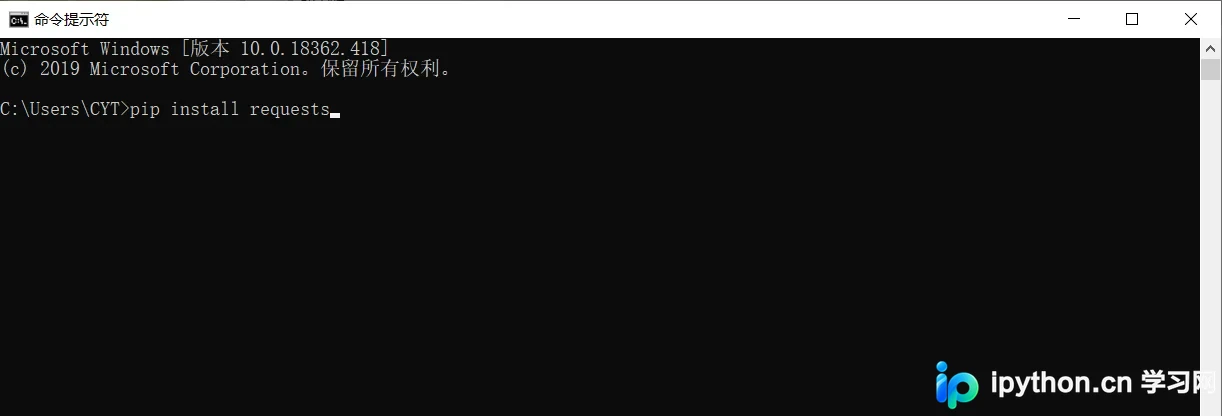
在Windows系统中,打开命令提示符(cmd)界面,输入命令pip install requests并按回车键进行安装(请确保网络连接正常)。具体操作如下图所示。
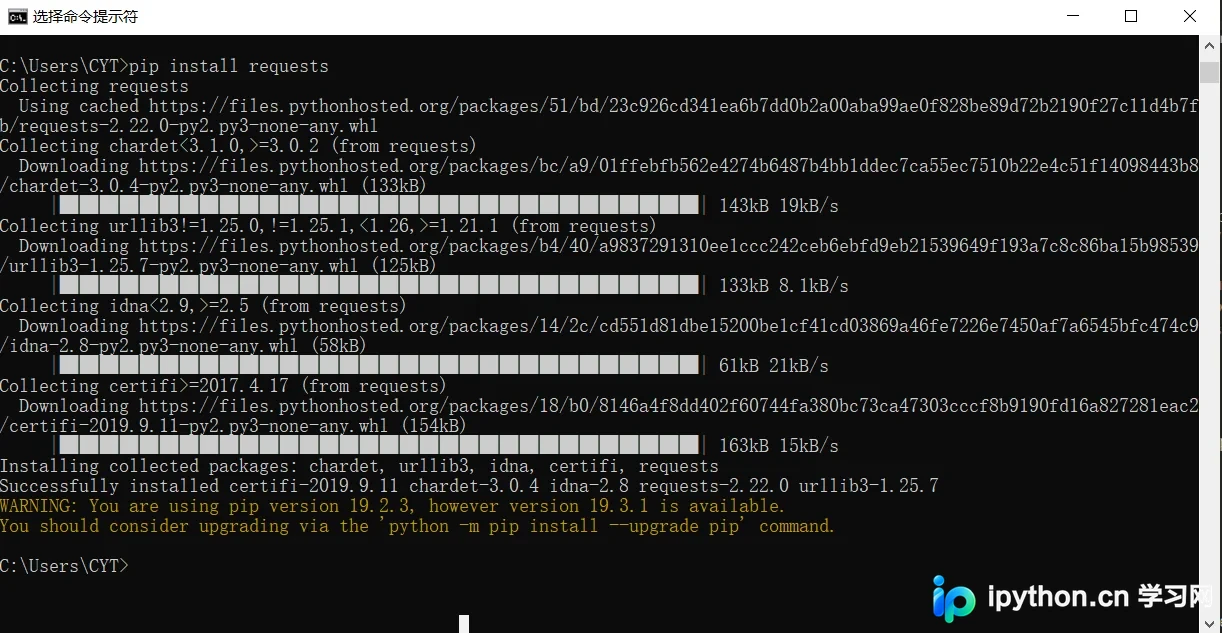
安装完成后,界面显示如下。
实战:淘宝首页数据爬取与解析
4.爬取淘宝首页
# 请求库
import requests
# 用于解决爬取的数据格式化
import io
import sys
sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='utf-8')
# 爬取的网页链接
r= requests.get("https://www.taobao.com/")
# 类型
# print(type(r))
print(r.status_code)
# 中文显示
# r.encoding='utf-8'
r.encoding=None
print(r.encoding)
print(r.text)
result = r.text
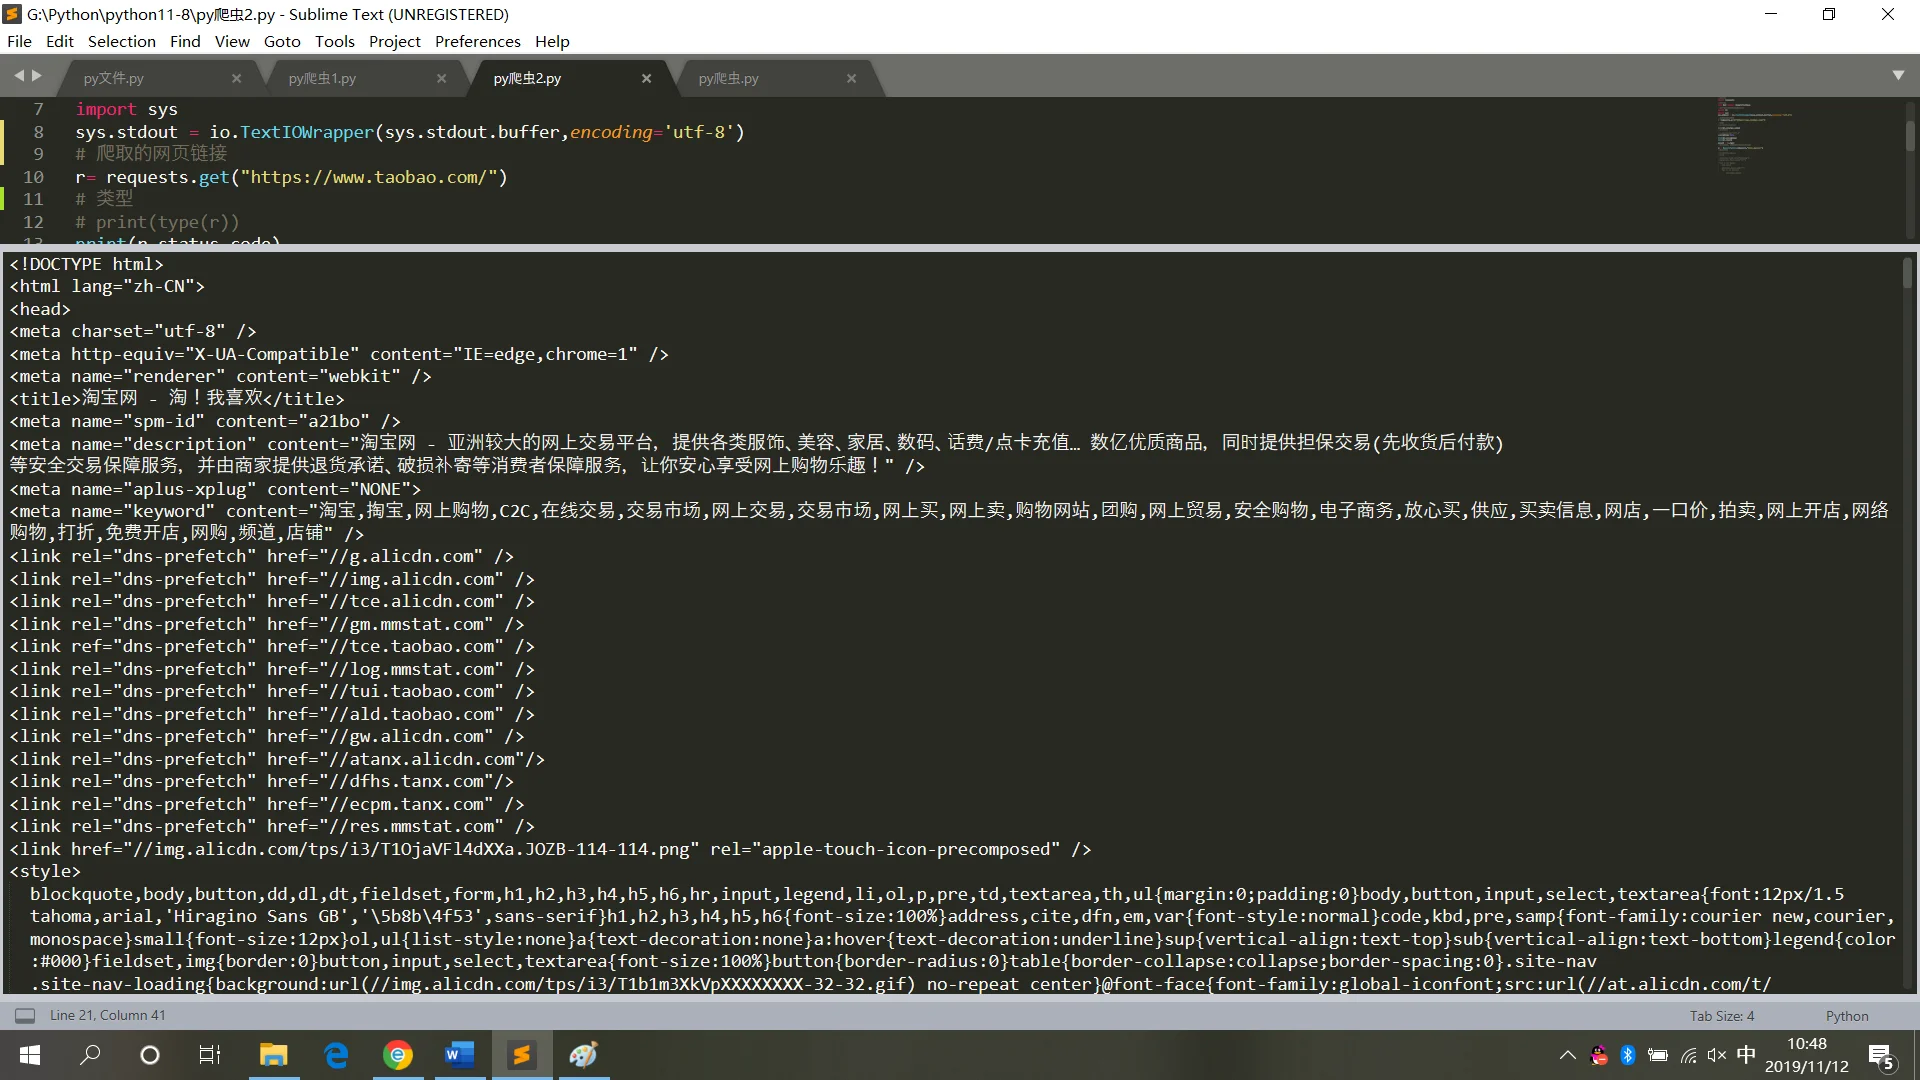
程序运行结果如下图所示。
5.爬取和解析淘宝网首页
# 请求库
import requests
# 解析库
from bs4 import BeautifulSoup
# 用于解决爬取的数据格式化
import io
import sys
sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='utf-8')
# 爬取的网页链接
r= requests.get("https://www.taobao.com/")
# 类型
# print(type(r))
print(r.status_code)
# 中文显示
# r.encoding='utf-8'
r.encoding=None
print(r.encoding)
print(r.text)
result = r.text
# 再次封装,获取具体标签内的内容
bs = BeautifulSoup(result,'html.parser')
# 具体标签
print("解析后的数据")
print(bs.span)
a={}
# 获取已爬取内容中的script标签内容
data=bs.find_all('script')
# 获取已爬取内容中的td标签内容
data1=bs.find_all('td')
# 循环打印输出
for i in data:
 a=i.text
 print(i.text,end='')
 for j in data1:
  print(j.text)
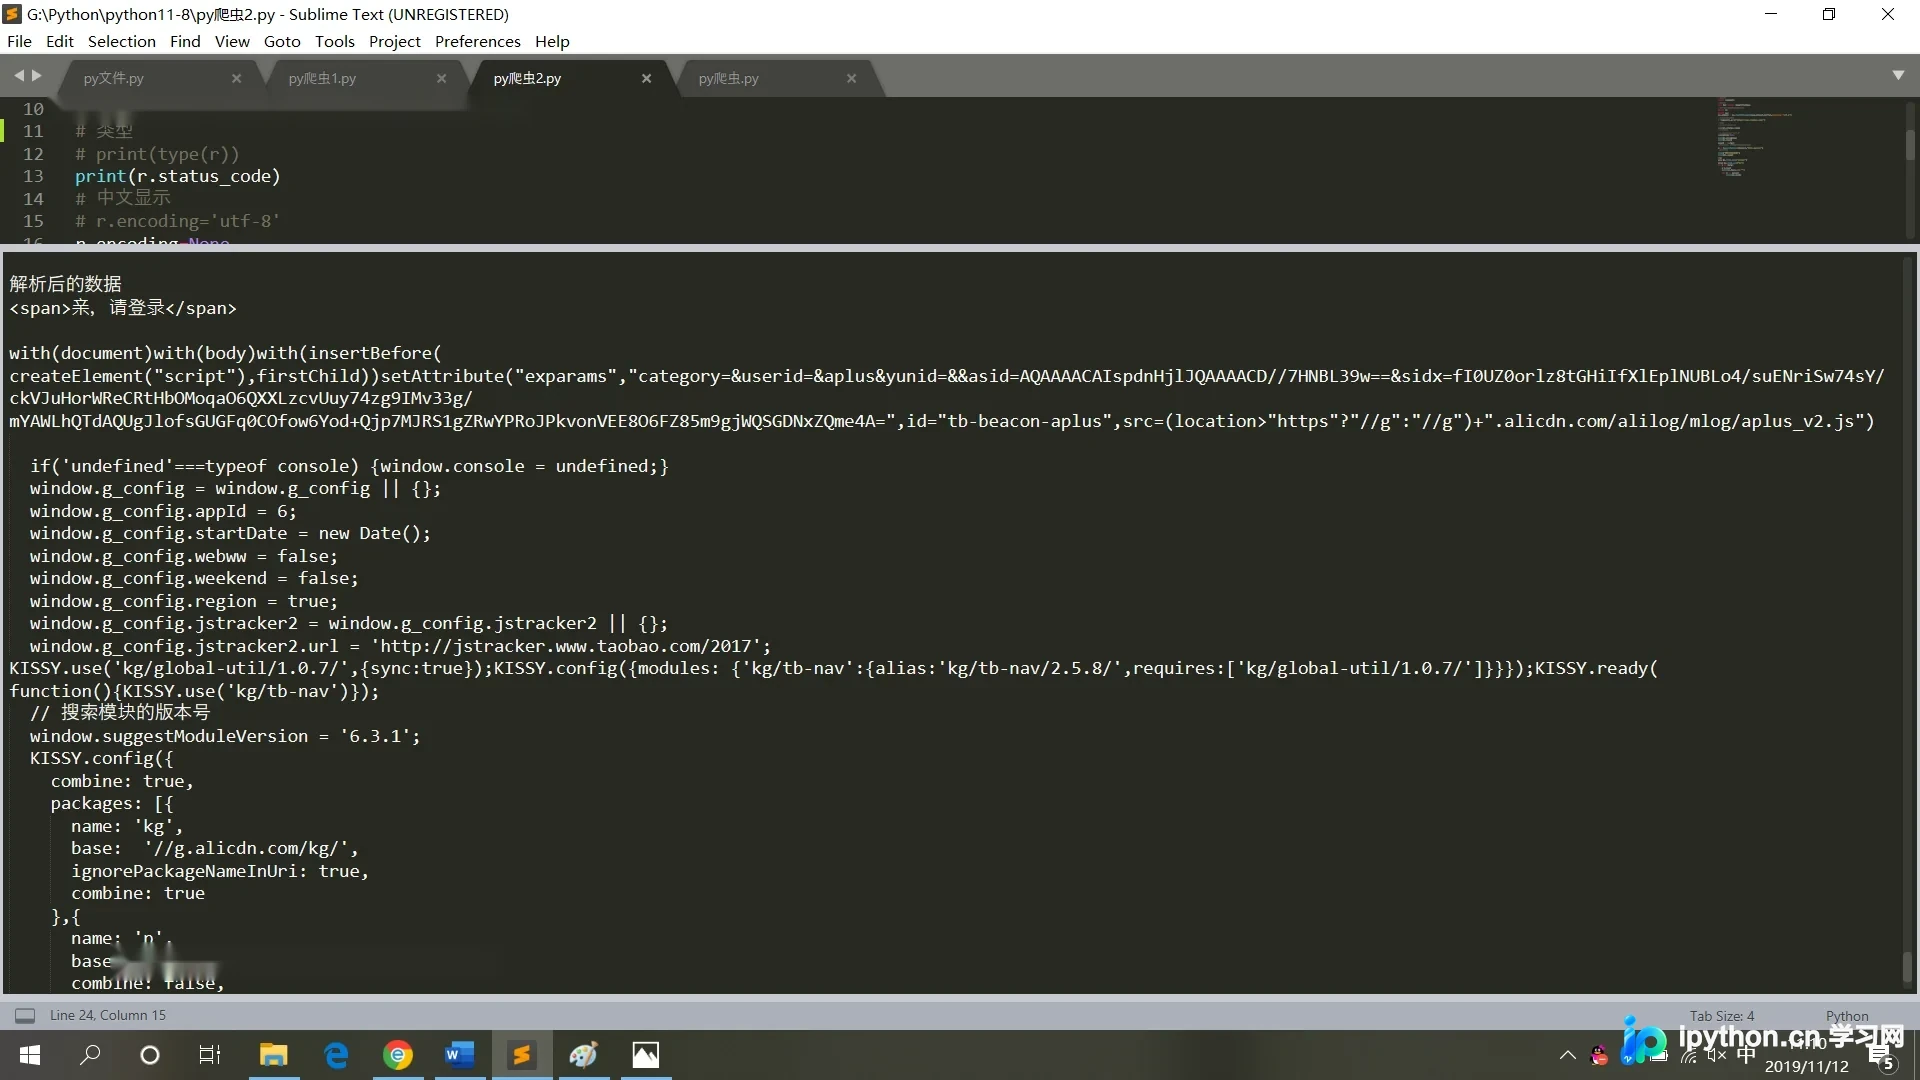
运行结果如下图所示。
6.小结
在进行网页代码爬取时,严禁频繁操作或将其设置为死循环模式。每次爬取均视为对网页的一次访问,频繁操作可能导致目标系统崩溃,并可能引发法律责任。
因此,建议在获取网页数据后,将其保存为本地文本文件,再对本地文件进行解析,以避免重复访问网页。
以上为Python爬虫爬取网页数据并解析数据的详细内容,更多关于Python爬取网页数据及解析的资料请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















