


Python网页数据抓取实战:以Nameberry名字评论为例

本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。
Python网页数据抓取的基本流程
Python网页数据抓取的基本流程
本文选取英文名字查询网站(https://nameberry.com/)作为目标,演示如何抓取每个名字下的用户评论数据。具体需要提取的信息包括:英文名字、评论用户名、评论发布时间以及具体的评论内容。
第一步:确认目标网址与结构
第一步:确认目标网址与结构
首先需要在浏览器中输入初始网址,通过逐层点击链接来浏览网页结构,直到定位到包含所需数据的具体页面。
在浏览器界面中,点击鼠标右键选择“检查”(或按F12),即可打开开发者工具查看网页源代码。在源码中搜索关键文本,可以精确定位到目标数据所在的HTML标签位置。
注意:不同浏览器对源代码查看功能的支持略有差异,主流浏览器如360浏览器、谷歌浏览器(Chrome)、火狐浏览器(Firefox)等均支持此功能。
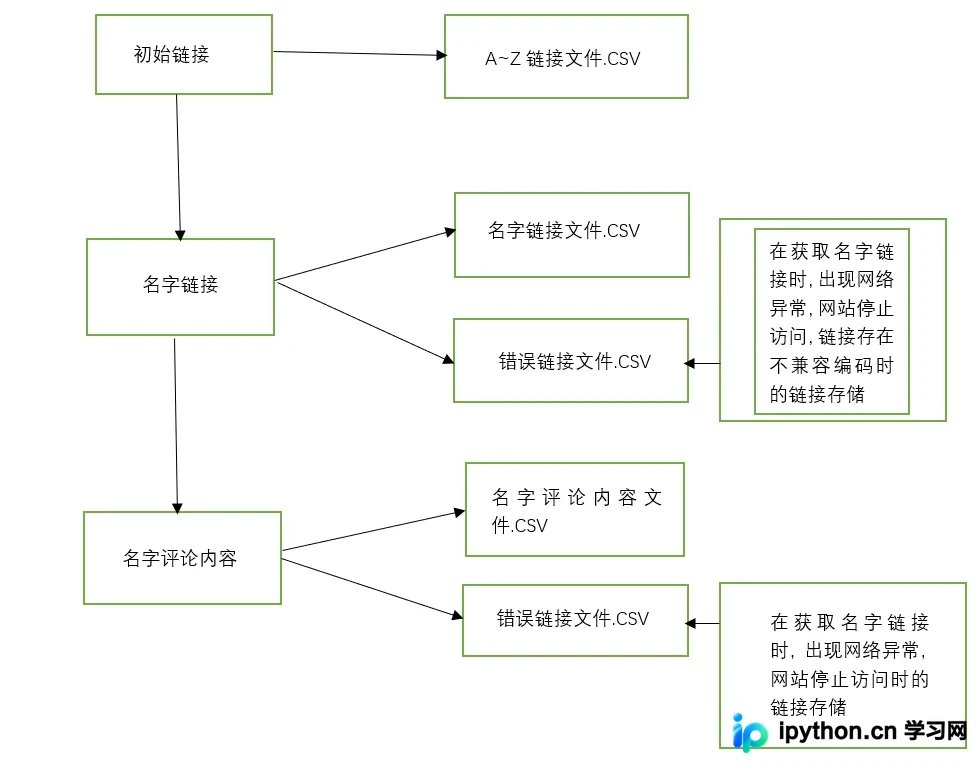
整体抓取流程示意图如下:
1) 首页处理:获取A~Z首字母对应的页面链接
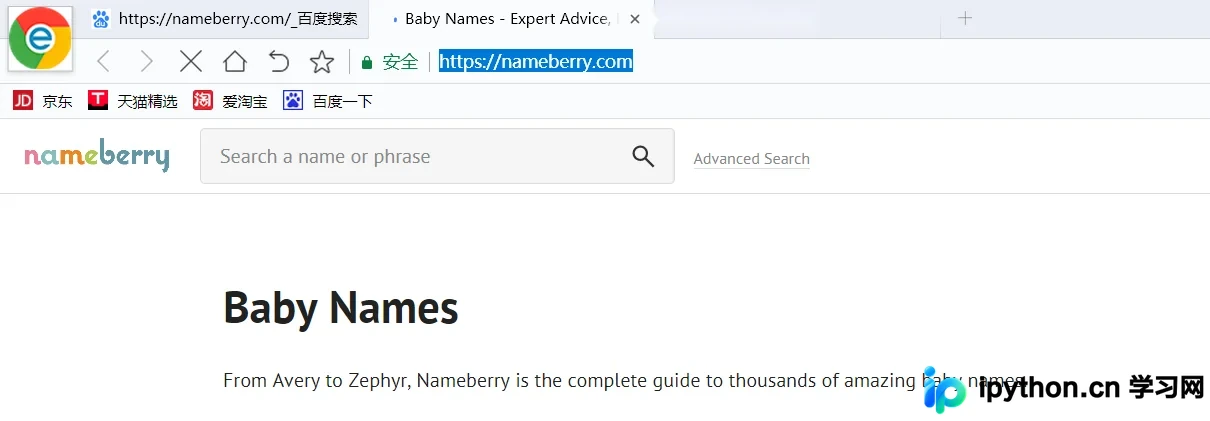
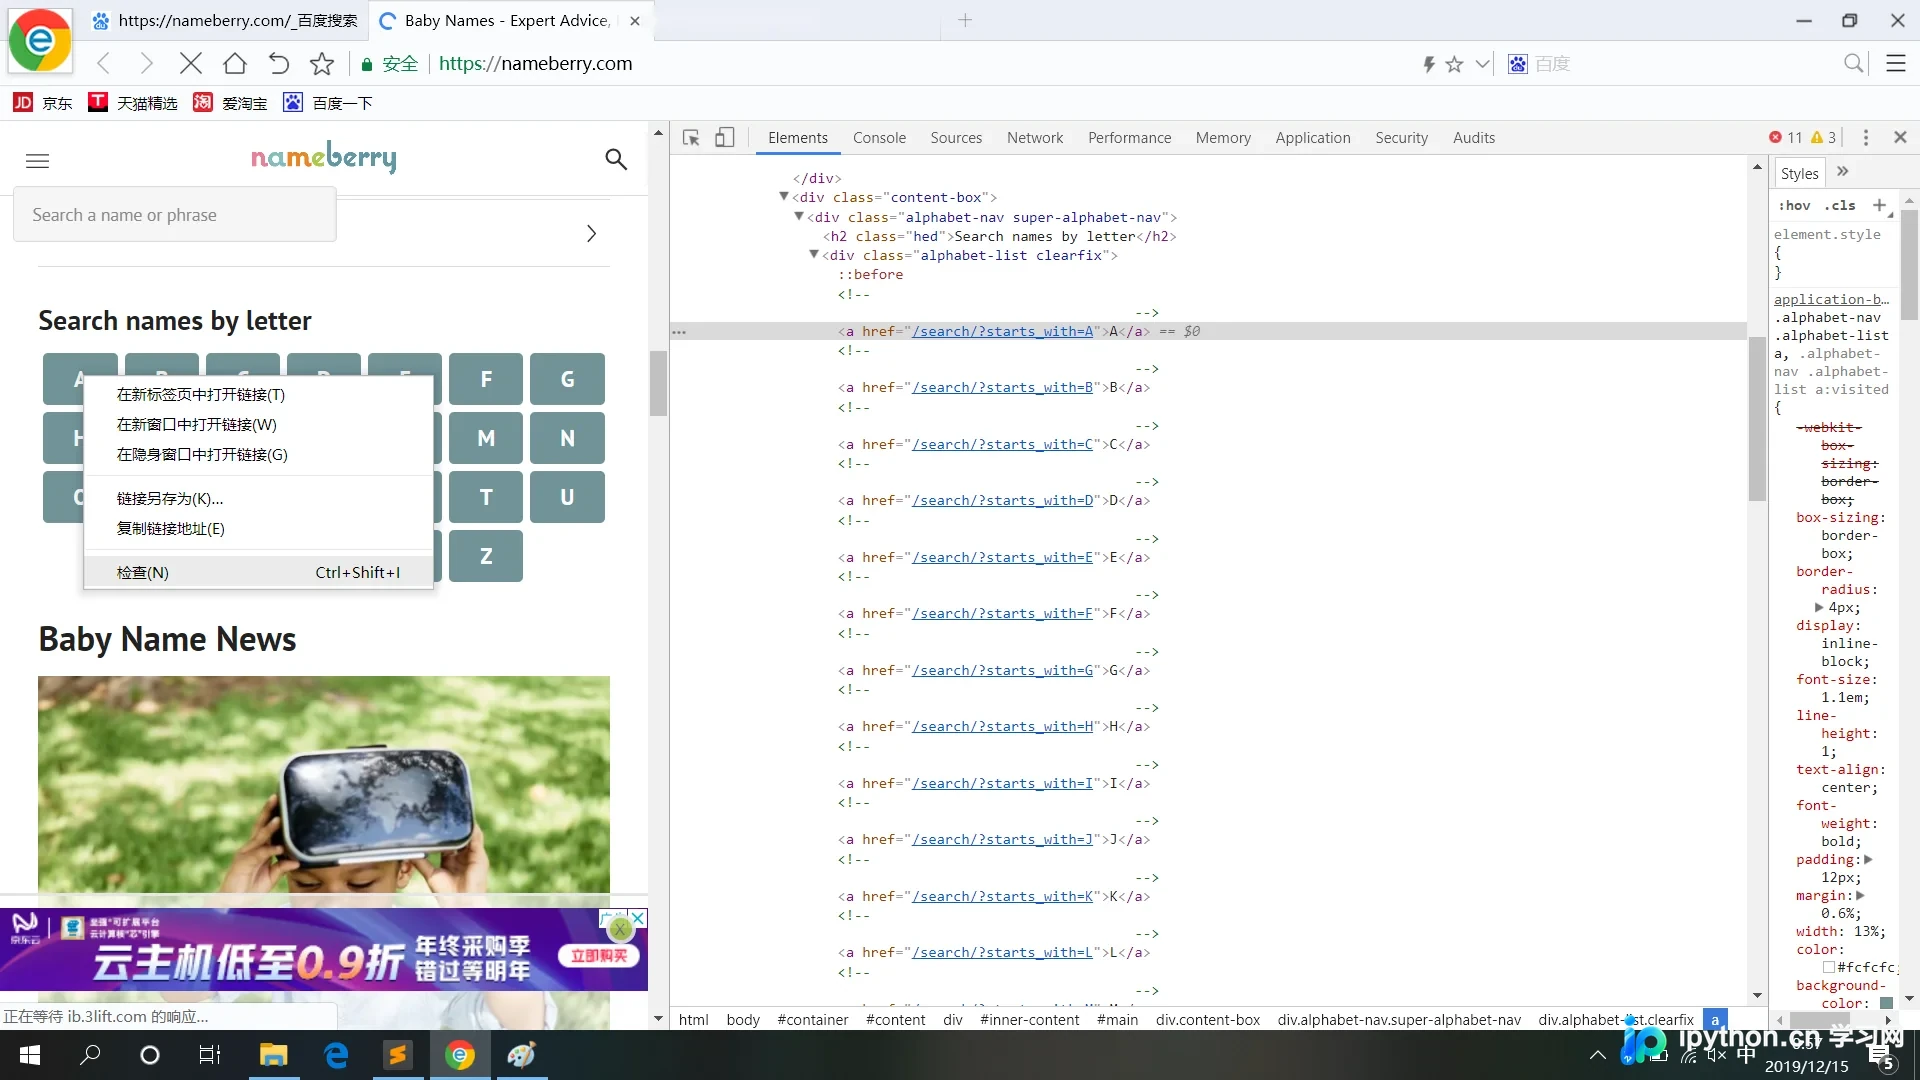
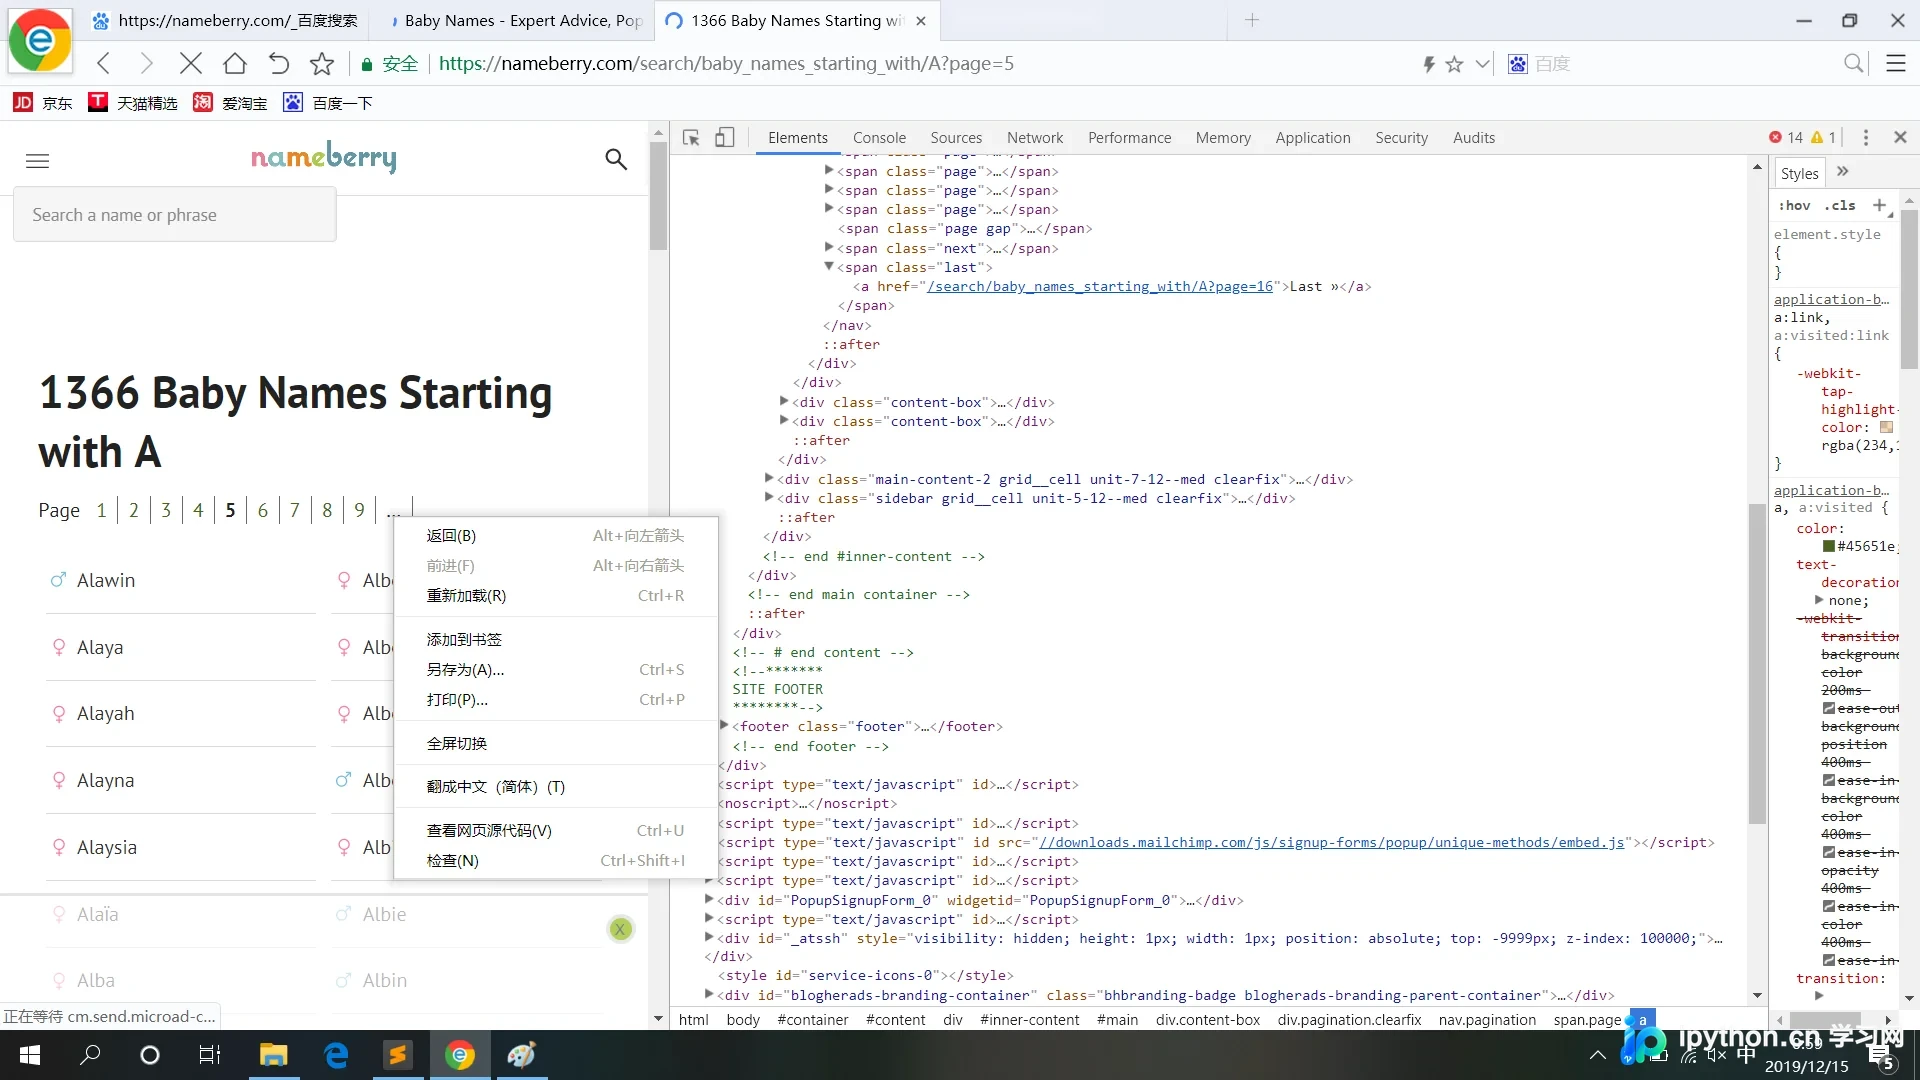
2) 名字列表页:获取每个字母分类下的具体名字链接(需注意处理分页情况)
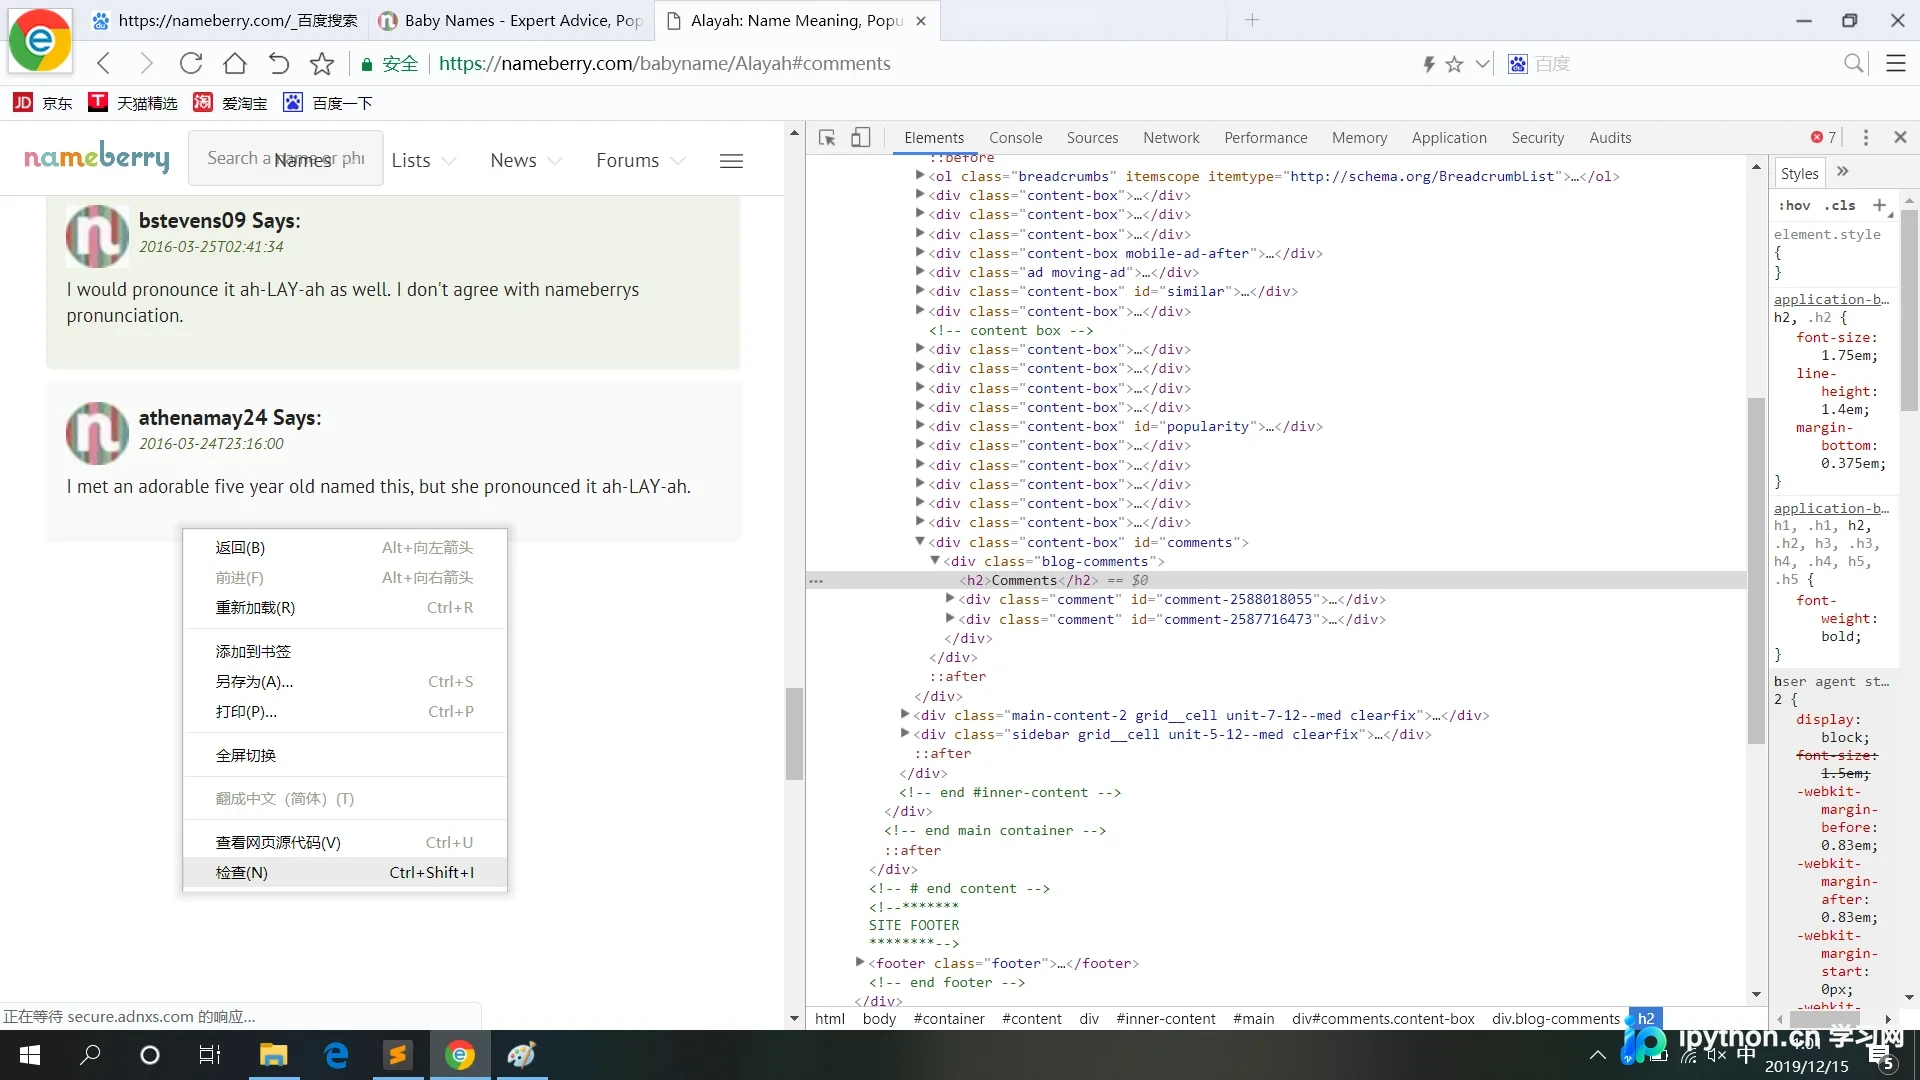
3) 名字详情页:获取每个名字下的具体评论信息
第二步:编写测试代码
第二步:编写测试代码
1) 生成A~Z链接:为了减少因逐层请求导致的网页响应时间,可以根据已知规律自动生成链接。这里采用自动生成A~Z之间的链接,并使用pandas库以二维数组(DataFrame)形式存储这些链接。
def get_url1():
 urls=[]
 # A,'B','C','D','E','F','G','H','I','J','K','L','M','N','O','P','Q','R','S','T','U','V','W','X','Y','Z'
 a=['A','B','C','D','E','F','G','H','I','J','K','L','M','N','O','P','Q','R','S','T','U','V','W','X','Y','Z']    #自动生成A~Z的链接
 for i in a:
  urls.append("https://nameberry.com/search/baby_names_starting_with/%s" %i)
 dp=pd.DataFrame(urls)
 dp.to_csv("A~Z_Link1.csv",mode="a",encoding='utf_8_sig')    #循环用于在每个字母链接下,调用爬取名字链接的页面的函数,即函数嵌套
 for j in urls:
  get_pages_Html(j)
 return urls
2) 获取名字链接:通过分析网页源码,找出包含名字链接的HTML标签,编写代码提取这些链接。将名字链接直接存储到文件中,以便后续读取并获取每个名字对应的评论内容。
#获取页数
def get_pages_Html(url1):
 req = requests.get(url1)
 soup=BeautifulSoup(req.text)
#异常处理,为解决页面不存在多页的问题,使用re正则表达式获取页面数
 try:
  lastpage = soup.find(class_="last").find("a")['href']
  str1='{}'.format(lastpage)
  b=re.findall('\\d+', str1 )
  for page in b:
   num=page
 except:
  num=1
 get_pages(num,url1)
 return num

def get_pages(n,url):
 pages=[]
 for k in range(1,int(n)+1):
  pages.append("{}?page={}".format(url,k))
 dp=pd.DataFrame(pages)
 dp.to_csv("NUM_pages_1.csv",mode="a",encoding='utf_8_sig')
  #函数调用
 for l in pages:
  parse_HTML2(l)
 return pages


# 名字的链接,根据网页源码的标签,确定名字链接的位置
def parse_HTML2(url2):
 try:
  req = requests.get(url2)
  req.encoding = req.apparent_encoding
  soup = BeautifulSoup(req.text)
 except:
  dp=pd.DataFrame(url2)
  dp.to_csv("Error_pages_1.csv",mode="a",encoding='utf_8_sig')
 name_data_l=[]
 error=[]
 li_list = soup.find_all('li',class_="Listing-name pt-15 pb-15 bdb-gray-light w-100pct flex border-highlight")
 try:
  for li in li_list:
   nameList=li.find('a',class_='flex-1')['href']
   name_data_l.append('https://nameberry.com/'+nameList)
   time.sleep(1)
  cun(name_data_l,'Name_List_1')
 except:
  dp=pd.DataFrame(name_data_l)
  dp.to_csv("Error_Name_List_1.csv",mode="a",encoding='utf_8_sig')
  # cun(url2,'Error_link_Q')
 # dp=pd.DataFrame(name_data_l)
 # dp.to_csv("Name_List.csv",mode="a",encoding='utf_8_sig')
 # for i in name_data_l:
 #  parse_HTML3(i)
 return name_data_l
3) 获取评论数据:采用字典格式封装提取到的数据,并将其写入文件保存。
# 名字里的内容
def parse_HTML3(url3):
 count=0
 req = requests.get(url3)
 req.encoding = req.apparent_encoding
 soup = BeautifulSoup(req.text)
 error=[]
 try:
  Name=soup.find('h1',class_='first-header').find("a").get_text().replace(",","").replace("\n","")
 except:
  error.append(url3)
  cun(error,"Error_Link_Comment")
 li_list = soup.find_all('div',class_="comment")
 for li in li_list:
  Title=li.find("h4").get_text().replace(",","").replace("\n","")
  Time=li.find("p",class_='meta').get_text().replace(",","").replace("\n","")
  Comments=li.find("div",class_='comment-text').get_text().replace(",","").replace("\n","")
  dic2={
   "Name":Name,
   "Title":Title,
   "Time":Time,
   "Comments":Comments
  }
  time.sleep(1)
  count=count+1
  save_to_csv(dic2,"Name_data_comment")
  print(count)
 return 1
第三步:测试代码执行
第三步:测试代码执行
1) 函数调用逻辑:代码编写完成后,具体的函数调用逻辑如下:获取链接时采用直接的函数嵌套方式;获取内容时,先从文件中读取已存储的名字链接,再根据这些链接获取名字的评论内容。这种设计避免了逐层实时访问网页可能导致的超时或异常问题。
代码逻辑示意图如下:
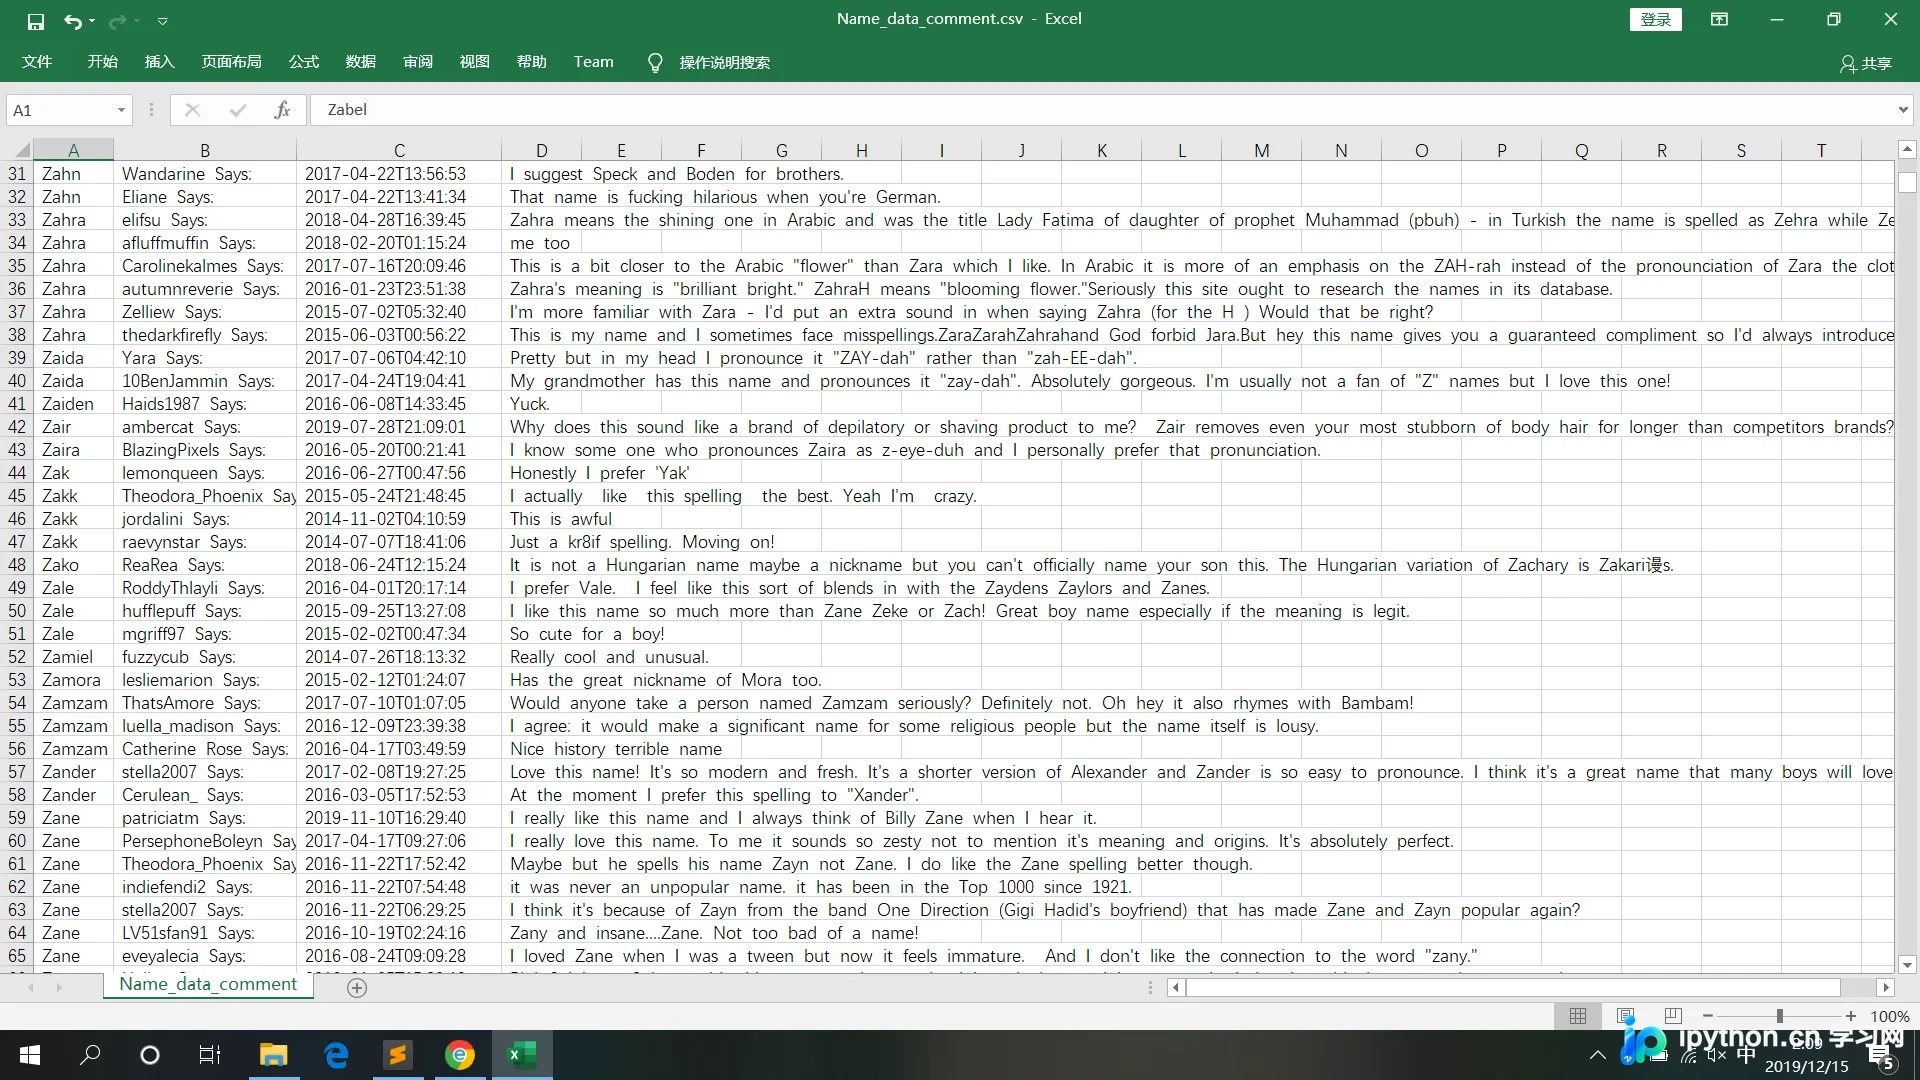
2) 测试结果展示
第四步:小结
第四步:小结
在爬取网页内容时,必须先分析网页源码结构,再进行编码和调试。务必遵守网站的爬虫协议,否则可能导致账号被封禁。当爬取数据量非常大时,建议设置顺序分批请求(即一部分一部分地爬取网页内容),以减轻服务器压力并提高稳定性。
总之,爬虫开发存在风险,测试过程务必谨慎!!!
以上就是Python爬取网页信息的示例的详细内容,更多关于Python爬取网页信息的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















