


提升Python代码运行效率的五大核心策略

本文深入解析提升Python代码执行效率的多种方案。首先强调算法优化与缓存机制的基础作用;其次介绍PyPy通过JIT技术带来的显著加速;接着区分IO密集型与CPU密集型场景,分别推荐threading、asyncio及multiprocessing库的使用;最后探讨分布式计算扩展。旨在帮助开发者根据具体业务场景选择最佳性能优化路径。
优化代码逻辑与算法结构
1. 优化代码逻辑与算法结构
在追求性能之前,务必对现有代码和算法进行审查。许多性能瓶颈可以通过引入更高效的算法或引入缓存机制来解决。虽然本文后续将深入探讨具体技术,但以下是一些通用的优化准则:
- 基于数据测量而非猜测。通过性能分析工具定位耗时最长的代码段,并优先针对这些热点进行优化。
- 实施缓存策略。对于频繁从磁盘、网络或数据库进行的重复查询,缓存结果可以带来显著的性能提升。
- 复用对象而非频繁创建新对象。Python需要执行垃圾回收(Garbage Collection)来释放不再使用的对象内存。大量临时对象的创建与销毁会严重拖慢软件运行速度。
- 尽量减少代码中的迭代次数,尤其是降低单次迭代内的操作复杂度。
- 避免使用深层递归。Python解释器在处理递归时需要消耗大量内存进行上下文维护(Housekeeping)。建议改用生成器或迭代器来实现相同逻辑。
- 控制内存占用。原则上应最小化内存使用,例如对大文件进行逐行解析,而非一次性加载至内存。
- 质疑操作的必要性。看似简单的疑问“是否真的需要执行此操作?”或“能否推迟执行?”、“能否只计算一次并存储结果?”往往能避免重复计算带来的资源浪费。
采用PyPy解释器
2. 采用PyPy解释器
你可能正在使用Python的标准参考实现CPython,因其由C语言编写而得名。如果你的代码属于CPU密集型(CPU bound)任务(具体定义见后文“使用线程”章节),建议评估PyPy。作为CPython的替代方案,PyPy往往能在无需修改任何代码的情况下显著提升速度。
据官方数据,PyPy的平均运行速度比CPython快4.4倍。其核心原理是采用即时编译(Just-in-time,JIT)技术。这与Java和.NET框架中使用的JIT编译类似,而CPython则采用解释执行方式。虽然解释执行提供了更高的灵活性,但牺牲了部分执行速度。
JIT技术允许代码在运行时被即时编译,它结合了提前编译(Ahead-of-time,AOT,如C/C++使用)的速度优势与解释执行的灵活性。此外,JIT编译器可在运行过程中持续优化代码,程序运行时间越长,优化效果越明显。
近年来,PyPy取得了显著进展,通常可作为Python 2和Python 3的无缝替换方案。借助Pipenv等工具,PyPy也能良好运行,建议尝试集成。
利用多线程处理IO任务
3. 利用多线程处理IO任务
大多数软件属于IO密集型而非CPU密集型。若对这两个概念尚不熟悉,请参考以下定义:
- IO密集型(I/O bound):程序主要时间花费在等待输入/输出操作完成,例如从网络或慢速存储设备读取数据。
- CPU密集型(CPU bound):程序大量占用CPU资源,充分利用计算能力以生成结果。
在等待网络或磁盘响应时,可以使用多线程让其他任务继续执行,从而避免CPU空闲。
线程是独立的执行序列。Python默认有一个主线程,但你可以创建多个线程并让解释器在它们之间切换。由于切换速度极快,这些线程看起来像是并行运行。
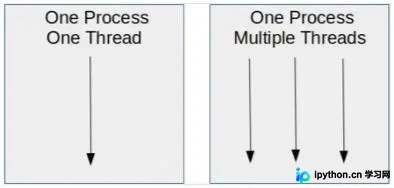
然而,与其他语言不同,Python中的线程并非真正并行执行,而是交替运行。这是由于全局解释器锁(Global Interpreter Lock,GIL)机制的存在。关于GIL及threading库的详细机制,可参考我撰写的。
结论是:线程对IO密集型软件有显著加速作用,但对CPU密集型软件几乎无效。
原因在于:当一个线程等待网络响应时,其他线程可继续执行。若涉及大量网络请求,多线程效果显著;但若线程进行繁重计算,它们只能等待轮次,此时多线程反而增加开销。
使用Asyncio异步编程
4. 使用Asyncio异步编程
Asyncio是Python中较新的核心库,旨在解决与线程相同的IO密集型性能问题,但实现机制不同。需坦诚说明,Asyncio对初学者而言较为复杂,且由于其快速发展,网络上的教程和示例代码往往过时。尽管如此,它仍具有实用价值。
多处理器并行计算
5. 多处理器并行计算
对于CPU密集型软件,通常可通过重写代码以利用多个处理器,从而实现执行速度的线性提升。
这被称为并行计算,但并非所有算法都支持并行化。例如,简单递归算法难以直接并行化,但通常存在可良好并行化的替代算法。
利用多处理器主要有两种方式:
- 在同一台机器内使用多个处理器或内核。在Python中,可通过multiprocessing库实现。
- 利用计算机网络,将计算分布到多台计算机上,即分布式计算。
这篇主要介绍如何在单机范围内扩展Python软件,并详细讲解了multiprocessing库。若此方案适合你,建议深入阅读。
与threading库不同,multiprocessing库绕过了Python的全局解释器锁(GIL)。它通过派生多个独立的Python进程来实现并行,从而允许多个Python实例同时运行代码,而非在单个进程中轮流执行线程。
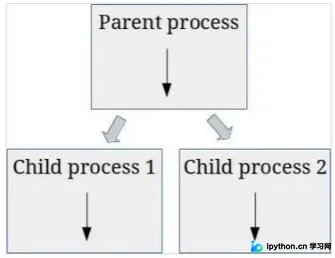
multiprocessing与threading库接口相似,但为何还需考虑线程?答案是:线程是“轻量级”的,仅需一个Python解释器实例,内存占用更少。而创建新进程存在额外开销。因此,对于IO密集型代码,线程通常已足够。
实现软件并行后,迈向使用Hadoop等分布式计算平台仅是半步之遥。借助云计算平台,可扩展规模相对容易。例如,可在云端处理大型数据集,并在本地使用结果。这种混合模式可节省资金,因为云端算力成本高昂。
总结
总结
综上所述,提升Python代码效率的建议如下:
- 首先,优先优化算法和代码逻辑。
- 若基础速度仍不足,可考虑使用PyPy。
- 针对IO密集型软件,使用threading库或asyncio。
- 针对CPU密集型问题,使用multiprocessing库。
- 若上述措施仍无法满足需求,可利用Hadoop等云计算平台进行分布式扩展。
以上即为提升Python代码运行效率的详细建议,更多关于Python性能优化的内容请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















