


Python实现验证码识别:Tesseract与pytesseract配置详解

本文详细介绍如何使用Python结合Tesseract OCR引擎识别验证码。内容涵盖pytesseract库的安装、Tesseract程序下载与环境变量配置、pytesseract.py文件修改以及完整代码示例。通过实际测试展示识别效果,并指出当前方案对特定样式验证码的局限性,为开发者提供快速上手的参考指南。
Python验证码识别环境准备
直接开始操作。首先需要安装必要的Python库。
pip install pytesseract
pip install PILLOW
Tesseract OCR安装与配置
接下来,需下载并安装Tesseract程序。
Tesseract官方下载地址为:https://digi.bib.uni-mannheim.de/tesseract/。请根据操作系统下载对应的exe文件进行安装。
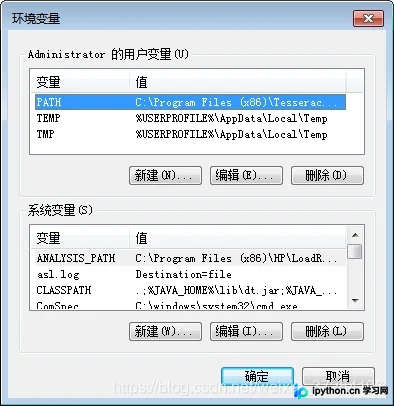
配置环境变量:在用户变量和系统变量中添加PATH,指向Tesseract安装目录,例如 C:\Program Files (x86)\Tesseract-OCR;同时在系统变量中添加 TESSDATA_PREFIX,指向同一目录。注意:部分教程建议将TESSDATA_PREFIX指向tessdata子目录,但在某些配置下这可能导致目录层级错误,进而引发命令执行时找不到文件的问题。建议根据实际调试结果选择有效的配置方式。
pytesseract库代码修改
找到pytesseract.py文件,修改并添加tesseract.exe的路径配置。
tesseract_cmd = 'C:\\Program Files (x86)\\Tesseract-OCR\\tesseract.exe'
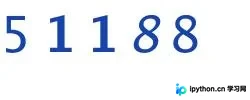
#! -*- coding:utf-8 -*-

import pytesseract
from PIL import Image
im=Image.open('D:/py3.8/src/商标/8.jpg')
code = pytesseract.image_to_string(im).strip()
print('验证码识别结果:'+code)
print(type(code))
if(code =='51188'):
  print('ok')
# print(pytesseract.image_to_string(im))
识别结果与局限性分析
执行上述配置后的运行结果。
验证码识别结果为:51188,类型为<class 'str'>,输出ok。
进程结束,退出码为0。
该方案仅能识别部分验证码,对于包含加粗线条或下划线的验证码,识别效果不佳。
关于Python识别验证码的实现示例介绍至此。如需了解更多Python验证码识别相关内容,建议搜索本站历史文章或继续浏览后续相关文章,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















