


深入解析LRU缓存淘汰算法原理与Python实现

本文深入解析LRU(最近最少使用)缓存淘汰算法的核心原理,阐述其在后端服务中的应用价值。详细讲解如何利用哈希表与双向链表结合实现O(1)复杂度的读写操作,并提供两种Python实现方案:基于自定义数据结构的完整实现及利用OrderedDict的简洁实现,帮助工程师掌握高性能缓存设计。
LRU缓存算法概述
大家好,欢迎进入算法与数据结构专题。今天我们将探讨一种在工程实践中极为常用的算法——LRU。
LRU的全称是Least Recently Used,即“最不经常使用”或“最近最少使用”。这个概念初看可能有些抽象,但必须结合缓存机制来理解。在现代互联网应用中,缓存是至关重要的基础设施。为了让大家更好地理解,我们将从缓存的基本机制讲起。
缓存机制与LRU策略
缓存
Cache(缓存)一词最早源于CPU与主存之间的数据交互。早期这块存储被称为“高速缓存”,如今该术语已较少使用,但这并不影响其重要性。由于缓存的读写速度介于CPU和主存之间,它主要起到数据过渡的作用。CPU从缓存读取数据,而主存中的数据会先加载到缓存中,再进入CPU处理。
随着技术发展,缓存的应用场景日益丰富。在后端服务中,缓存主要用于快速响应请求。其思想与记忆化搜索类似:预先存储可能需要的数据,后续请求可直接从内存读取,无需重新计算。原理相同,将返回给用户的数据存储在内存中,当相同请求再次到来时,直接返回内存中的结果,避免重复执行完整链路。
举一个简单的例子,打开淘宝首页时会看到大量商品推荐。推荐流程极其复杂:首先根据策略从商品库召回商品,例如基于用户历史行为召回相关商品;接着进行数据清洗,过滤掉不感兴趣或违规的商品;随后利用机器学习或深度学习模型预测点击率,将高点击概率的商品排在前列。
推荐流程尚未结束。商品列表通常分展位展示,部分位置由运营配置,部分固定展示广告,广告也有独立的处理链路,其他位置还有特定逻辑。获取所有商品数据后,还需加载图片及其他零散信息,最终才能展示。因此,打开淘宝首页比打开百度首页慢得多,这并非技术落后,而是中间链路过长所致。
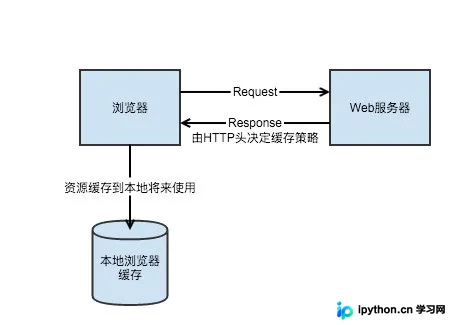
对于频繁访问淘宝的用户而言,每次完整执行上述链路显然没有必要。我们可以将之前的展示结果存储在内存中,下次遇到相同请求时,直接从内存读取并返回。这样能节省大量时间和计算资源,例如在大促期间,可将节省的资源用于更关键的业务场景。
缓存虽好,但并非万能。内存成本高昂,无法存储所有数据,只能存放高价值数据。为此,计算机科学家设计了多种策略来调度缓存,保持数据的高价值。LRU便是其中一种常用策略。
LRU核心原理与数据结构设计
LRU含义
前文提到,LRU意为“最近最少使用”,也可理解为“最久未使用”。该策略以最近一次使用的时间来衡量内存块的价值:越久未使用的数据价值越低,最近刚使用过的数据后续被再次使用的概率越大,价值越高。
仅凭此限制还不够。由于内存珍贵,缓存存储的数据量是有限的。例如,若固定只能存储1万条数据,当缓存满时,每插入一条新数据,都必须淘汰一条最久未使用的旧数据。这样既保证了缓存内数据的高价值,又确保内存使用不超过限制。
总结上述内容,LRU策略需满足以下几点要求:
1. 保证缓存的读写效率,读写复杂度均为O(1)。
2. 当缓存中的数据被读取时,更新其最近使用的时间。
3. 当插入新数据时,弹出更新时间最远(最久未使用)的数据。
LRU原理
仔细思考这个问题,会发现实现并不简单。显然,数组无法实现此缓存,因为数组查询速度慢,无法达到O(1)复杂度。同样,仅使用HashMap也不行,虽然查询可达O(1),但无法高效更新最近使用时间,也难以快速定位最久未使用的数据。
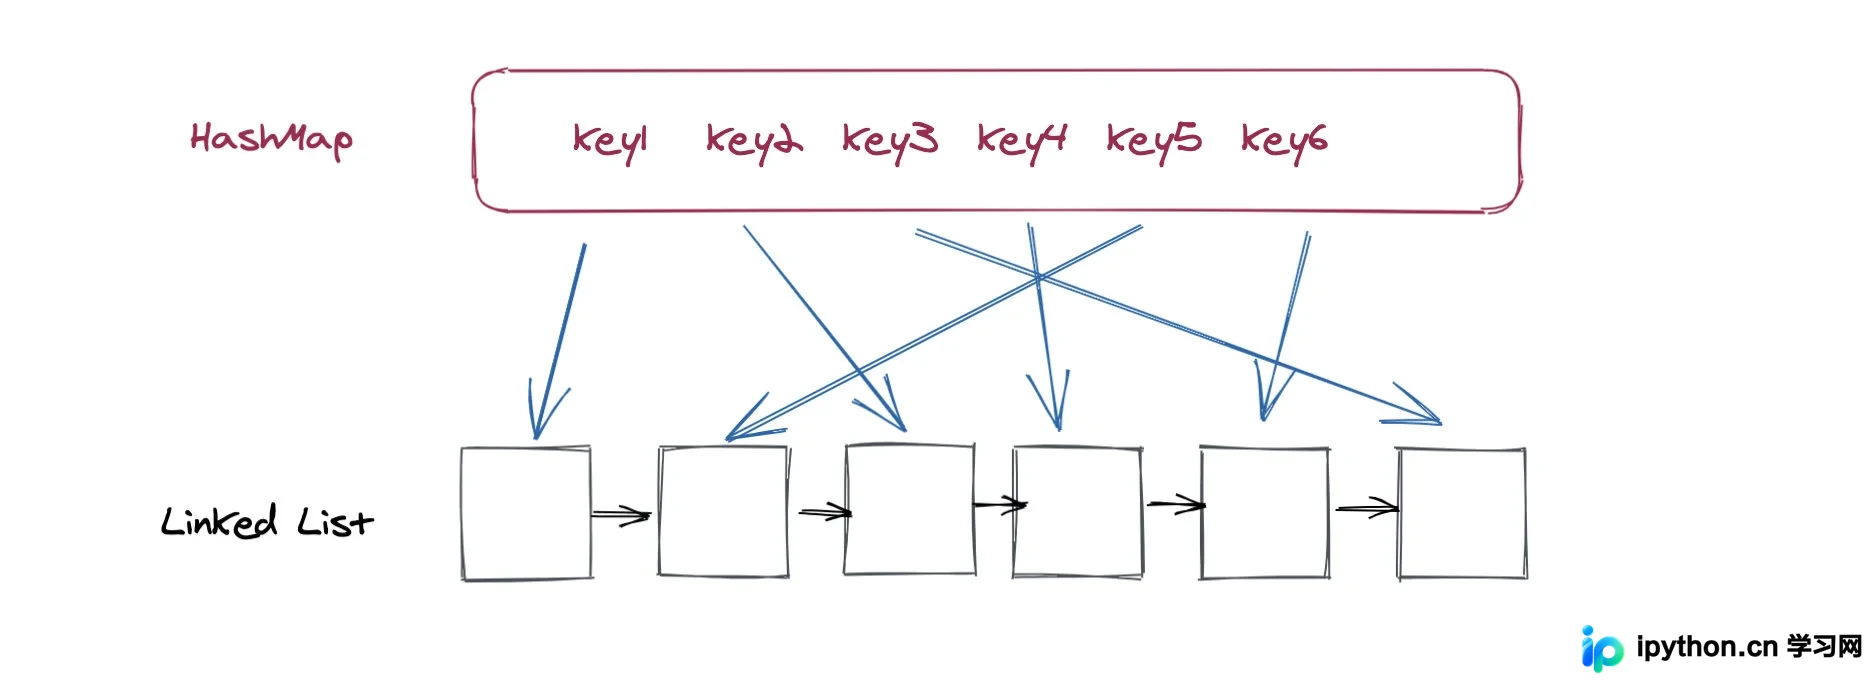
若在面试中思考至此,许多人可能束手无策。但冷静分析,问题并不模糊。HashMap是必须的,因为只有它能实现O(1)时间的读写,其他数据结构几乎不可行。然而,仅靠HashMap无法解决更新和淘汰问题,必须配合其他数据结构。该结构需支持快速插入和删除,答案显而易见:链表。
链表存在一个问题:查询链表中某个节点需要O(n)时间,这是不可接受的。但此问题并非无法解决,解决方案很简单:将链表中的节点作为HashMap中的值进行存储。最终得到的系统架构如下:
查找与更新操作详解
对于缓存而言,主要只有两种功能:查找和更新。
查找
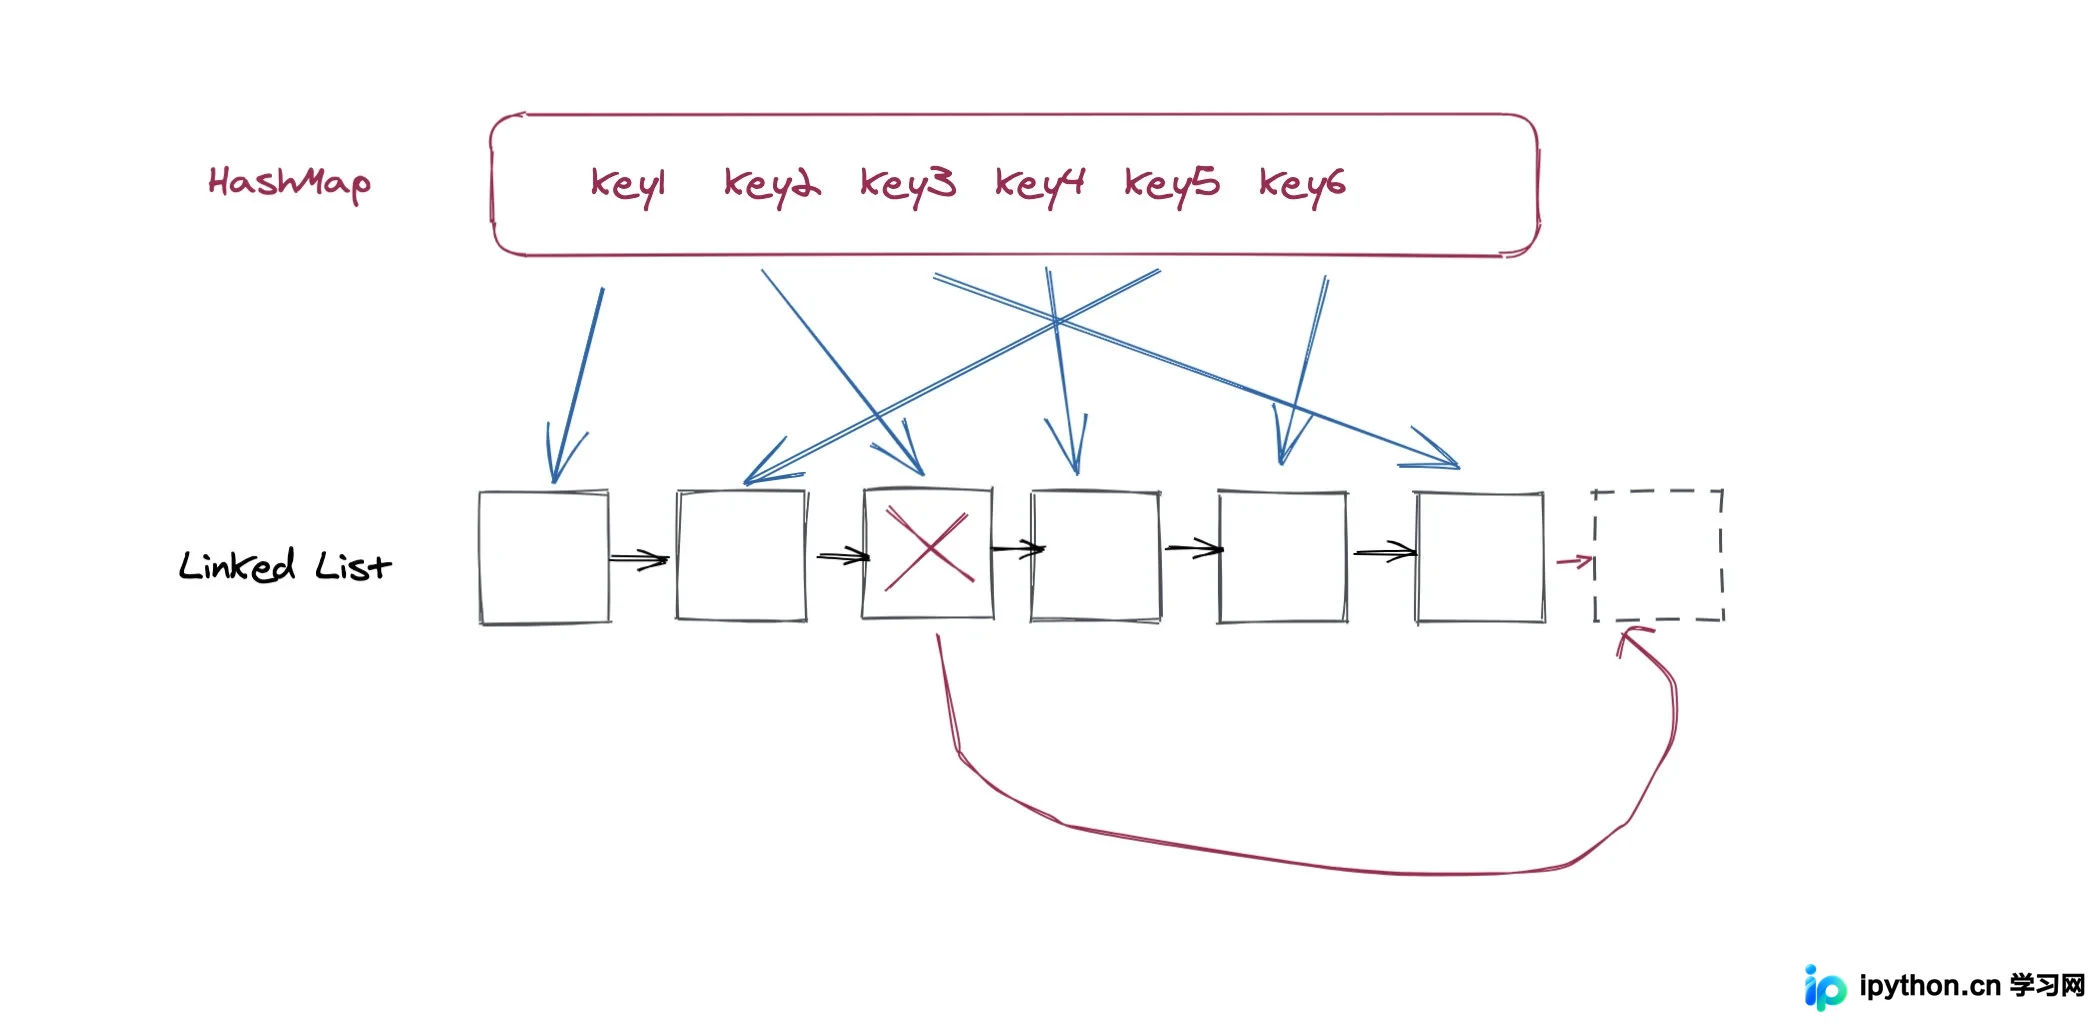
查找分为两种情况:第一种是未找到,直接返回空即可;第二种是找到节点,在返回结果的同时,需将该节点在链表中的位置进行移动。假设链表头部表示数据较旧,尾部表示数据较新,查找结束后,需将节点移动至链表尾部。
移动可通过两个步骤完成:第一步是在链表中删除该节点,第二步是将节点插入到尾部:
更新
更新同样分为两种情况。第一种是更新的Key已存在于HashMap中,此时只需更新对应的Value,并将其移动到链表尾部。操作与上述查找类似,仅多了一步更新HashMap,这很容易理解。
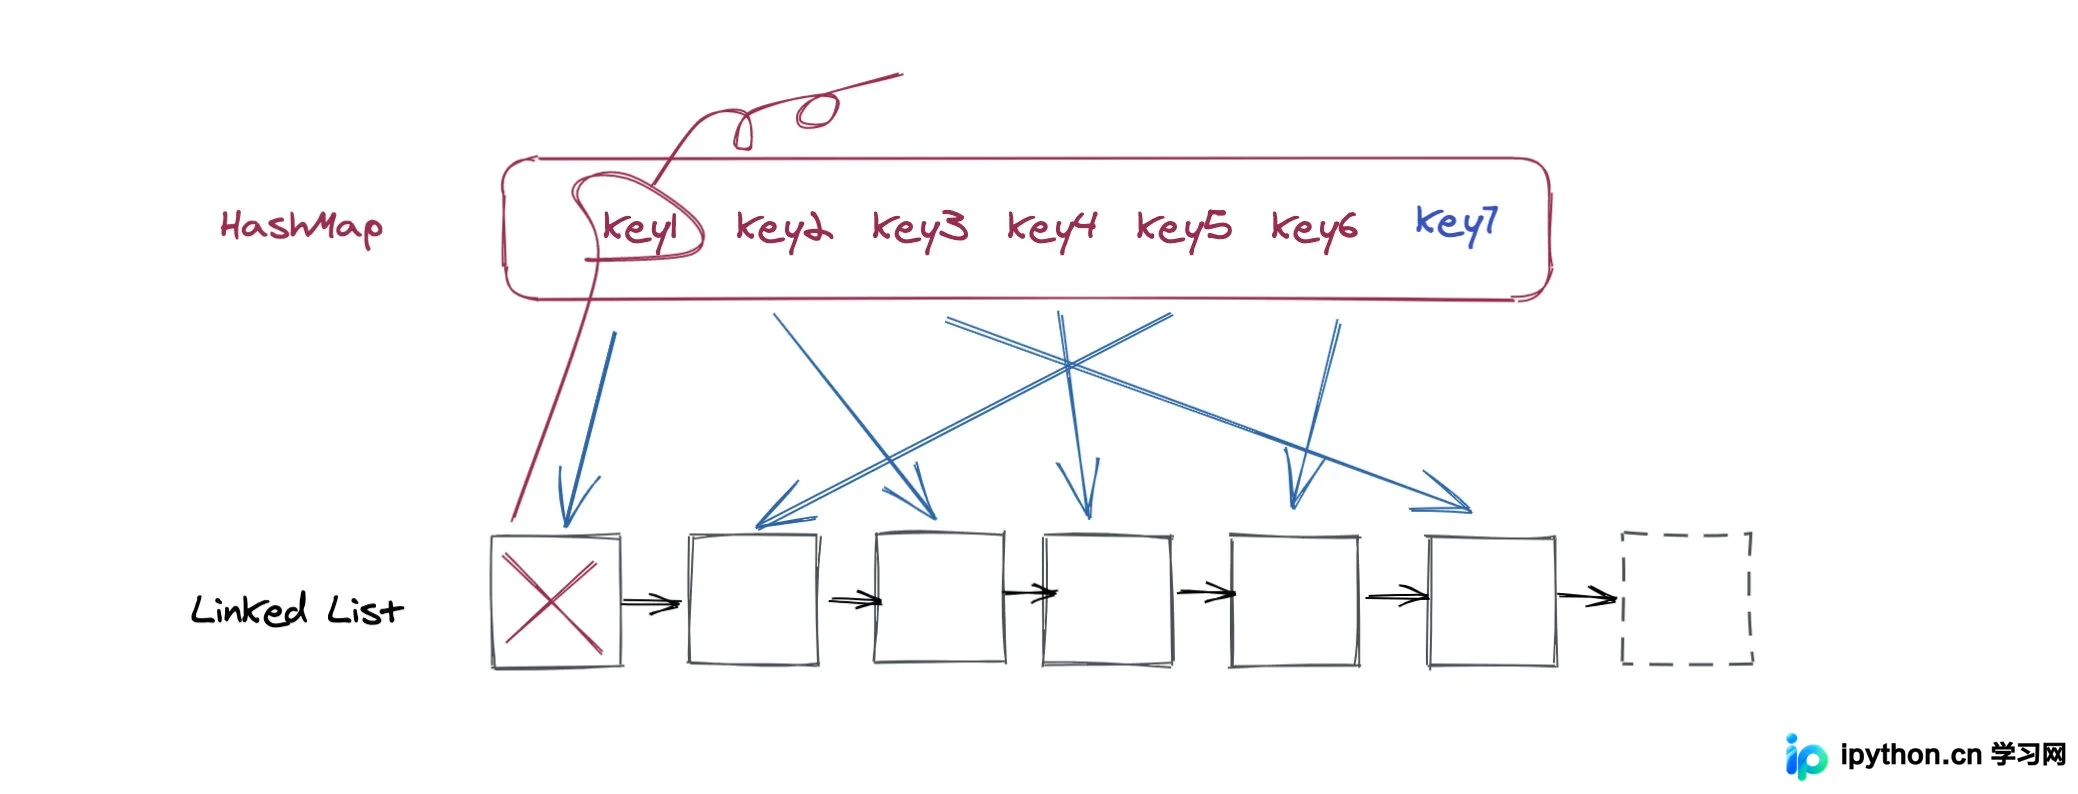
第二种情况是更新的Key在链表中不存在,这又分两种子情况:若缓存数量未达限制,直接添加到链表结尾即可;若链表已满,则需先移除一个元素再放入新数据。此时需删除链表的第一个元素,不仅要在链表中删除,还需在HashMap中删除对应值,否则仍会占用内存。
由于需执行从链表到HashMap的反向删除操作,链表节点中需记录Key值,否则无法完成删除。删除后再加入新节点,过程较为简单:
Python代码实现
理清整个过程后,我们来看代码实现:
class Node:
  def __init__(self, key, val, prev=None, succ=None):
    self.key = key
    self.val = val
    # 前驱
    self.prev = prev
    # 后继
    self.succ = succ

  def __repr__(self):
    return str(self.val)


class LinkedList:
  def __init__(self):
    self.head = Node(None, 'header')
    self.tail = Node(None, 'tail')
    self.head.succ = self.tail
    self.tail.prev = self.head

  def append(self, node):
    # 将node节点添加在链表尾部
    prev = self.tail.prev
    node.prev = prev
    node.succ = prev.succ
    prev.succ = node
    node.succ.prev = node

  def delete(self, node):
    # 删除节点
    prev = node.prev
    succ = node.succ
    succ.prev, prev.succ = prev, succ

  def get_head(self):
    # 返回第一个节点
    return self.head.succ


class LRU:
  def __init__(self, cap=100):
    # cap即capacity,容量
    self.cap = cap
    self.cache = {}
    self.linked_list = LinkedList()


  def get(self, key):
    if key not in self.cache:
      return None

    self.put_recently(key)
    return self.cache[key]

  def put_recently(self, key):
    # 把节点更新到链表尾部
    node = self.cache[key]
    self.linked_list.delete(node)
    self.linked_list.append(node)

  def put(self, key, value):
    # 能查到的话先删除原数据再更新
    if key in self.cache:
      self.linked_list.delete(self.cache[key])
      self.cache[key] = Node(key, value)
      self.linked_list.append(self.cache[key])
      return

    if len(self.cache) >= self.cap:
      # 如果容量已经满了,删除最旧的节点
      node = self.linked_list.get_head()
      self.linked_list.delete(node)
      del self.cache[node.key]

    u = Node(key, value)
    self.linked_list.append(u)
    self.cache[key] = u
在此种实现中,除dict外未使用任何其他工具,连LinkedList也是自行实现的。实际上,Python语言中有一个名为OrderedDict的数据结构,它是一种有序字典,其中的元素保持插入顺序。利用OrderedDict实现LRU非常简单,代码量也大幅减少。
我们来看代码:
class LRU(OrderedDict):

  def __init__(self, cap=128, /, *args, **kwds):
    self.cap = cap
    super().__init__(*args, **kwds)

  def __getitem__(self, key):
    # 查询函数
    value = super().__getitem__(key)
    # 把节点移动到末尾
    self.move_to_end(key)
    return value

  def __setitem__(self, key, value):
    # 更新函数
    super().__setitem__(key, value)
    if len(self) > self.cap:
      oldest = next(iter(self))
      del self[oldest]
在上述实现中,由于仅使用了一个数据结构,代码更为简洁,使用也更方便,可直接像dict一样通过方括号进行查询和更新。不过,在其他语言中可能没有OrderedDict这种数据结构,这就需要自行编码实现。
好了,今天的文章就到这里。衷心祝愿大家每天都有所收获。如果还喜欢今天的内容,请点赞、关注、转发支持一下~
以上就是工程师必须了解的LRU缓存淘汰算法以及python实现过程的详细内容,更多关于LRU缓存淘汰算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















