


Python爬取搜狐证券上证50股票代码教程

本文详解如何使用Python的requests和BeautifulSoup库,从搜狐证券网站抓取上证50成分股的股票代码。教程涵盖网页请求、编码处理(gb2312)、HTML表格解析及数据清洗,并将结果保存为pickle格式以便后续高效调用,适合金融数据抓取初学者参考。
数据抓取流程概述
数据抓取流程概述
获取上证50股票代码
以获取上证50指数的成分股为例,首要步骤是定位包含这五十只股票列表的网页。本例选用搜狐证券提供的公开列表作为数据源。
目标网址为:https://q.stock.sohu.com/cn/bk_4272.shtml
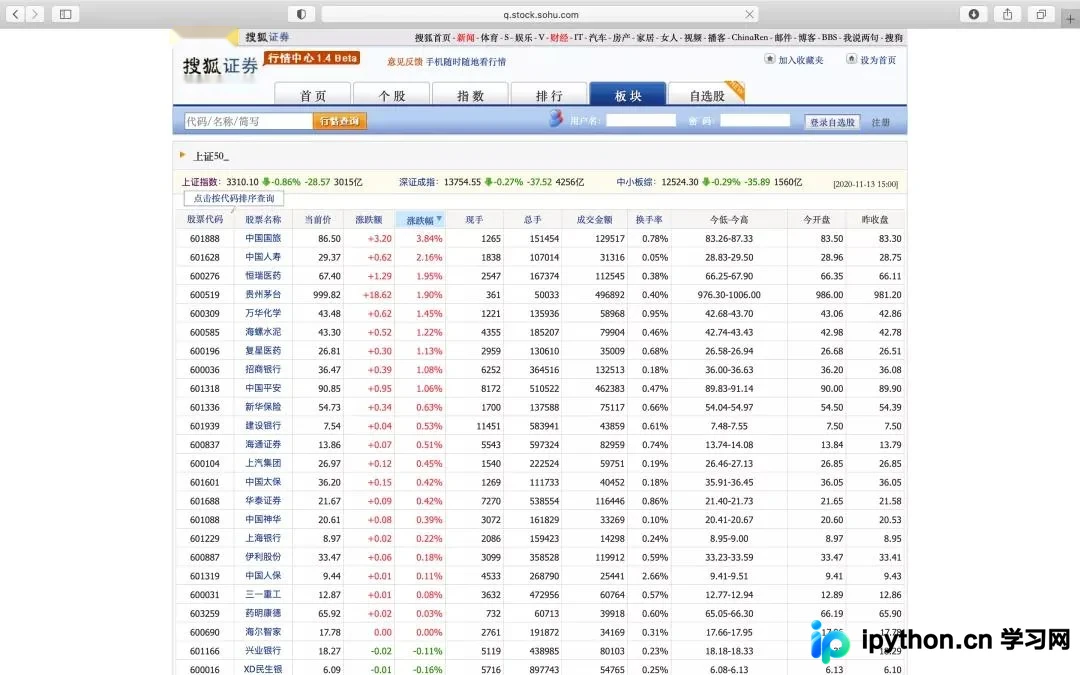
访问该网页可见上证50的所有股票代码,我们的目标是抓取包含这些代码的表格,并提取表格的第一列数据。
在Python中,我们通常使用Beautiful Soup库来抓取网页数据。需注意,该工具主要适用于抓取静态网页中的信息。
简而言之,Beautiful Soup是Python中用于从网页提取数据的核心库。
使用前,需先导入bs4库。此外,还需使用requests库获取网页内容,因此需要导入这两个库:
import bs4 as bs
import requests
定义函数saveSS50Tickers()以获取上证50的股票代码。该函数通过调用get()方法从搜狐证券的静态网页获取数据。
def saveSS50Tickers(): resp = requests.get('https://q.stock.sohu.com/cn/bk_4272.shtml')
接下来,打开搜狐证券的指定网址。在页面任意位置右键点击,选择“查看元素”(Inspect Element)或类似选项,以查看当前网站的源代码。
我们需要在源代码中识别网页的基本信息及待抓取数据的特征。
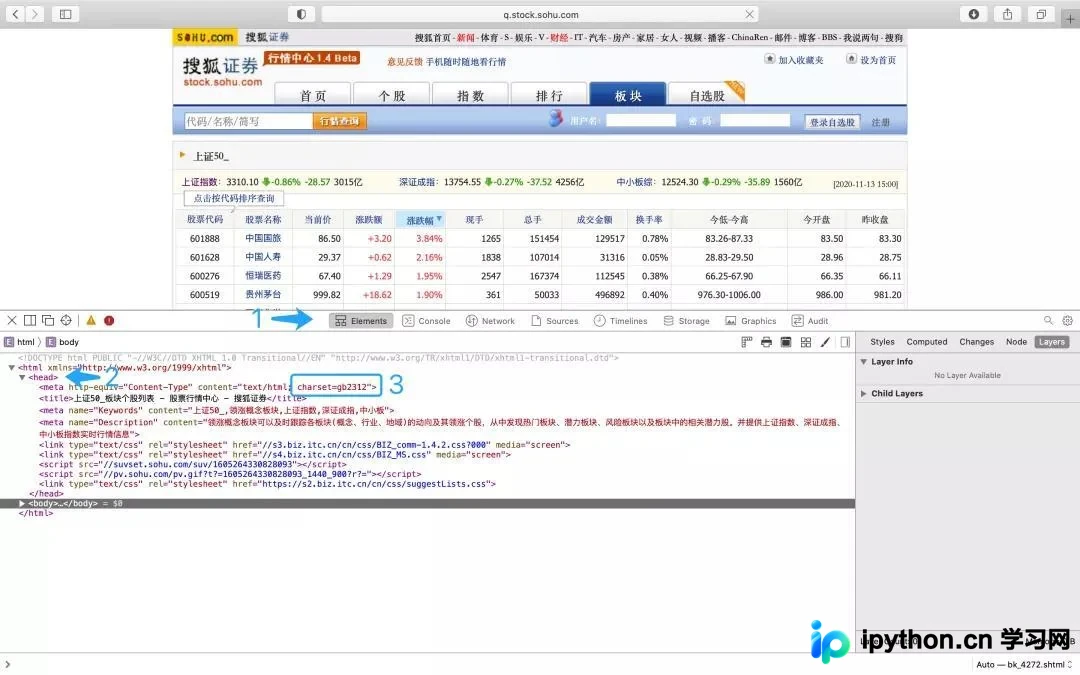
首先定位Element,在下方内容中找到网页的头文件(head),并确认网页文字的编码方式。此处网页编码为gb2312。
若需正确爬取并显示该网页内容,必须先对获取的网页内容进行解码处理。
可使用encoding属性进行解码设置:
resp.encoding = 'gb2312'
随后,利用Beautiful Soup结合lxml解析器对网页信息进行解析:
soup = bs.BeautifulSoup(resp.text, 'lxml')
为便于后续处理,首先通过resp.text将网页信息转换为文本格式,再进行数据解析。
接下来需在网页源码中定位包含目标信息的标签。由于需抓取表格数据,可通过源码搜索功能查找表格相关数据,从而定位表格源码。
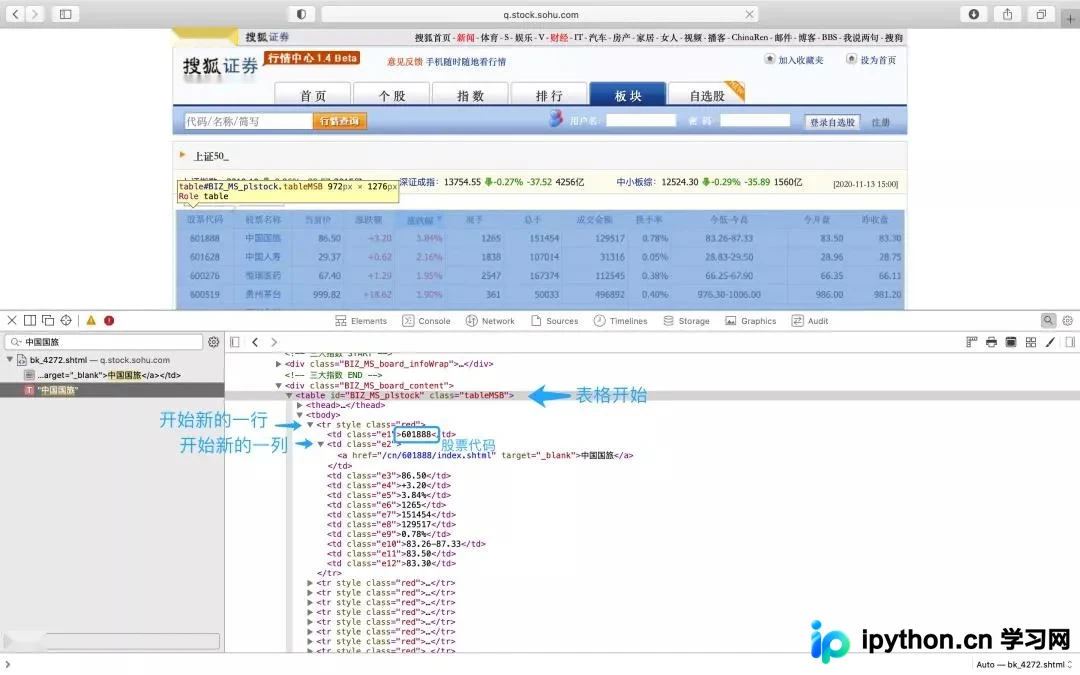
以该页面为例,网页通常由HTML语言编译。为准确定位,需了解HTML基础。在该页面源码中,
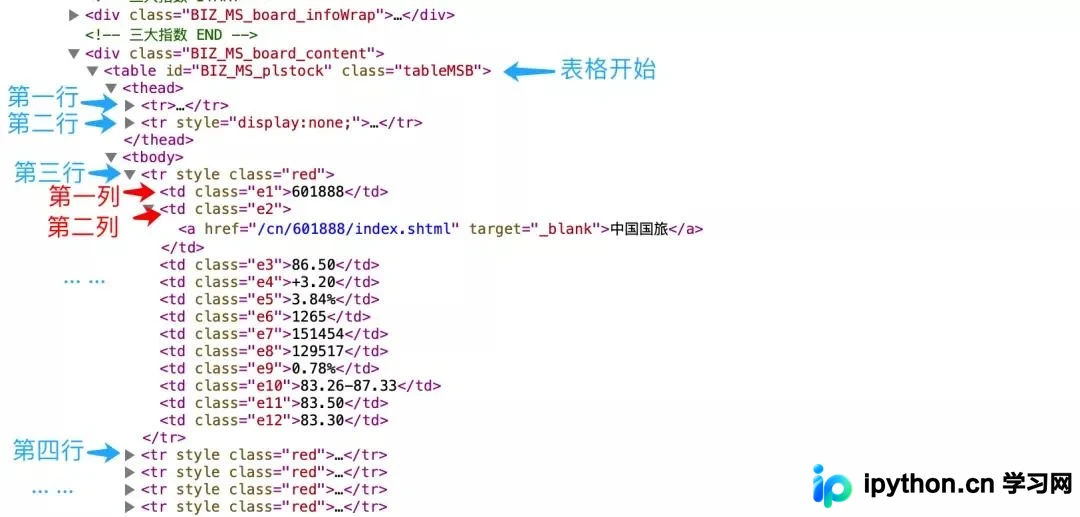
<table>标签表示表格开始,后跟表格属性;</table>表示表格结束。
首先,使用soup.find方法在网页信息中定位表格标签入口:
table = soup.find('table', {'id': 'BIZ_MS_plstock'})
其中'table'指定查找表格,{'id':'BIZ_MS_plstock'}则通过内容或属性进一步定位表格。
确定表格位置后,继续查找所需数据。以该页面为例:
在网页开发语言中,
<tr>表示表格中新的一行开始,<td>表示该行中新的一列开始,</td>表示该列结束,对应的</tr>表示该行结束。
通过分析该网页源码,我们发现:
表格的第一行和第二行为表头信息,从第三行开始包含五十家公司的股票信息。每家公司的股票代码位于表格的第一列。
因此,在Python中需从表格第三行开始抓取,每行提取第一列数据,并将结果转换为文本格式。使用列表tickers存储抓取到的数据:
tickers = [] for row in table.findAll('tr')[2:]: ticker = row.findAll('td')[0].text tickers.append(ticker + '.SS')
为方便后续数据处理,在存储上证50每家公司的股票代码时,均在代码后追加'.SS'字符。运行当前代码并输出列表tickers:
# 导入 beautiful soup4 包,用于抓取网页信息
import bs4 as bs
# 导入 pickle 用于序列化对象
import pickle
# 导入 request 用于获取网站上的源码
import requests

def saveSS50Tickers():
  resp = requests.get('https://q.stock.sohu.com/cn/bk_4272.shtml')
  resp.encoding = 'gb2312'
  soup = bs.BeautifulSoup(resp.text, 'lxml')
  # print(soup)

  table = soup.find('table', {'id': 'BIZ_MS_plstock'})
  # print(table)
  tickers = []
  # print(table.find_all('tr'))
  for row in table.findAll('tr')[2:]:
    # print(row)
    ticker = row.findAll('td')[0].text
    tickers.append(ticker + '.SS')
  return tickers

tickers = saveSS50Tickers()
print(tickers)
观察到的输出信息如下:
['600036.SS', '601229.SS', '600031.SS', '601166.SS', '600104.SS', '600030.SS', '603259.SS', '601668.SS', '601628.SS', '601766.SS', '601857.SS', '601398.SS', '601390.SS', '600029.SS', '600028.SS', '601818.SS', '601211.SS', '601066.SS', '601111.SS', '600837.SS', '600887.SS', '601888.SS', '600690.SS', '600519.SS', '600016.SS', '601989.SS', '601988.SS', '601601.SS', '600019.SS', '601186.SS', '600703.SS', '600196.SS', '601318.SS', '601800.SS', '600050.SS', '601319.SS', '601288.SS', '601688.SS', '603993.SS', '600309.SS', '600048.SS', '600276.SS', '601138.SS', '601336.SS', '601088.SS', '600585.SS', '600000.SS', '601328.SS', '601939.SS', '600340.SS']
至此,已从搜狐证券网站成功爬取上证50的公司股票代码,并以字符串格式存储在列表变量中。
本地存储策略
将股票代码保存至本地文件
股票代码等数据在短期内变动较小,无需每次使用时重新爬取。一种便捷做法是将股票代码信息以文件格式保存至本地,使用时直接读取即可。
此处将股票代码数据保存为pickle格式。pickle格式数据在Python中存取高效,但在导出前需导入相应的pickle库:
import pickle
pickle可保存任何数据格式,在频繁存取场景(如保存和恢复状态)下读取更为高效。
将文件导出为pickle格式的方法为pickle.dump,需结合文件读写操作:
with open('SS50tickers.pickle', 'wb') as f: pickle.dump(tickers, f)
其中'SS50tickers.pickle'为保存的文件名,'wb'表示以写入二进制模式打开文件。pickle.dump(tickers, f)表示将列表tickers写入文件。
以上为本文全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















