


Python反爬虫策略深度解析:User-Agent与IP代理的优劣对比

本文深入分析Python爬虫中两种主流反反爬策略:User-Agent伪装与IP代理池。通过对比两者在技术实现、成本及稳定性上的差异,指出UA易被伪造但成本低,而代理池虽能绕过IP限制却面临质量参差不齐的挑战。文章旨在帮助开发者根据实际场景选择最优方案,平衡抓取效率与合规性。
反爬虫策略选择的核心考量
在制定解决方案时,我们不仅需关注预期效果,更需权衡方案本身的优缺点,并通过横向对比确定最优解。此前曾介绍过Python应对反爬虫的技术手段,许多读者可能仍困惑于具体场景下的选择。本文将重点剖析User-Agent伪装与IP代理两种常见策略的优劣,帮助开发者清晰辨析差异,从而做出更精准的技术选型。
User-Agent伪装策略分析
策略一:User-Agent伪装
实现方式相对简单,开发者可直接指定特定的User-Agent字符串;更优的做法是从预设的User-Agent列表中随机选取符合规范的值进行请求,以模拟不同浏览器的行为。
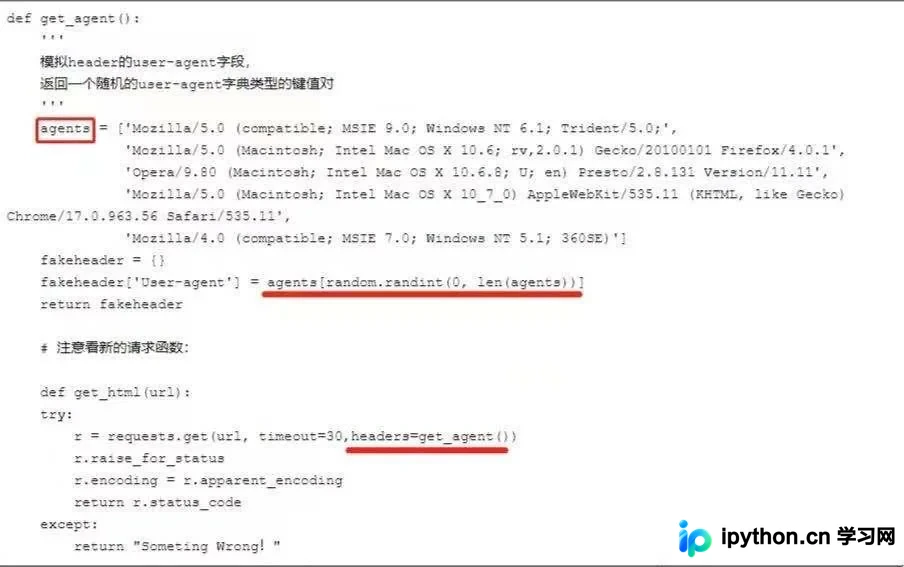 局限性分析:
该方法的头部伪造门槛较低,GitHub上已有大量开源库(如fake-useragent)可供直接使用,降低了实施难度,但也因此容易被高级反爬机制识别。
策略二:IP限制与规避
若固定IP在短时间内高频访问目标网站,服务器管理员可启用IP限制机制,直接阻断该IP的后续访问请求。
IP代理池方案与局限
策略二:IP代理池方案
目前较为成熟的解决方案是构建IP代理池。
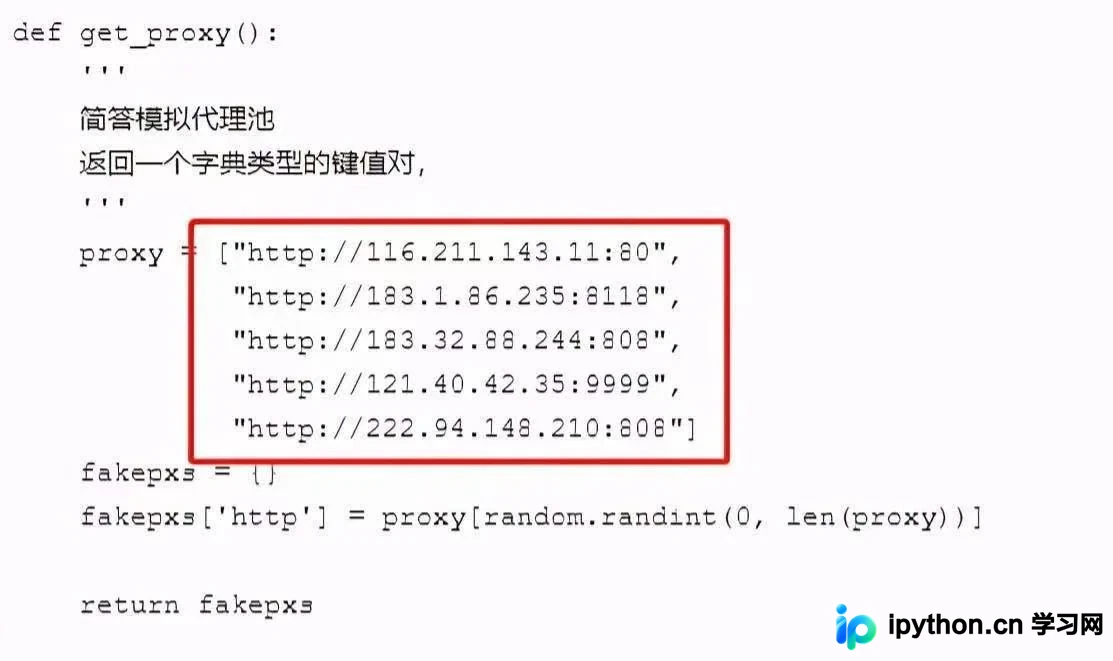
其核心逻辑是通过代理服务器转发请求,利用不同的出口IP进行访问,从而避免因单一IP高频访问而被封禁。
然而,获取稳定可靠的代理IP本身存在较高门槛。市面上虽有免费和付费代理可选,但服务质量参差不齐。对于企业级应用,通常建议通过购买云服务器集群自建代理池,以确保持续性和稳定性。
局限性分析:
尽管可以使用免费或付费代理来绕过基础检测,但代理资源的获取成本和维护复杂度较高,且存在连接不稳定或泄露风险。
策略总结与应用建议
通过上述分析可见,每种反爬策略均存在固有缺陷,关键在于如何最大化利用其优势。开发者应根据具体的业务环境、技术能力及成本预算,选择最适配的操作方案。若对前述知识点存在遗忘,建议回顾相关技术文档以巩固理解。
至此,关于Python反爬虫策略中User-Agent与IP代理的优缺点对比分析已介绍完毕。如需了解更多相关技术细节,欢迎查阅本站往期文章或继续浏览后续内容。感谢大家的支持与关注!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















