


Python使用xlrd合并Excel多行数据并写入新表

发布时间:2026-10-14 |
4人浏览过
本文介绍如何使用Python的xlrd库将Excel中的多行FAQ记录合并为一行。通过遍历工作簿,利用字典暂存相似句,以'||'拼接后写入新表格。代码包含读取源文件、处理分类标签及生成结果文件的完整流程,适用于批量数据整理场景。
Excel多行合并概述与目标
一、概述 现有名为wenda1.xlsx的文件,其原始内容结构如下:
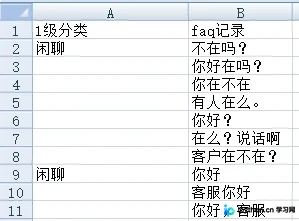
目标是将分散的多条FAQ记录合并至单行显示,预期处理效果如下:
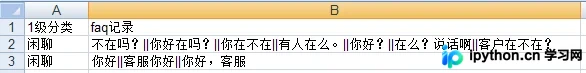
需要注意的是,合并后的FAQ记录之间需使用'||'符号进行拼接分隔。
Python读取与合并逻辑实现
二、多行转换一行 新建脚本文件test1.py,具体实现代码如下:
# !/usr/bin/python3
# -*- coding: utf-8 -*-
import xlrd

# 打开excel文件,创建一个workbook对象
rbook = xlrd.open_workbook('wenda1.xlsx')
# sheets方法返回对象列表,[<xlrd.sheet.Sheet object at 0x103f147f0>]
rbook.sheets()
# xls默认有3个工作簿,Sheet1,Sheet2,Sheet3
rsheet = rbook.sheet_by_index(0) # 取第一个工作簿

faq_tmp_dict = {} # FAQ临时字典
faq_formal_list = [] # FAQ正式列表
first_category_tag = "" # 一级分类标识
index = 0 # 索引

#循环工作簿的所有行
for row in rsheet.get_rows():
  index +=1

  first_category_row = row[0] # 1级分类所在的列
  first_category_value = first_category_row.value # 1级分类的值
  if first_category_value != '1级分类': # 排除第一行,这些都是列名
    if first_category_value: # 当1级分类的值不为空时
      # 更新一级分类标识,用#连接
      first_category_tag = "%s#%s"%(first_category_value,index)
      faq_like_column = row[1] # FAQ相似句所在的列
      faq_like_value = faq_like_column.value # FAQ相似句的值
      # 更新临时字典,不存在默认值为空字典,否则追加到列表中
      faq_tmp_dict.setdefault(first_category_tag, []).append(faq_like_value)
    else:
      # 当1级分类的值为空时
      faq_like_column = row[1] # FAQ相似句所在的列
      faq_like_value = faq_like_column.value
      faq_tmp_dict.setdefault(first_category_tag, []).append(faq_like_value)


print(faq_tmp_dict)
# 处理临时字典
for i in faq_tmp_dict:
  tmp_dict = {}
  # 一级分类,切割#号,取第一个
  first_category = i.split('#')[0]
  # print("first_category",first_category)
  # faq所有记录,将faq列表转换为一行,用逗号拼接
  faq_like_all = "||".join(faq_tmp_dict[i])
  # print("faq_merge",faq_all)
  tmp_dict['first_category'] = first_category
  tmp_dict['faq_like_all'] = faq_like_all
  faq_formal_list.append(tmp_dict)

print(faq_formal_list)
运行上述代码后的控制台输出结果:
{'闲聊#2': ['不在吗?', '你好在吗?', '你在不在', '有人在么。', '你好?', '在么?说话啊', '客户在不在?'], '闲聊#9': ['你好', '客服你好', '你好,客服']}
[{'first_category': '闲聊', 'faq_like_all': '不在吗?||你好在吗?||你在不在||有人在么。||你好?||在么?说话啊||客户在不在?'}, {'first_category': '闲聊', 'faq_like_all': '你好||客服你好||你好,客服'}]
观察输出内容可知,程序已成功将多行数据合并为单行,并将FAQ记录整理至字典结构中。随后即可将这些处理后的数据写入新的Excel表格中。
写入新Excel表格完整代码
三、写入新表格 完整的处理代码如下:
# !/usr/bin/python3
# -*- coding: utf-8 -*-
import xlrd

# 打开excel文件,创建一个workbook对象
rbook = xlrd.open_workbook('wenda1.xlsx')
# sheets方法返回对象列表,[<xlrd.sheet.Sheet object at 0x103f147f0>]
rbook.sheets()
# xls默认有3个工作簿,Sheet1,Sheet2,Sheet3
rsheet = rbook.sheet_by_index(0) # 取第一个工作簿

faq_tmp_dict = {} # FAQ临时字典
faq_formal_list = [] # FAQ正式列表
first_category_tag = "" # 一级分类标识
index = 0 # 索引

#循环工作簿的所有行
for row in rsheet.get_rows():
  index +=1

  first_category_row = row[0] # 1级分类所在的列
  first_category_value = first_category_row.value # 1级分类的值
  if first_category_value != '1级分类': # 排除第一行,这些都是列名
    if first_category_value: # 当1级分类的值不为空时
      # 更新一级分类标识,用#连接
      first_category_tag = "%s#%s"%(first_category_value,index)
      faq_like_column = row[1] # FAQ相似句所在的列
      faq_like_value = faq_like_column.value # FAQ相似句的值
      # 更新临时字典,不存在默认值为空字典,否则追加到列表中
      faq_tmp_dict.setdefault(first_category_tag, []).append(faq_like_value)
    else:
      # 当1级分类的值为空时
      faq_like_column = row[1] # FAQ相似句所在的列
      faq_like_value = faq_like_column.value
      faq_tmp_dict.setdefault(first_category_tag, []).append(faq_like_value)


print(faq_tmp_dict)
# 处理临时字典
for i in faq_tmp_dict:
  tmp_dict = {}
  # 一级分类,切割#号,取第一个
  first_category = i.split('#')[0]
  # print("first_category",first_category)
  # faq所有记录,将faq列表转换为一行,用逗号拼接
  faq_like_all = "||".join(faq_tmp_dict[i])
  # print("faq_merge",faq_all)
  tmp_dict['first_category'] = first_category
  tmp_dict['faq_like_all'] = faq_like_all
  faq_formal_list.append(tmp_dict)

print(faq_formal_list)

import xlwt
import json
f = xlwt.Workbook()
sheet1 = f.add_sheet('Sheet1', cell_overwrite_ok=True)
row0 = ["1级分类", "faq记录"]

# 写第一行
for i in range(0, len(row0)):
  sheet1.write(0, i, row0[i])

# # 加载json文件
# with open("tj.json", 'r') as load_f:
#   load_dict = json.load(load_f) # 反序列化文件
#
num = 0 # 计数器
max_length = 0 # 最大长度
for i in faq_formal_list:
  num+=1 # 自增1

  faq_col = sheet1.col(1) # faq记录所在的列
  length = len(i['faq_like_all']) # 计算长度
  # print("长度",length)
  # 更新最大长度
  if max_length < length:
    max_length = length

  # 设置表格宽度
  faq_col.width = max_length * 20* 20
  # 写入库名
  sheet1.write(num, 0, i['first_category'])
  # faq_like_str = "||".join(i['faq_like_all'])
  sheet1.write(num, 1, i['faq_like_all'])

# 保存到表格
f.save('test1.xls')
执行该段代码后,系统会自动生成一个名为test1.xlsx的输出文件。
打开生成的文件查看,最终效果如下:
以上即为利用Python实现Excel多行合并的完整方法,如需了解更多相关技术细节,可参考本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















