


Python与Hive UDF实现CSV批量MD5加密及常见陷阱解析

发布时间:2026-10-14 |
4人浏览过
本文介绍使用Python脚本和Hive UDF两种方案对CSV文件中的手机号进行32位MD5批量加密,保障数据安全。重点解析Python中hashlib对象复用导致的连续加密错误陷阱,并提供正确的单次加密实现代码,适用于数据脱敏与安全导出场景。
工作中遇到将一批手机号进行MD5加密并导出的需求。为确保数据安全,未使用在线工具,而是采用本地代码实现加密过程。
MD5加密算法成熟且开源,多数编程语言均提供相应库。本文分别展示Python实现方案及同事开发的Hive UDF方案,供参考。
目标:
读取CSV文件内容,对其中数据进行32位MD5加密,并将生成的密文写入新的CSV文件中。
Python实现:
(1)准备待读取的CSV文件,格式为单列,每行存储一个手机号码。
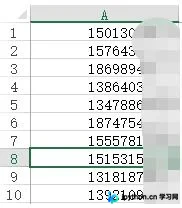
(2)Python代码:
#encoding=utf8
import hashlib #加密模块
import os

#定义一个加密函数,32位md5加密
def md5_encryption(str):
 m=hashlib.md5()
 m.update(str)
 return m.hexdigest()

#准备要读取的csv和要被写入的csv,两个文件要和此python放在同一个文件夹里
readfilename=os.path.join(os.path.dirname(__file__),"testcsv.csv")
writefilename=os.path.join(os.path.dirname(__file__),"writecsv.csv")
print('read:',readfilename)
print('write:',writefilename)

with open(readfilename,'r') as rf:
 #逐行写入加密后的密文,strip函数用于剔除换行符\n,不然是对“13000000\n”加密而不是对“13000000”加密
 with open(writefilename,'w') as wf:
 for row in rf.readlines():
  wf.write(md5_encryption(row.strip()))
  wf.write('\n')
 #计算一下写入的行数
 with open(writefilename,'r') as rwf:
 count=0
 while 1:
  buffer=rwf.read(1024*8192)
  if not buffer:
  break
  count+=buffer.count('\n')
 print('line writed number:',count)
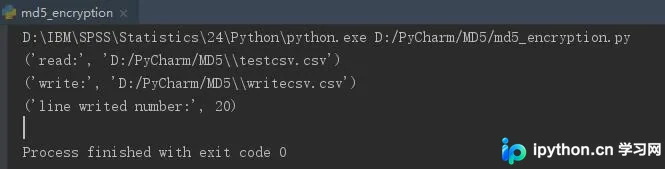
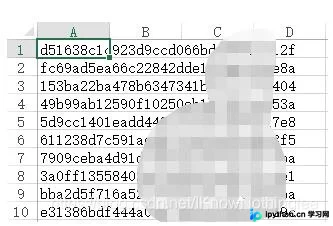
(3)运行结果
Hive UDF实现:
(1)使用Java编写加密类,并通过Maven打包为JAR文件。
import org.apache.hadoop.hive.ql.exec.UDF;
import org.apache.commons.lang.StringUtils;
import java.security.MessageDigest;
public class MD5 extends UDF {
 public String evaluate (final String str) {
 if (StringUtils.isBlank(str)){
  return "";
 }
 String digest = null;
 StringBuffer buffer = new StringBuffer();
 try {
  MessageDigest digester = MessageDigest.getInstance("md5");
  byte[] digestArray = digester.digest(str.getBytes("UTF-8"));
  for (int i = 0; i < digestArray.length; i++) {
  buffer.append(String.format("%02x", digestArray[i]));
  }
  digest = buffer.toString();
 } catch (Exception e) {
  e.printStackTrace();
 }
 return digest;
 }
 public static void main (String[] args ) {
 MD5 md5 = new MD5();
 System.out.println(md5.evaluate(" "));
 }
}
(2)配置pom.xml依赖文件。
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
  xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
  xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
 <modelVersion>4.0.0</modelVersion>

 <groupId>HiveUdf</groupId>
 <artifactId>HiveUdf</artifactId>
 <version>1.0-SNAPSHOT</version>

 <dependencies>
 <dependency>
  <groupId>org.apache.hive</groupId>
  <artifactId>hive-exec</artifactId>
  <version>0.14.0</version>
 </dependency>
 <dependency>
  <groupId>org.apache.calcite</groupId>
  <artifactId>calcite-core</artifactId>
  <version>0.9.2-incubating</version>
 </dependency>
 <dependency>
  <groupId>org.apache.calcite</groupId>
  <artifactId>calcite-avatica</artifactId>
  <version>0.9.2-incubating</version>
 </dependency>
 <dependency>
  <groupId>org.apache.hadoop</groupId>
  <artifactId>hadoop-common</artifactId>
  <version>2.6.0</version>
 </dependency>
 </dependencies>
</project>
(3)在Hive中配置UDF。
导入JAR包:
hive> add jar hdfs:/user/udf/HiveUdf-1.0-SNAPSHOT.jar;新建函数:
hive> create temporary function MD5 as 'MD5';
使用示例:
hive> select MD5('12345');
OK
827ccb0eea8a706c4c34a16891f84e7b
Time taken: 0.139 seconds, Fetched: 1 row(s)
hive>
hive> select phone,MD5(phone) from mid_latong_20200414 limit 5;
OK
1300****436 856299f44928e90****181b0cc1758c4
1300****436 856299f44928e90****181b0cc1758c4
1300****689 771dfa9ef00f43c****4901a3f1d1fa0
1300****689 771dfa9ef00f43c****4901a3f1d1fa0
1300****689 771dfa9ef00f43c****4901a3f1d1fa0
Time taken: 0.099 seconds, Fetched: 5 row(s)
以上为Python和Hive UDF两种实现MD5加密的方法。
补充:Python MD5加密的常见陷阱
曾在CTF题目中因此问题耗时良久。
直接切入正题。
Python MD5加密方法
import hashlib   //导入hash库函数
text = "bolg.csdn.net"   //要加密的文本
md5_object = hashlib.md5()   //创建一个MD5对象
md5_object.update(text)   //添加去要加密的文本
print md5_object.hexdigest()  //输出加密后的MD5值
陷阱所在:
首次加密时程序输出正常MD5值,但若在同一程序中连续对明文进行加密,且代码写法不当,将无法获得正确的MD5值。
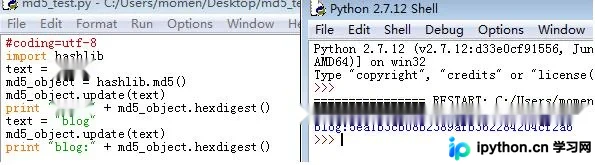
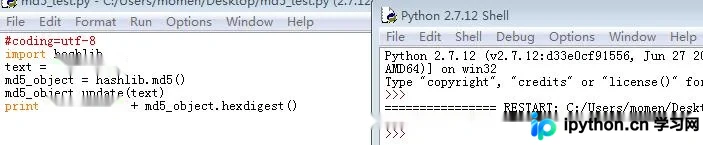
对比图片可知,若按错误代码连续加密,实际是对每次明文累加后的字符串进行加密。
即第一次加密:csdn
第二次加密:csdnblog
正确做法应为:
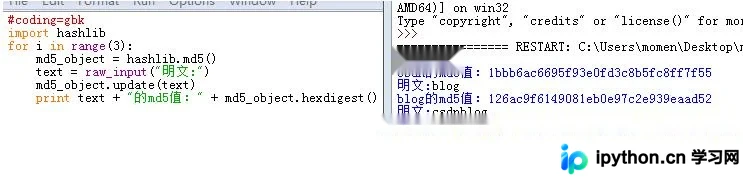
以上为个人经验总结,旨在提供参考。如有疏漏,欢迎指正。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















