


Python实现简易模板引擎:从思路到代码详解

本文详解如何使用Python从零实现一个支持变量替换、IF判断和FOR循环的简易模板引擎。通过正则表达式提取HTML与渲染语句,利用CodeBuilder类动态生成Python代码,并结合exec执行逻辑。文章深入解析了字符串拼接优化、缩进管理及变量提取机制,提供完整代码实现思路与关键类定义,帮助开发者理解模板引擎底层原理。
一、实现思路
本文将介绍如何使用Python构建一个简易模板引擎,该引擎支持传入变量、执行IF条件判断以及FOR循环语句,最终实现如下渲染效果:
渲染前的文本:
<h1>{{title}}</h1>
<p>十以内的奇数:</p>
<ul>
{% for i in range(10) %}
  {% if i%2==1 %}
    <li>{{i}}</li>
  {% end %}
{% end %}
</ul>


渲染后的文本,假设title="高等数学":
<h1>高等数学</h1>
<p>十以内的奇数:</p>
<ul>
<li>1</li>
<li>3</li>
<li>5</li>
<li>7</li>
<li>9</li>
</ul>
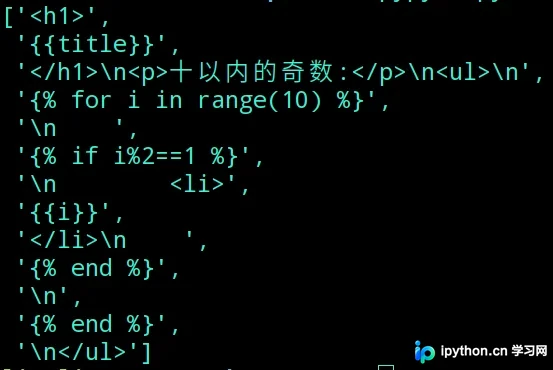
要实现上述效果,首要步骤是将文本中的HTML静态代码与类似{% xxx %}的动态渲染语句分离。可以使用以下正则表达式完成这一提取工作:
re.split(r'(?s)({{.*?}}|{%.*?%}|{#.*?#})', html)使用该正则表达式处理前述文本后,得到的结果如下:
完成文本提取后,接下来需要执行内部的逻辑处理。Python内置的exec函数可以执行字符串格式的代码:
exec('print("hello world")') # 这条语句会输出hello world因此,在提取到HTML中的渲染语句后,可以将其转换为Python代码格式,随后使用exec函数运行。然而,exec函数无法直接返回代码的执行结果,它仅返回None。尽管如此,我们可以通过以下方式获取字符串代码中的变量:
global_namespace = {}
code = """
a = 1

def func():
  pass
"""
exec(code, global_namespace)
print(global_namespace) # {'a': 1, 'func': <function func at 0x00007fc61e3462a0>, '__builtins__': <module 'builtins' (built-in)>}
因此,我们只需在code字符串中定义一个函数,使其能够返回渲染后的模板内容,然后利用前述方法将该函数从字符串中提取出来并执行,即可得到最终结果。
基于上述思路,我们最终需要将HTML文本转化为如下形式的字符串:
# 这个函数不是我们写的, 是待渲染的html字符串转化过来的
def render(context: dict) -> str:
  result = []
  # 这一部分负责提取所有动态变量的值
  title = context['title']
  # 对于所有的html代码或者是变量, 直接放入result列表中
  result.extend(['<h1>', str(title), '</h1>\n<p>十以内的奇数:</p>\n<ul>\n'])
  # 对于模板中的for和if循环语句,则是转化为原生的python语句
  for i in range(10):
    if i % 2 == 1:
      result.extend(['\n    <li>', str(i), '</li>\n  '])
  result.append('\n</ul>')
  # 最后,让函数将result列表联结为字符串返回就行, 这样就得到了渲染好的html文本
  return ''.join(result)
如何将HTML文本转化为上述代码,是本文的核心内容。上述代码由最初的HTML示例转化而来,每一部分均已添加注释。若未理解,建议反复阅读,否则后续内容难以掌握。
总体而言,渲染模板的思路如下:
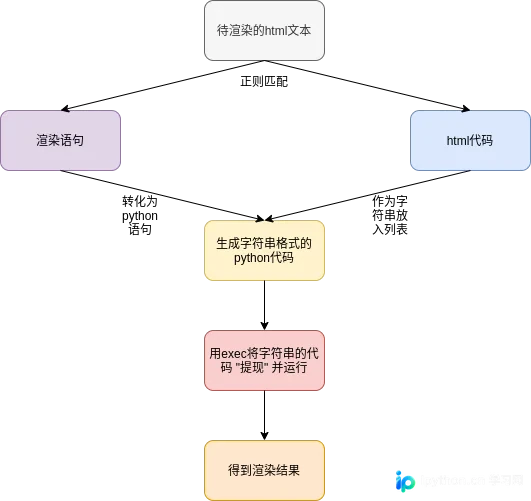
二、字符串代码处理
为了便捷地生成Python代码,我们首先定义一个CodeBuilder类:
class CodeBuilder:
  INDENT_STEP = 4

  def __init__(self, indent_level: int = 0) -> None:
    self.indent_level = indent_level
    self.code = []
    self.global_namespace = None

  def start_func(self) -> None:
    self.add_line('def render(context: dict) -> str:')
    self.indent()
    self.add_line('result = []')
    self.add_line('append_result = result.append')
    self.add_line('extend_result = result.extend')
    self.add_line('to_str = str')

  def end_func(self) -> None:
    self.add_line("return ''.join(result)")
    self.dedent()

  def add_section(self) -> 'CodeBuilder':
    section = CodeBuilder(self.indent_level)
    self.code.append(section)
    return section

  def __str__(self) -> str:
    return ''.join(str(line) for line in self.code)

  def add_line(self, line: str) -> None:
    self.code.extend([' ' * self.indent_level + line + '\n'])

  def indent(self) -> None:
    self.indent_level += self.INDENT_STEP

  def dedent(self) -> None:
    self.indent_level -= self.INDENT_STEP

  def get_globals(self) -> dict:
    if self.global_namespace is None:
      self.global_namespace = {}
      python_source = str(self)
      exec(python_source, self.global_namespace)
    return self.global_namespace
该类作为字符串代码的容器,本质上是对字符串代码的封装,在字符串基础上增加了以下功能:
代码缩进 CodeBuilder维护了一个indent_level变量。当调用其add_line方法写入新代码时,它会自动在代码开头添加缩进。此外,调用indent和dedent方法可方便地增加或减少缩进层级。
生成函数 由于定义此类的目的即在字符串中编写一个函数,而该函数的开头和结尾是固定的,因此将其直接写入对象的方法中。值得一提的是,在start_func方法中,我们编写了以下三行代码:
append_result = result.append
extend_result = result.extend
to_str = str
此举旨在提高渲染模板的性能。调用我们自己定义的函数,所需时间比调用result.append或str等函数的时间更少。首先,对于列表的append和extend两个方法而言,每次调用时,Python都需要在列表的所有方法中查找一次;而直接将其绑定到我们自定义的变量上,即可避免Python重复去列表的方法中查找。其次是str函数,理论上,Python查找局部变量的速度比查找内置变量快,因此我们使用一个局部变量to_str,Python找到它的速度便比查找str要快。
上述内容源自网络资料,经实际测试,在Python 3.7环境下,运行append_result所需时间比直接调用result.append减少了约25%,而to_str则未显示明显的优化效果。
代码嵌套 有时我们需要在一块代码中嵌套另一块代码,此时可调用add_section方法。该方法会创建一个新的CodeBuilder对象作为内容插入到原CodeBuilder对象中,这类似于前端开发中div套div的结构。
此方法的优势在于,你可以在一个CodeBuilder对象中预先插入一个CodeBuilder对象而无需立即写入内容,相当于先占据位置。待条件成熟后,再回头写入内容。这增加了字符串代码的可编辑性。
获取变量 调用get_globals方法以获取当前字符串代码内的所有全局变量。
三、Template模板类
在字符串代码容器准备就绪后,我们只需解析HTML文本,并将其转化为Python代码放入该容器中即可。因此,我们定义如下Template类:
class Template:
  html_regex = re.compile(r'(?s)({{.*?}}|{%.*?%}|{#.*?#})')
  valid_name_regex = re.compile(r'[_a-zA-Z][_a-zA-Z0-9]*$')

  def __init__(self, html: str, context: dict = None) -> None:
    self.context = context or {}
    self.code = CodeBuilder()
    self.all_vars = set()
    self.loop_vars = set()
    self.code.start_func()
    vars_code = self.code.add_section()
    buffered = []

    def flush_output() -> None:

      if len(buffered) == 1:
        self.code.add_line(f'append_result({buffered[0]})')
      elif len(buffered) > 1:
        self.code.add_line(f'extend_result([{", ".join(buffered)}])')
      del buffered[:]

    strings = re.split(self.html_regex, html)
    for string in strings:
      if string.startswith('{%'):
        flush_output()
        words = string[2:-2].strip().split()
        ops = words[0]
        if ops == 'if':
          if len(words) != 2:
            self._syntax_error("Don't understand if", string)
          self.code.add_line(f'if {words[1]}:')
          self.code.indent()
        elif ops == 'for':
          if len(words) != 4 or words[2] != 'in':
            self._syntax_error("Don't understand for", string)
          i = words[1]
          iter_obj = words[3]
          # 这里被迭代的对象可以是一个变量,也可以是列表,元组或者range之类的东西,因此使用_variable来检验
          try:
            self._variable(iter_obj, self.all_vars)
          except TemplateSyntaxError:
            pass
          self._variable(i, self.loop_vars)
          self.code.add_line(f'for {i} in {iter_obj}:')
          self.code.indent()
        elif ops == 'end':
          if len(words) != 1:
            self._syntax_error("Don't understand end", string)
          self.code.dedent()
        else:
          self._syntax_error("Don't understand tag", ops)
      elif string.startswith('{{'):
        expr = string[2:-2].strip()
        self._variable(expr, self.all_vars)
        buffered.append(f'to_str({expr})')
      else:
        if string.strip():
          # 这里使用repr把换行符什么的改成/n的形式,不然插到code字符串中会打乱排版
          buffered.append(repr(string))
    flush_output()
    for var_name in self.all_vars - self.loop_vars:
      vars_code.add_line(f'{var_name} = context["{var_name}"]')
    self.code.end_func()

  def _variable(self, name: str, vars_set: set) -> None:
    # 当解析html过程中出现变量,就调用这个函数
    # 一方面检验变量名是否合法,一方面记下变量名
    if not re.match(self.valid_name_regex, name):
      self._syntax_error('Not a valid name', name)
    vars_set.add(name)

  def _syntax_error(self, message: str, thing: str) -> None:
    raise TemplateSyntaxError(f'{message}: {thing}') # 这个Error类直接继承Exception就行

  def render(self, context=None) -> str:
    render_context = dict(self.context)
    if context:
      render_context.update(context)
    return self.code.get_globals()['render'](render_context)
首先,我们实例化了一个CodeBuilder对象作为容器。随后,我们定义了all_vars和loop_vars两个集合,并在CodeBuilder生成的函数开头插入了一个子容器。这样做的目的是,最终生成的函数应在开头添加类似var_name = context['var_name']之类的语句,以提取传入的上下文变量的值。然而,HTML中有哪些需要渲染的变量,是在渲染之后才知晓的,因此先在开头插入一个子容器,并创建all_vars集合,以便在渲染HTML后将这些变量的赋值语句插入进去。loop_vars则负责存放那些由于FOR循环产生的变量,它们无需从上下文中提取。
接着,我们创建一个buffered列表。由于在渲染HTML的过程中,变量和HTML语句无需直接转为Python语句,而应采用类似append_result(xxx)的形式添加到代码中,因此这里使用一个buffered列表储存变量和HTML语句,等到渲染到FOR循环等特殊语句时,再调用flush_output一次性将这些内容全部写入CodeBuilder中。这样做的好处是,最后生成的字符串代码可能会减少几行。
万事俱备后,使用正则表达式分割HTML文本,然后迭代分割结果并处理即可。对于不同类型的字符串,采用以下方式处理:
HTML代码块 只要包含空格和换行符之外的内容,就放入缓冲区,等待统一写入代码。
带{{}}的变量 只要变量合法,就记录变量名,然后以与HTML代码块相同的方式处理。
IF条件判断 & FOR循环 这两者的处理方法相似,首先检查语法是否有误,然后提取参数将其转化为Python语句插入,最后再增加缩进。其中,FOR语句还需记录所使用的变量。
END语句 该语句意味着FOR循环或IF判断结束,因此只需减少CodeBuilder的缩进即可。
在解析完HTML文本后,清空buffered的数据,为字符串代码添加变量提取和函数返回值,至此代码编写完成。
四、总结
最后,实例化Template对象,调用其render方法并传入上下文,即可得到渲染后的模板:
t = Template(html)
result = t.render({'title': '高等数学'})
以上即为使用Python编写模板引擎的详细内容,更多关于Python编写模板引擎的资料,请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















