


Python结合百度语音识别实现实时翻译软件的开发指南

发布时间:2026-10-14 |
5人浏览过
本文详细介绍如何利用Python结合百度语音识别API开发实时翻译软件。内容涵盖PyAudio、SpeechRecognition等核心库的安装配置,百度AI开放平台服务的申请流程,以及完整的源代码实现逻辑。此外,文章还讲解了使用PyInstaller将Python脚本打包为独立可执行软件的具体操作步骤,帮助开发者快速构建本地语音翻译工具。
首先,需要安装开发所需的依赖库。这包括用于音频录制的PyAudio、语音识别的SpeechRecognition、调用百度AI服务的baidu-aip、处理音频文件的Wave,以及用于打包的Wheel和Pyinstaller。
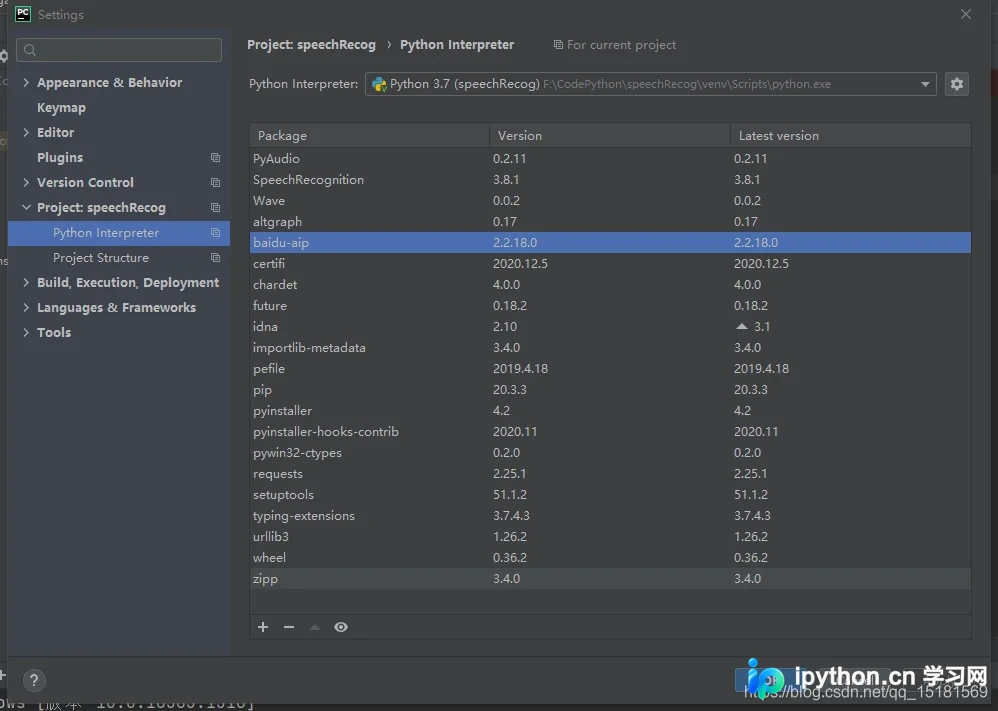
pip install PyAudio
pip install SpeechRecognition
pip install baidu-aip
pip install Wave
pip install Wheel
pip install Pyinstaller
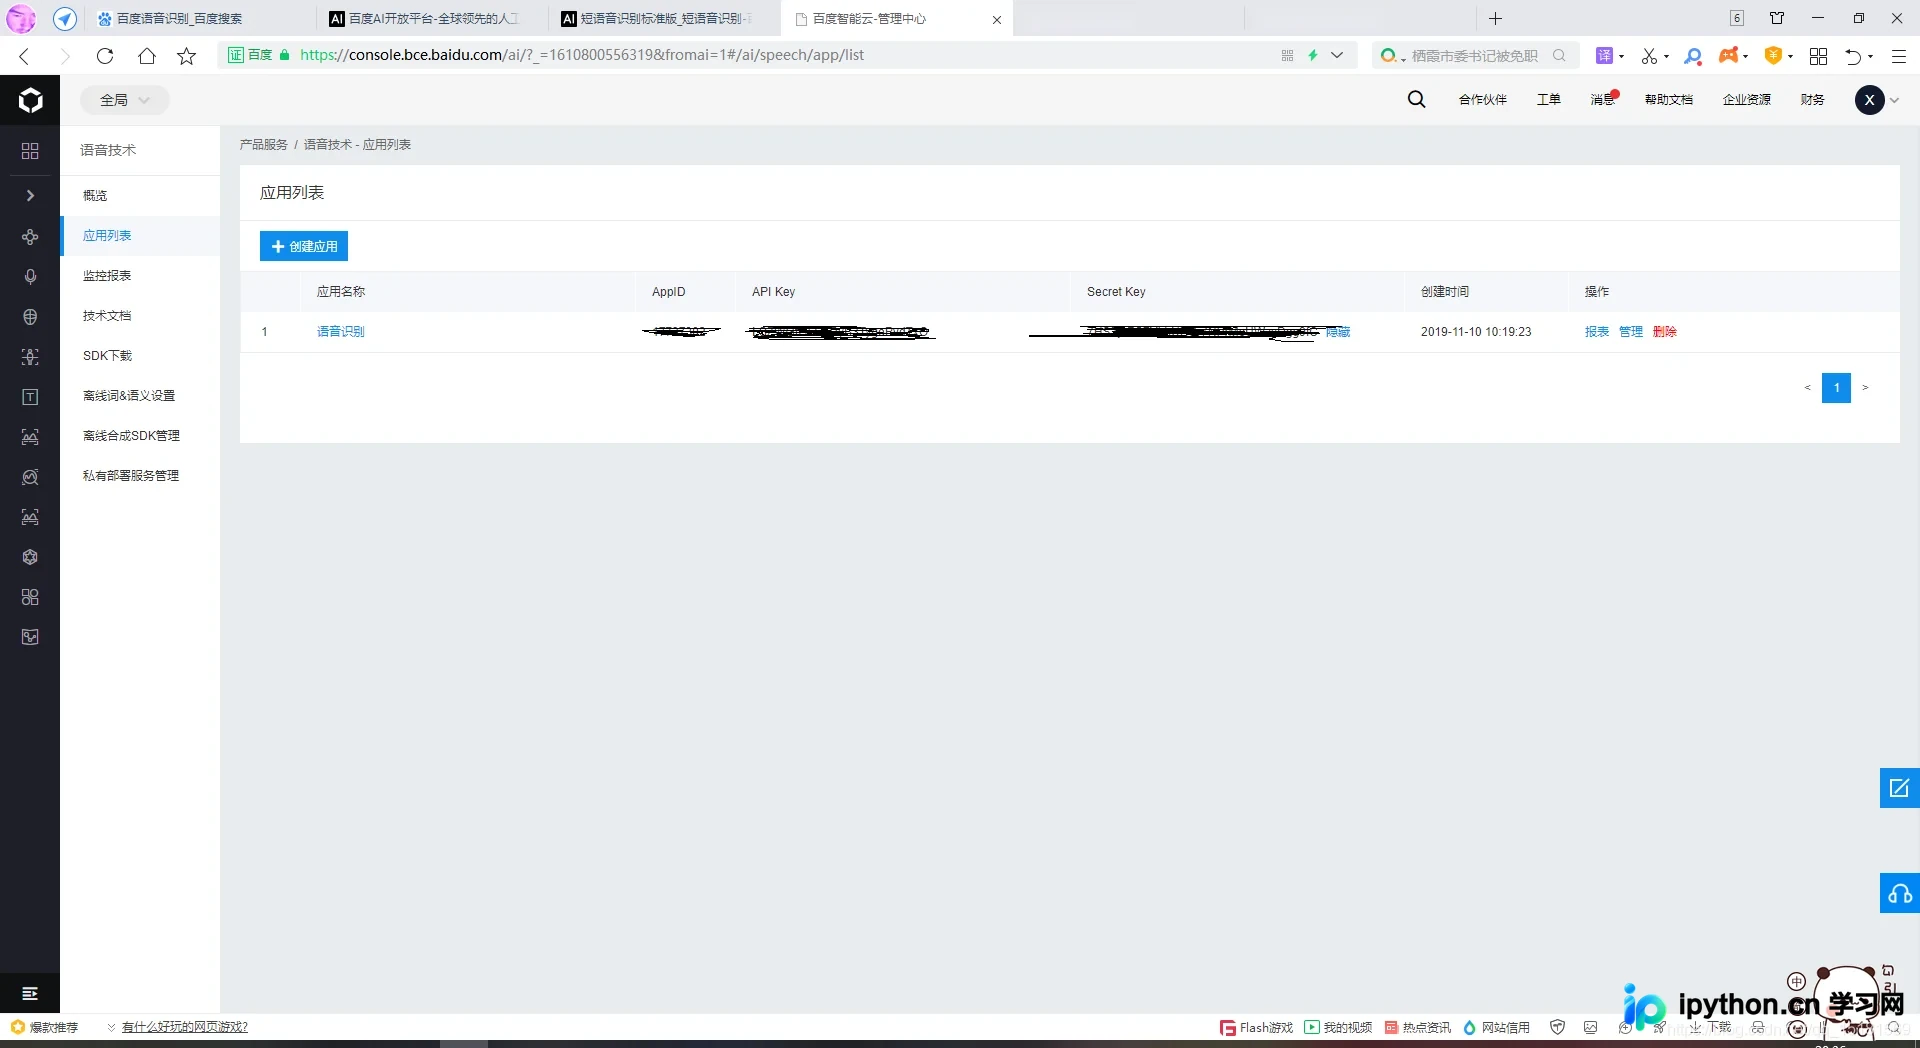
接着,需要在百度智能云官网申请相应的语音识别服务。获取应用对应的APP_ID、API_KEY和SECRET_KEY,这些凭证是后续代码中调用API的必要参数。
以下是实现语音录制与识别的核心代码。程序通过PyAudio库创建音频流,以16000采样率和单声道格式录制指定时长的音频数据,并将其保存为WAV文件。随后,利用百度AipSpeech客户端对生成的音频文件进行识别,返回识别结果。代码中需替换为你自己的百度AI凭证,并在主循环中持续调用录制与识别函数,实现实时处理。
import pyaudio
import wave
from aip import AipSpeech
import time


# 用Pyaudio库录制音频
#  out_file:输出音频文件名
#  rec_time:音频录制时间(秒)
def audio_record(out_file, rec_time):
  CHUNK = 1024
  FORMAT = pyaudio.paInt16 # 16bit编码格式
  CHANNELS = 1 # 单声道
  RATE = 16000 # 16000采样频率

  p = pyaudio.PyAudio()
  # 创建音频流
  stream = p.open(format=FORMAT, # 音频流wav格式
          channels=CHANNELS, # 单声道
          rate=RATE, # 采样率16000
          input=True,
          frames_per_buffer=CHUNK)

  print("开始记录语音{0}秒后开始识别...".format(rec_time))

  frames = [] # 录制的音频流
  # 录制音频数据
  for i in range(0, int(RATE / CHUNK * rec_time)):
    data = stream.read(CHUNK)
    frames.append(data)

  # 录制完成
  stream.stop_stream()
  stream.close()
  p.terminate()

  print("结束识别")

  # 保存音频文件
  wf = wave.open(out_file, 'wb')
  wf.setnchannels(CHANNELS)
  wf.setsampwidth(p.get_sample_size(FORMAT))
  wf.setframerate(RATE)
  wf.writeframes(b''.join(frames))
  wf.close()


def audio_recog(recogFile):
  # 读取文件
  def get_file_content(filePath):
    with open(filePath, 'rb') as fp:
      return fp.read()


  # 识别本地文件
  result = client.asr(get_file_content(recogFile), 'wav', 16000, {'dev_pid': 1537,})
  return result

def write_file(file,text):
  import time
  time = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())
  f = open(file, 'a')
  f.write(time+':'+text+'\n')
  f.close()

audioFile="audio.wav"
textFile="识别结果.txt"

""" 你的 APPID AK SK """
APP_ID = '你的APP_ID'
API_KEY = '你的API_KEY'
SECRET_KEY = '你的SECRET_KEY'

client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)


if __name__ == '__main__':
  while True:
    audio_record(audioFile, 5)
    textResult = audio_recog("audio.wav")
    if textResult['err_msg'] =="success.":
      print(textResult['result'])
      write_file(textFile,str(textResult['result']))
完成代码开发后,需要将Python脚本打包为独立的可执行软件,以便在没有Python环境的设备上运行。
进入项目所在的目录,在命令行中执行打包命令。
pyinstaller -F main.py至此,关于利用Python结合百度语音识别实现实时翻译软件的教程介绍完毕。更多相关技术内容可参考本站往期文章或继续浏览后续章节,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















