


通义千问API长文本处理技巧:突破上下文限制的方法

在处理企业文档分析、长篇法律合同审查或多轮复杂对话时,开发者常面临一个共同难题:输入内容超过了模型单次处理的Token上限。通义千问(Qwen)系列模型虽然提供了较大的上下文窗口,但在极端场景下仍需合理的工程化策略来管理输入长度。本文将像浏览软件界面一样,拆解处理长文本的三个关键“功能区域”,帮助你建立清晰的处理地图。
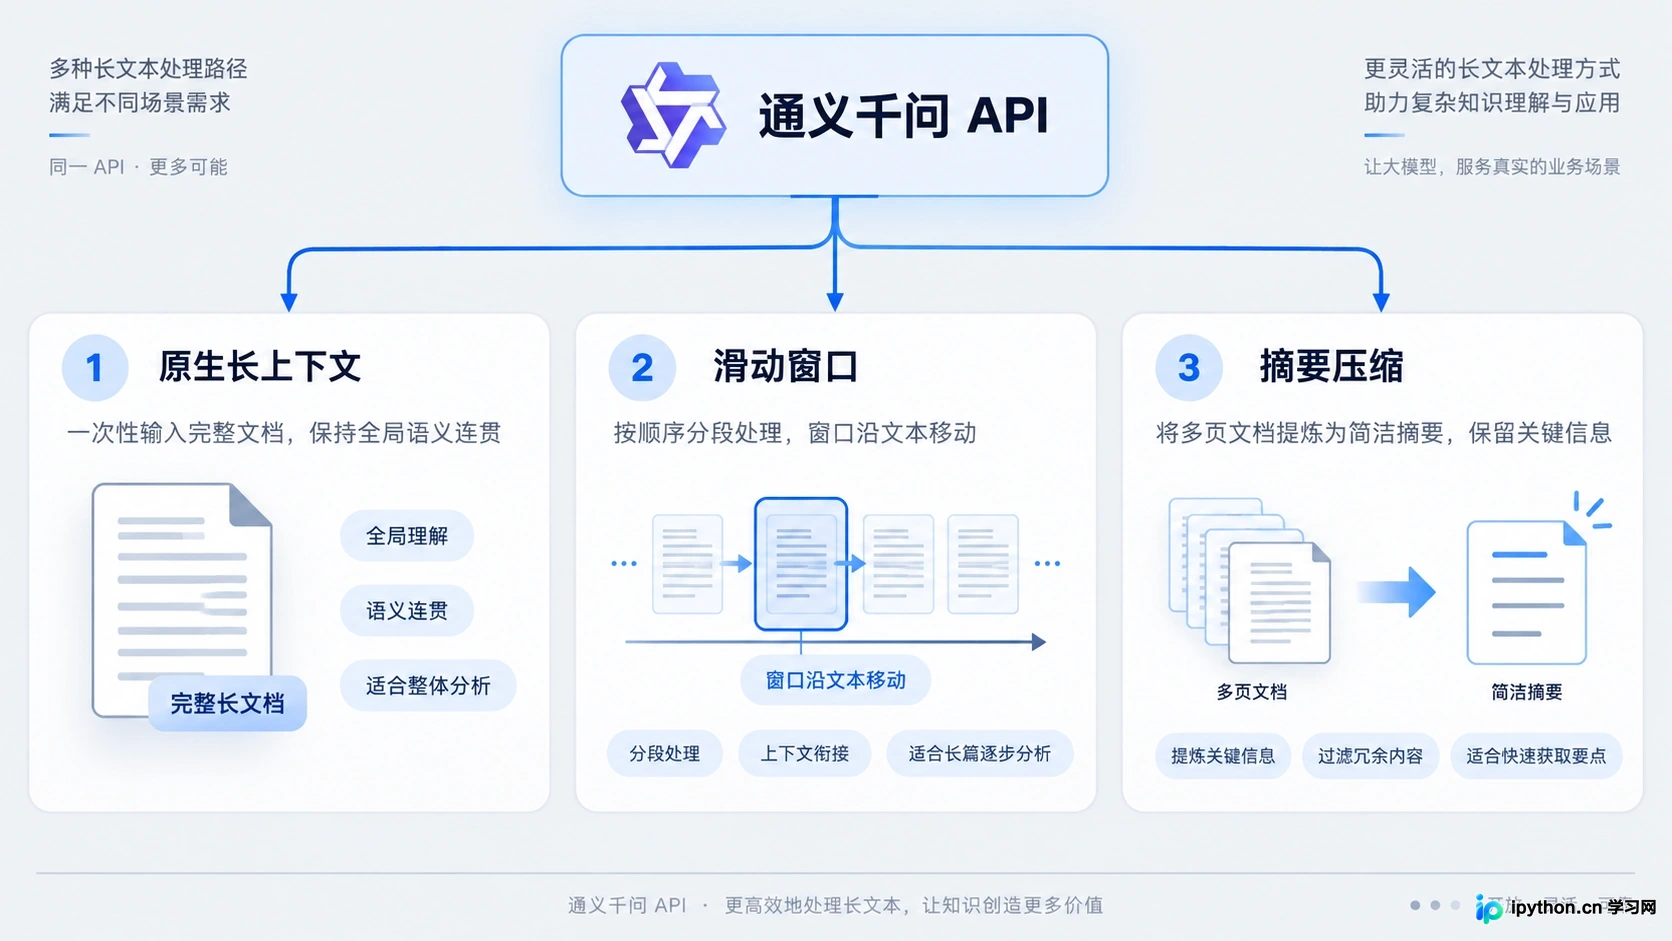
长文本处理的三种核心路径示意图
概述:长文本处理的三大路径
面对长度限制,通常有三条路径可选。首先是“原生支持”,即直接利用模型本身支持的长上下文窗口(如32k、128k或更高),这适用于大多数中长篇文档;其次是“滑动窗口”,通过保留最近的历史记录并丢弃早期内容,适用于实时对话场景;最后是“摘要压缩”,在发送前对非核心信息进行提炼,适用于需要保留全文语义但Token极度敏感的场景。这三者并非互斥,往往需要根据业务需求组合使用。
关于【原生长上下文支持】
通义千问的不同版本模型支持不同的最大上下文长度。例如,Qwen-Long 或特定版本的 Qwen-Max 能够直接处理数十万 Token 的输入。这是最理想的处理方式,因为无需额外的预处理逻辑,模型能直接看到完整信息。
在使用时,你需要确认当前调用的模型实例是否开启了长上下文支持。在 API 调用参数中,通常不需要特殊设置,只需确保输入内容的总 Token 数(包括提示词和预期输出)在模型规定的限额内。如果超出,API 会返回明确的错误码。此方法的优势是信息无损,缺点是成本随 Token 数量线性增加,且极长文本可能导致注意力分散,影响对细节的捕捉精度。
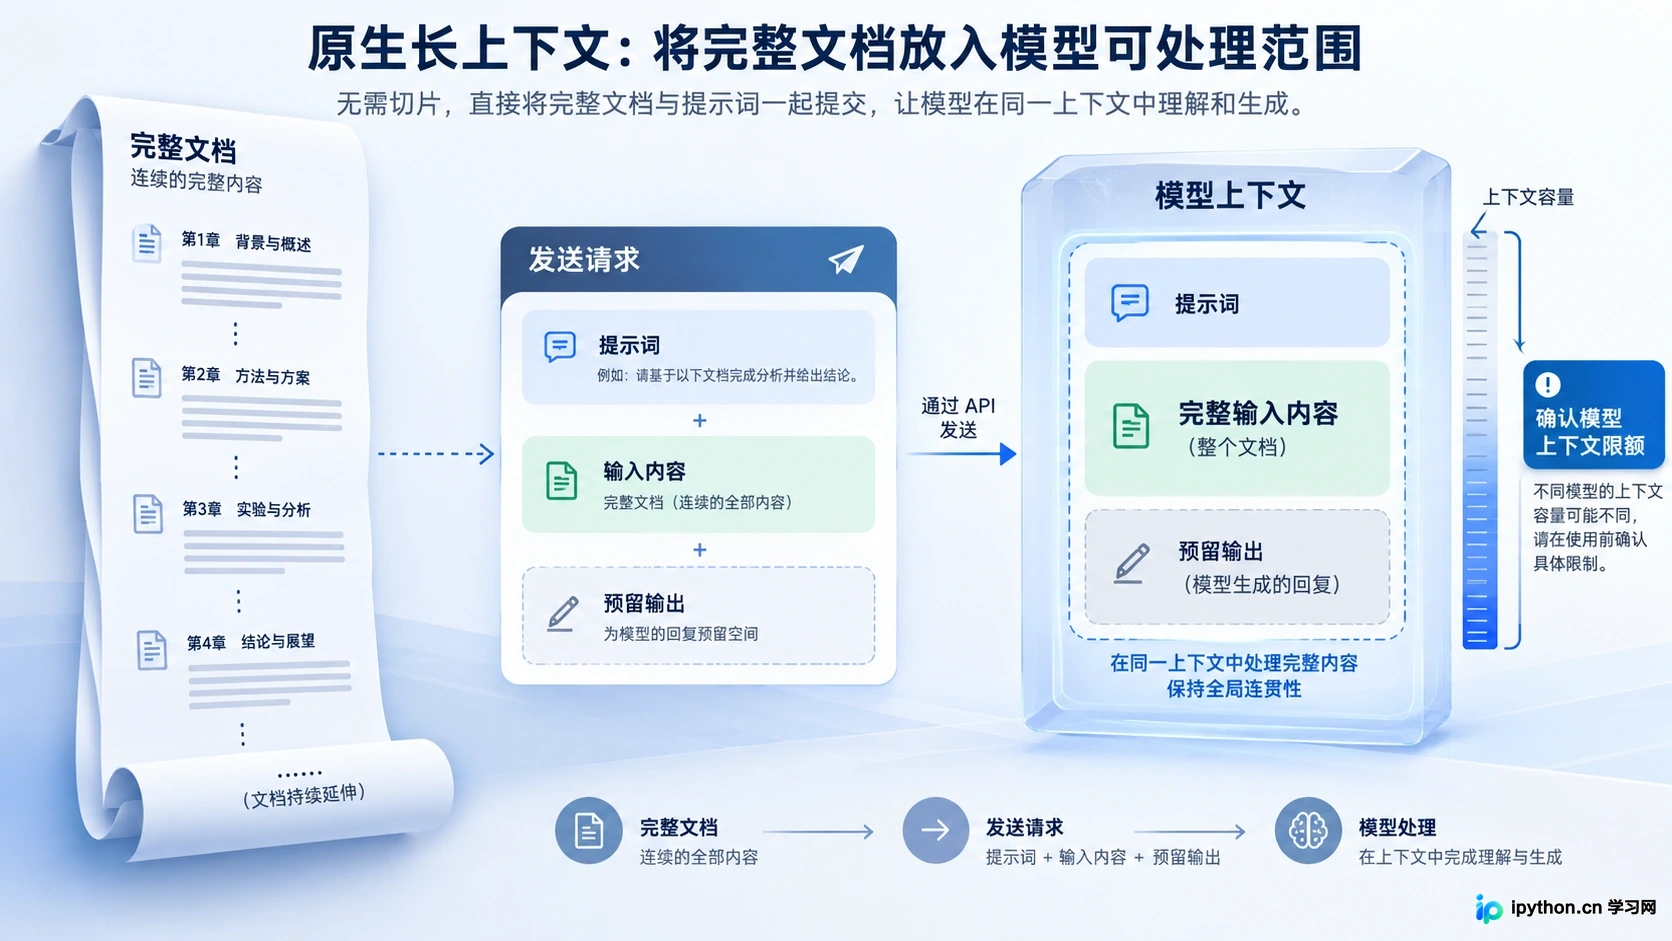
关于【原生长上下文支持】
关于【滑动窗口机制】
当对话历史不断累积,或者日志文件持续写入时,固定大小的上下文窗口就像是一个只能显示部分内容的屏幕。滑动窗口机制的核心在于“移动”:保留最新的 N 条消息或最近的 M 个 Token,将最早的内容移出上下文。
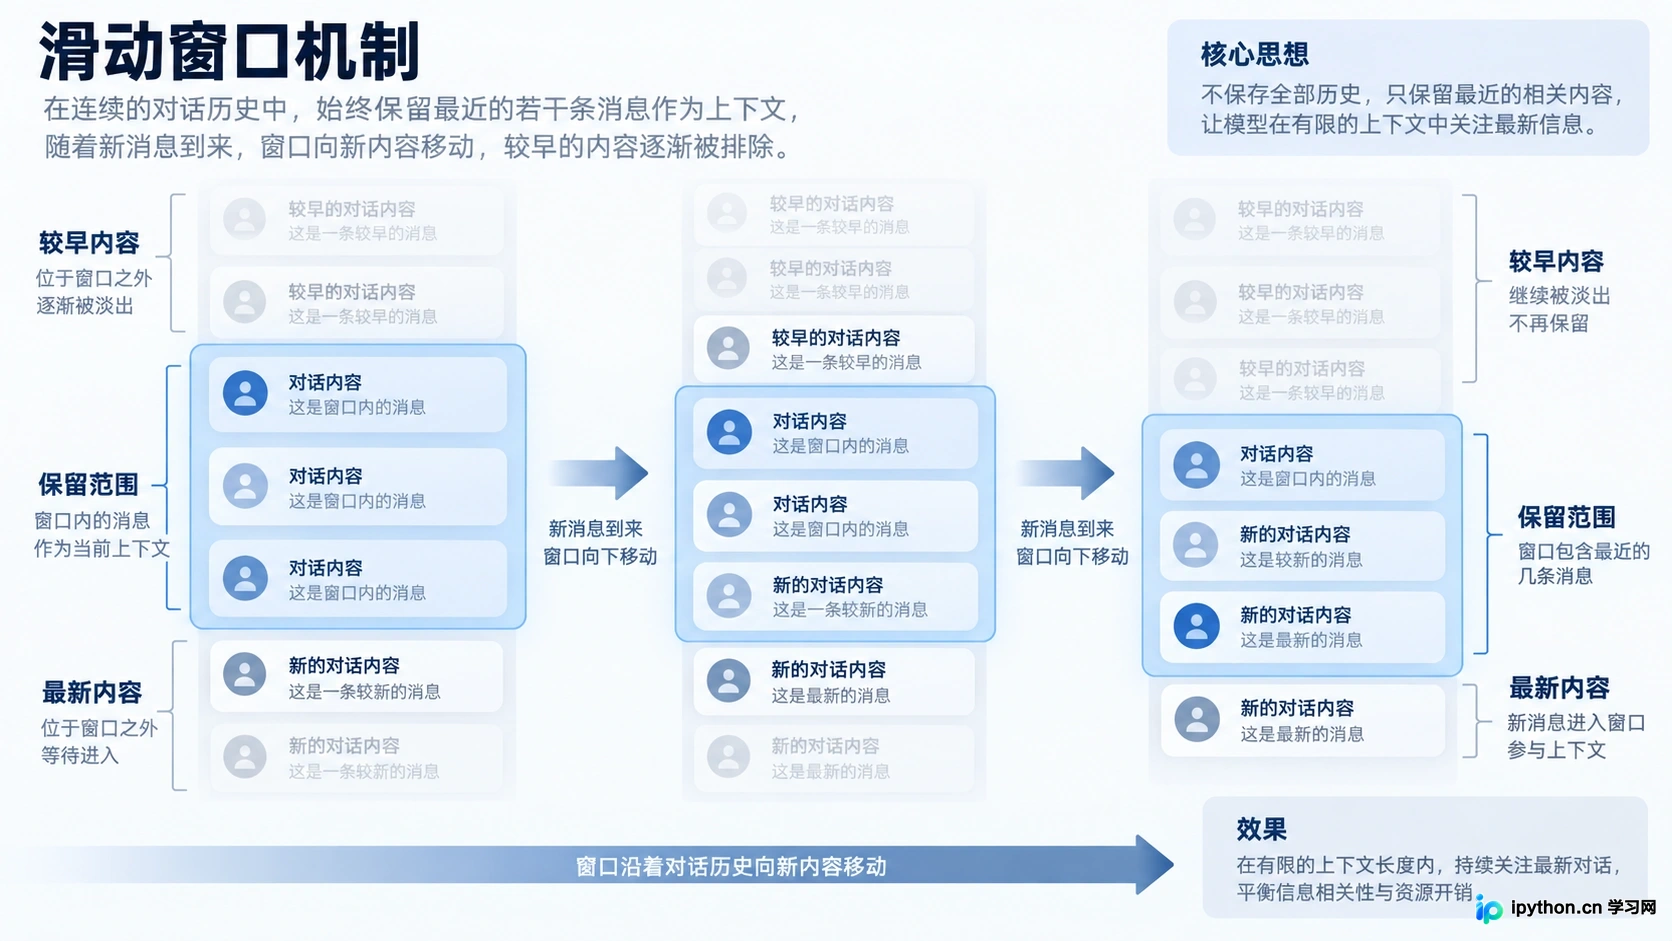
滑动窗口保留最新对话历史的逻辑演示
实施滑动窗口时,关键在于确定“窗口大小”和“步长”。在对话场景中,通常保留最近的 10-20 轮对话即可维持连贯性。对于代码补全或日志分析,可能需要保留更多的前文以维持语法或逻辑上下文。需要注意的是,简单的截断可能会丢失重要的初始设定或背景信息。因此,一种常见的优化做法是将“系统提示词(System Prompt)”固定在窗口之外,始终保留,而仅对用户消息和历史助手回复进行滑动截断。
关于【摘要压缩策略】
如果业务要求必须保留全文的语义脉络,但又受限于成本或硬性 Token 上限,摘要压缩是必要的预处理步骤。这种方法不是在 API 调用时截断,而是在调用前对文本进行“瘦身”。
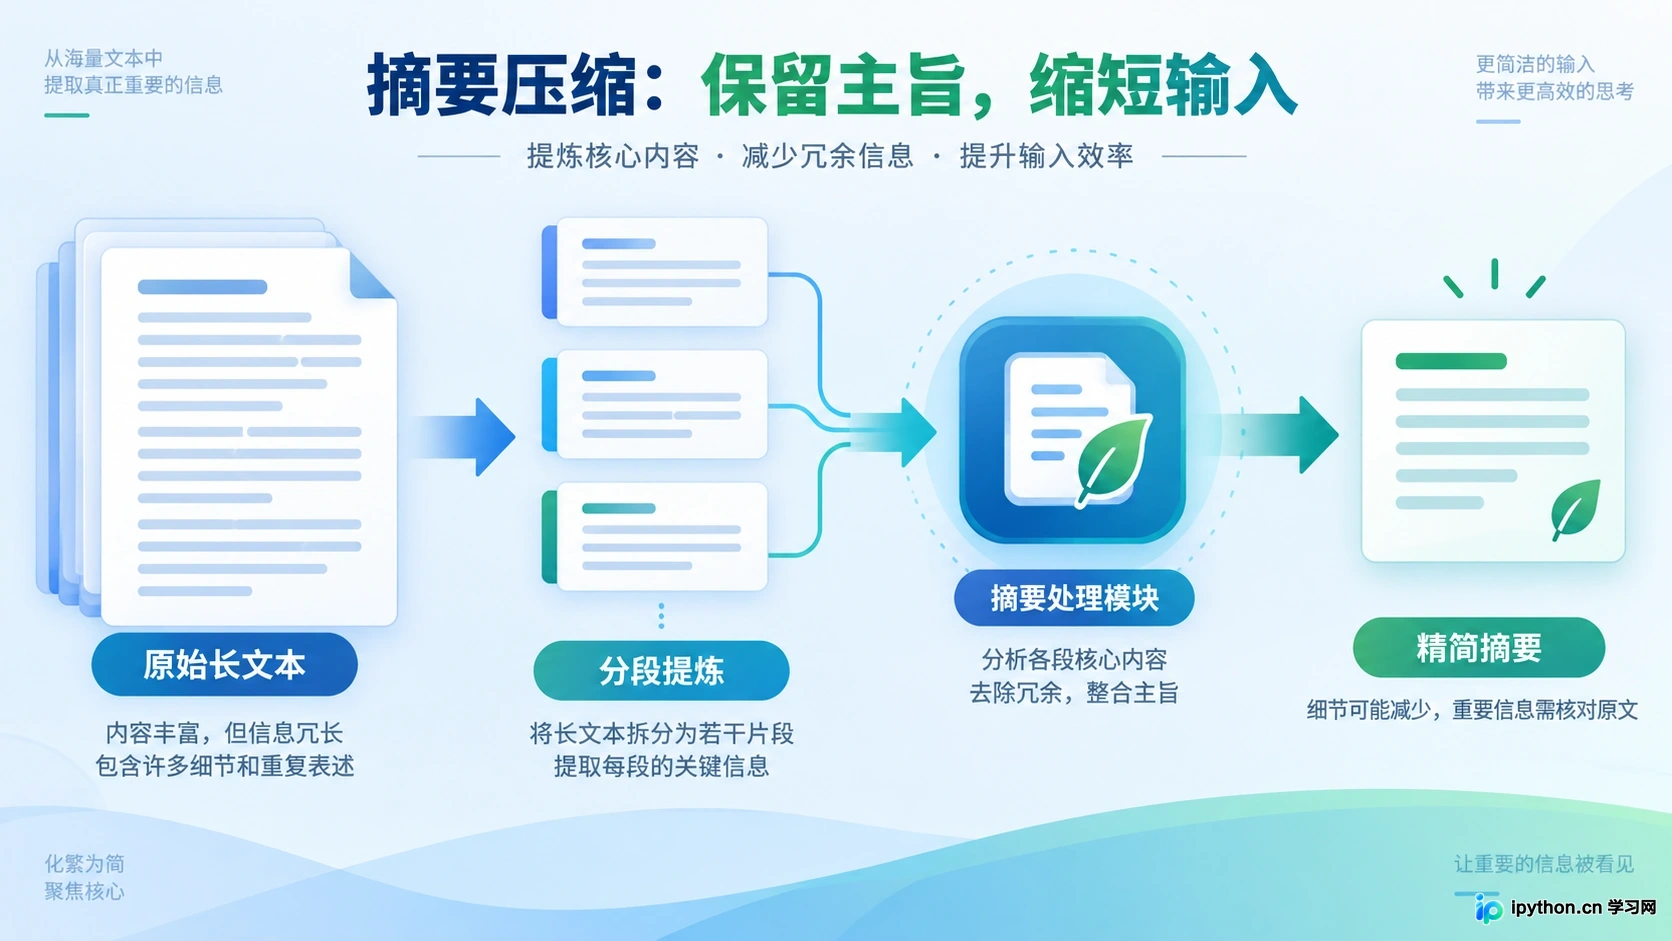
从长文档到精简摘要的处理流程
具体操作可以分为两步:首先,使用一个较小的模型或专门的摘要模型,将长文档分割成若干片段,分别生成简短摘要;其次,将这些摘要拼接,作为新的上下文输入给主模型。另一种方式是“递归摘要”,即对摘要再次进行摘要,直到长度符合要求。这种方法的优点是极大降低了 Token 消耗,且保留了宏观语义;缺点是微观细节丢失,不适合需要精确引用原文数字或条款的场景。
关于【混合策略与动态路由】
在实际工程中,单一策略往往难以应对所有情况。高效的系统通常会建立一个动态路由层。当输入文本较短时,直接使用原生长上下文;当文本中等长度且对细节要求不高时,采用滑动窗口;当文本极长且只需提取主旨时,触发摘要压缩流程。
此外,还可以结合“检索增强生成(RAG)”的思路。不将整个长文档放入上下文,而是将其向量化存入数据库。当用户提问时,先检索与问题最相关的片段,再将这些片段连同问题一起发送给通义千问 API。这种方式彻底突破了上下文长度的物理限制,因为每次只传入最相关的少量文本,是目前处理海量知识库的主流方案。
关于【错误处理与监控】
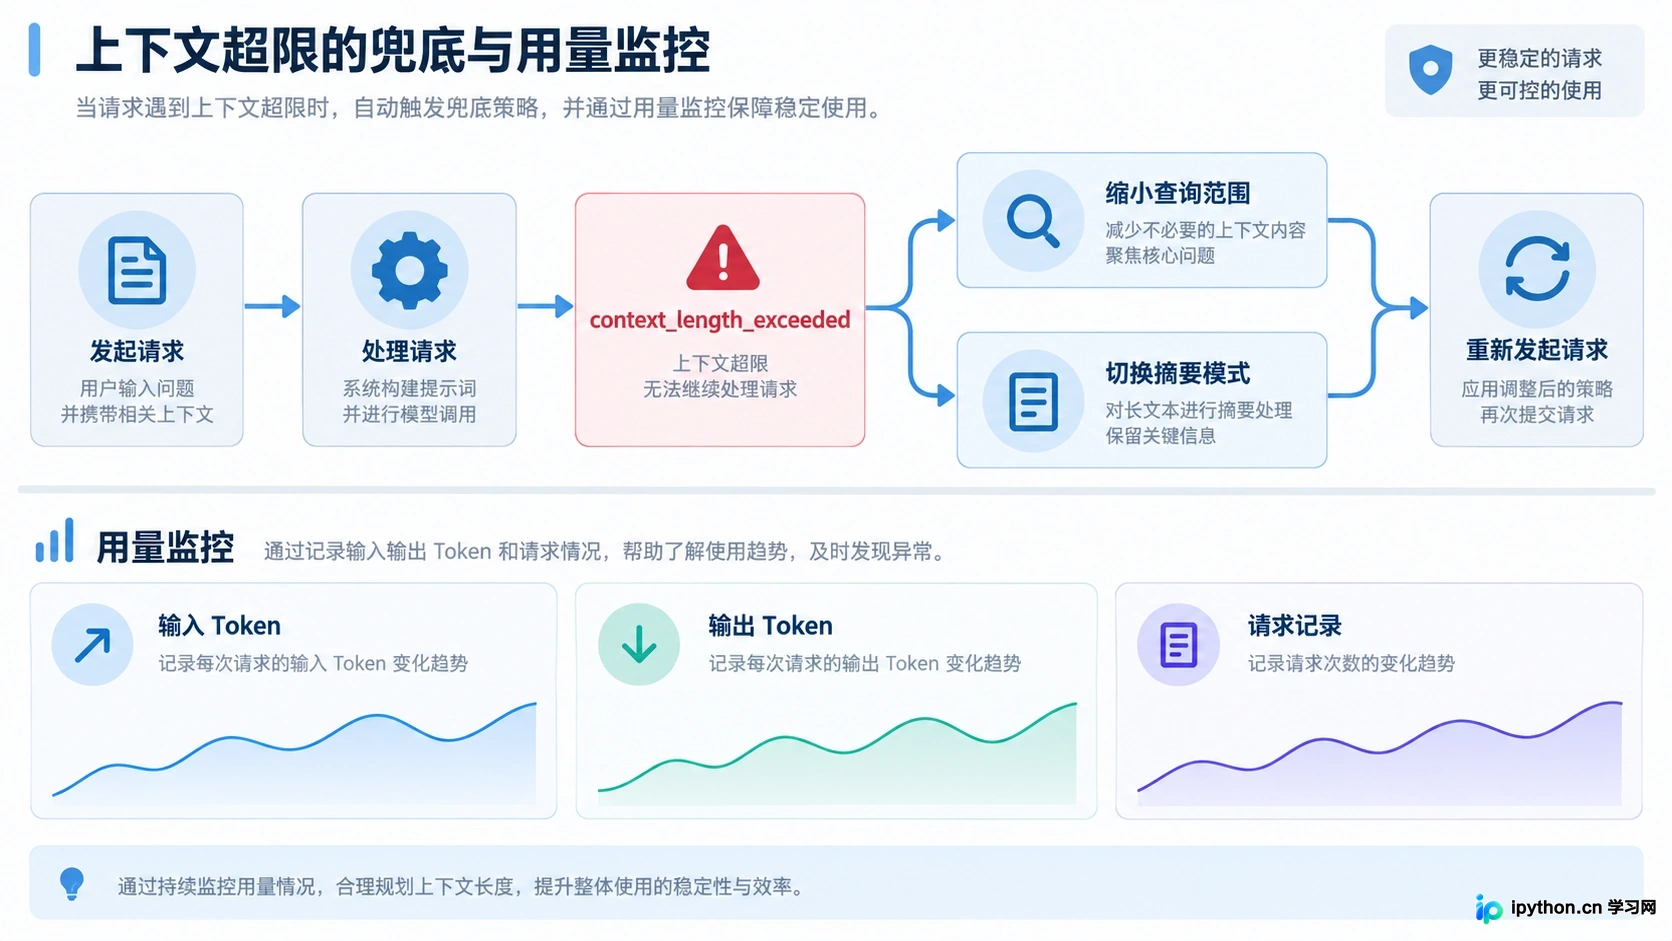
无论采用何种策略,都必须做好 API 错误处理的兜底。当遇到 context_length_exceeded 或类似错误时,程序不应直接崩溃,而应触发降级逻辑。例如,自动切换到摘要模式,或者提示用户缩小查询范围。
同时,监控实际使用的 Token 数量至关重要。通过记录每次请求的输入和输出 Token 数,你可以分析哪些场景最常触及上限,从而优化滑动窗口的大小或调整摘要的压缩率。这些数据是调整长文本处理策略的直接依据,能帮助你在成本与效果之间找到最佳平衡点。
关于【错误处理与监控】
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















