


Kimi长文本处理技巧:怎么快速总结万字文档与解析PDF

面对动辄数万字的行业报告、学术论文或合同文件,传统阅读方式往往耗时且容易遗漏重点。Kimi 智能助手的核心优势在于其强大的长文本处理能力,能够一次性读取并理解超长内容。掌握正确的交互技巧,可以将数小时的阅读工作压缩至几分钟,直接从海量文字中提取关键信息。
概述
Kimi 的处理逻辑并非简单的关键词匹配,而是基于对全文上下文的深度理解。用户无需手动拆分文件,只需将完整文档投喂给模型,并通过清晰的指令引导其输出所需结果。整个流程分为“导入资料”、“明确任务”和“细化追问”三个阶段。
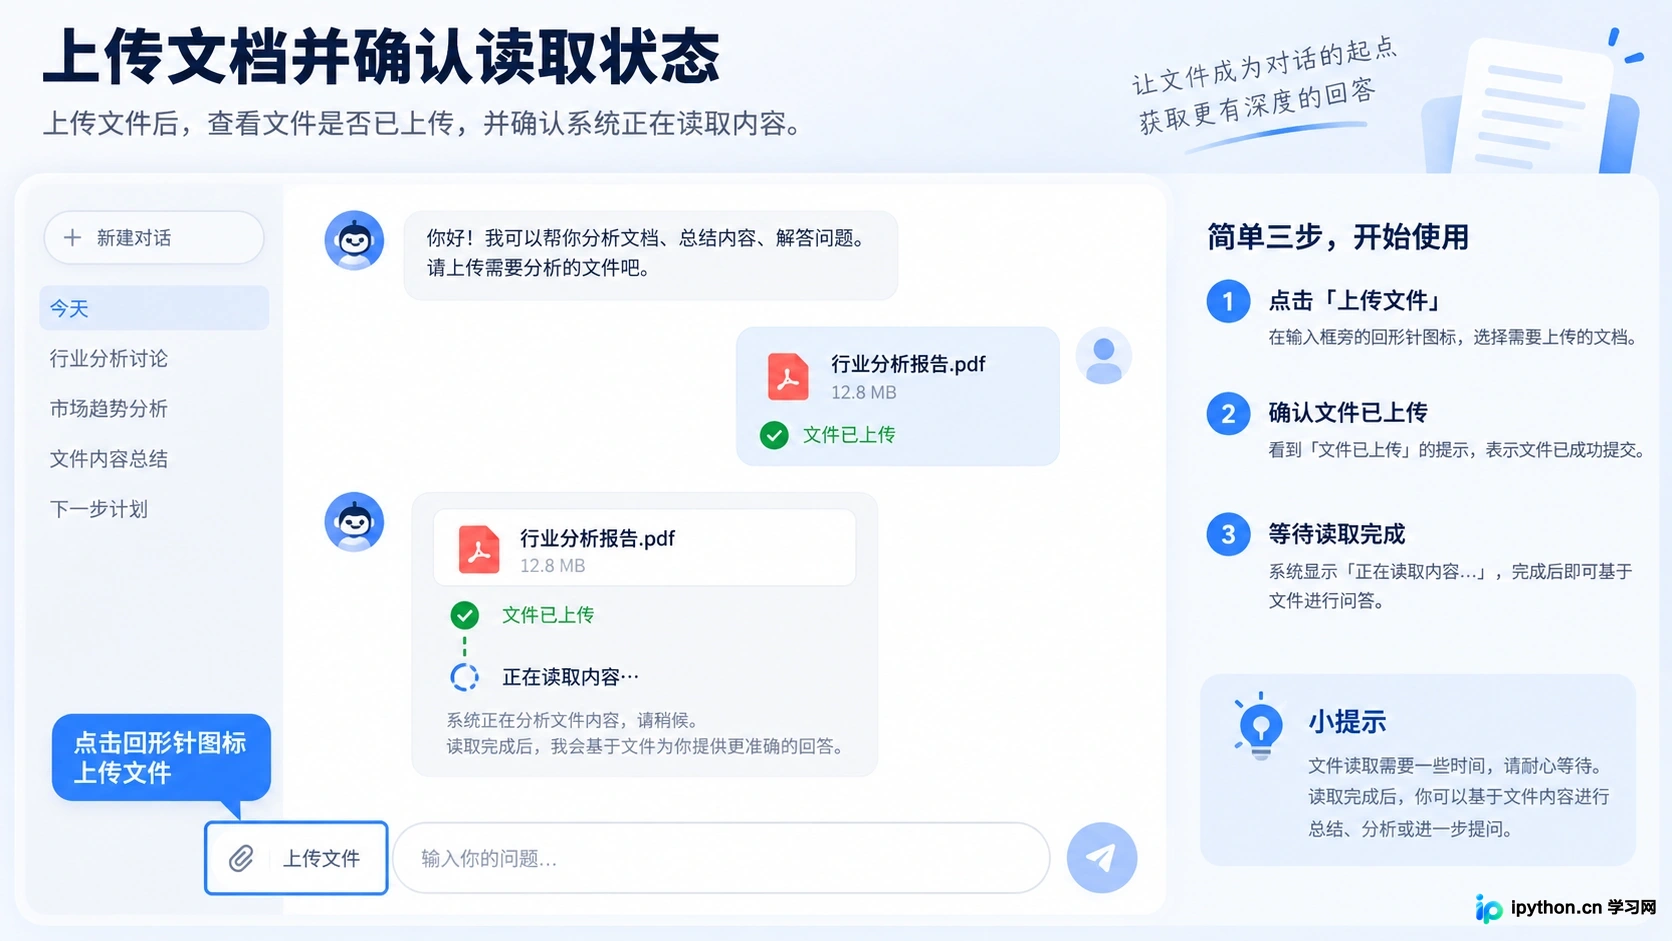
Kimi 对话界面中的文件上传入口与加载提示
关于【文件上传与识别】
处理长文档的第一步是确保 Kimi 完整读取了文件内容。在对话窗口左侧或底部找到上传按钮,支持 PDF、Word、TXT 等多种格式。对于万字以上的文档,建议直接上传原始文件而非复制粘贴文本,这样可以保留文档的结构层级(如标题、章节),有助于模型更准确地定位信息。
上传完成后,不要急于发送复杂指令。先观察 Kimi 的反馈,确认其已提示“文件上传成功”或类似状态。如果文档包含大量图表或非标准排版,可以在首次对话中简单询问:“请确认你是否已完整读取这份名为《XXX》的文档?”以确保上下文窗口已正确加载数据。
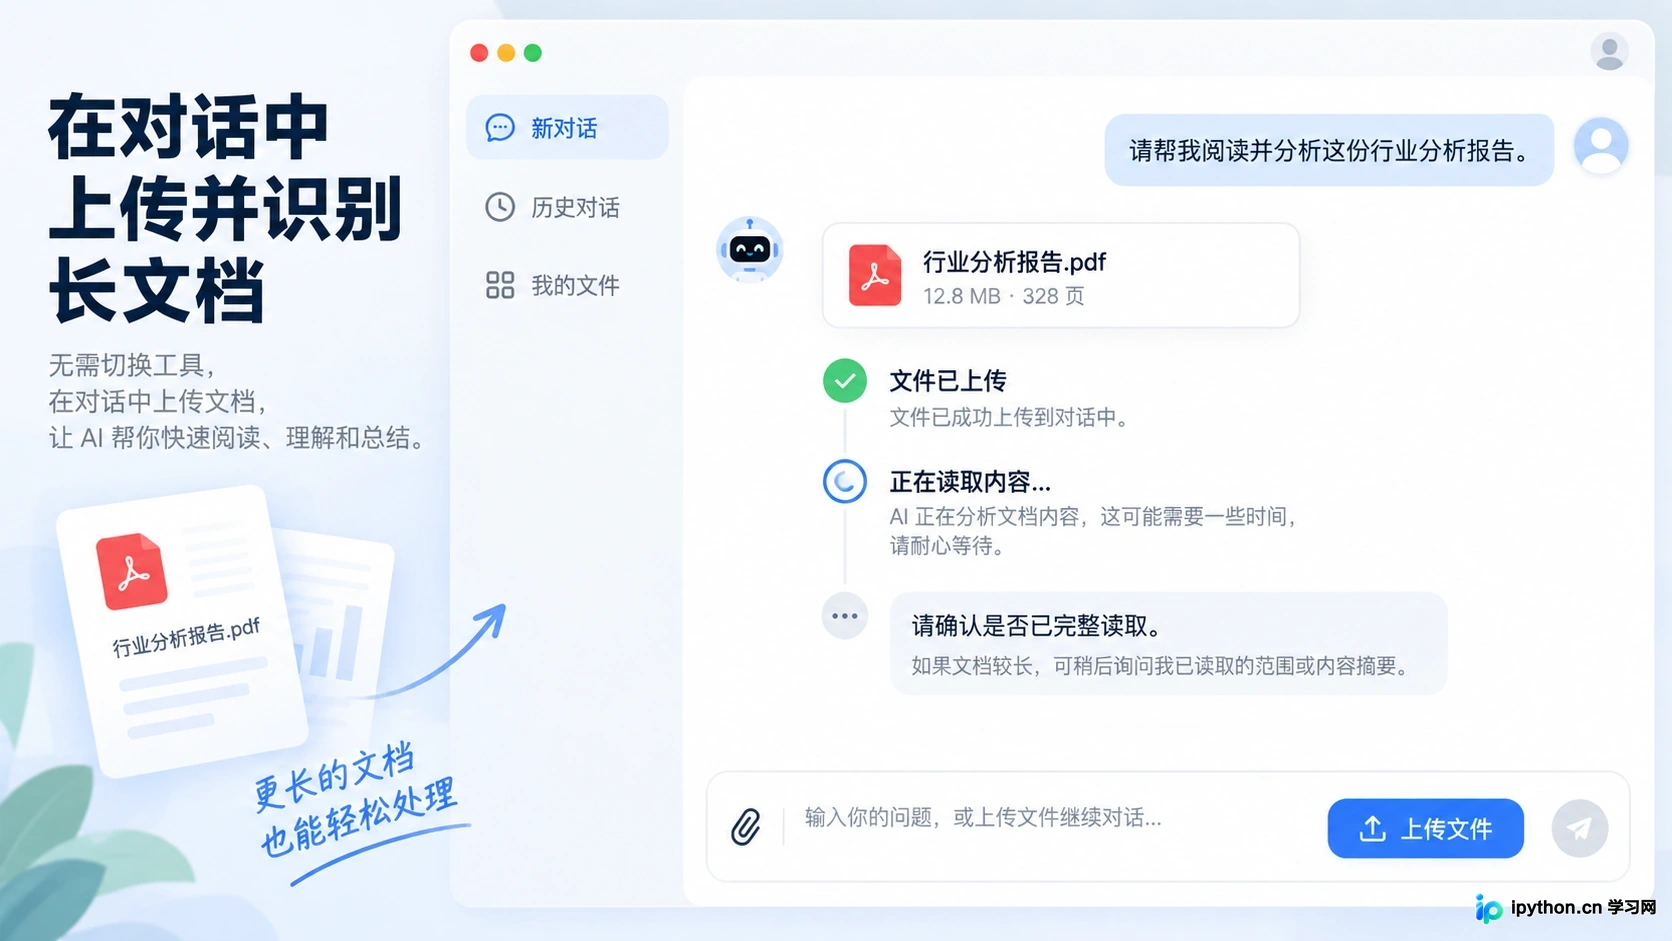
关于【文件上传与识别】
关于【全局摘要策略】
当需要快速了解文档大意时,避免使用模糊的“总结一下”这类指令。高效的摘要需要限定维度和长度。例如,要求 Kimi “用 300 字概括本文的核心观点,并列出 3 个主要论据”。这种结构化的要求能迫使模型跳过细枝末节,直接抓取主干。
对于长篇报告,可以采用“分层摘要法”。首先请求生成一份包含各章节标题的目录式摘要,确认整体框架无误后,再针对感兴趣的具体章节要求详细解读。这种方式既保证了全局视野,又避免了因一次性输出过多细节而导致的信息过载。
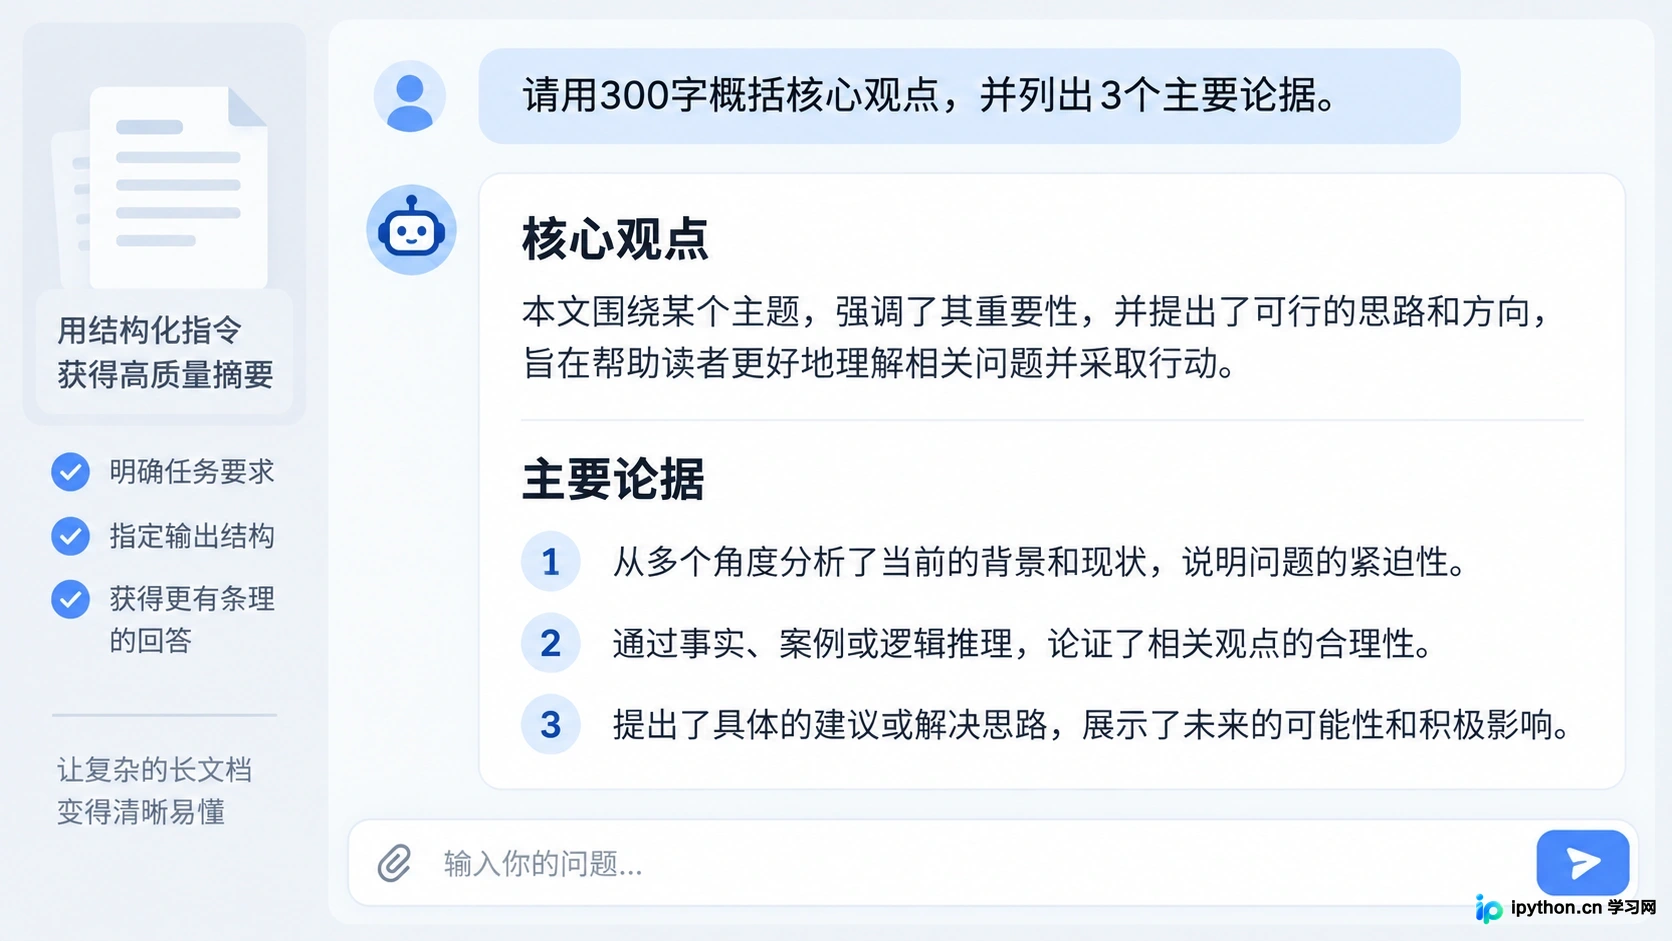
使用结构化指令获取分层摘要的效果
关于【关键信息提取】
解析 PDF 的另一大场景是提取特定数据或条款。利用 Kimi 的定位能力,可以直接询问具体细节。例如,“请找出文中关于‘风险评估’的所有段落,并整理成表格,包含风险类型、影响程度和建议措施三列”。
在处理合同或技术文档时,指定输出格式至关重要。明确要求以 Markdown 表格、列表或 JSON 格式输出,可以大幅减少后续整理的工作量。如果文档中存在相互矛盾的信息,可以追加指令:“请检查文中是否有前后不一致的数据或结论,如有请指出。”
关于【多轮追问与验证】
长文本处理不是一次性的问答,而是一个探索过程。基于 Kimi 的回答进行追问,可以挖掘更深层次的信息。例如,在得到初步摘要后,可以问:“文中提到的第二个论据,有哪些具体案例支持?”或者“作者对这一观点的反面意见是如何回应的?”
为了确保准确性,对于关键数据或引用,要求 Kimi 提供原文页码或段落位置。虽然 Kimi 不一定能精确到物理页码(取决于 PDF 解析方式),但它通常能引用原文片段。通过核对原文片段,可以有效验证模型回答的可靠性,避免“幻觉”带来的误导。
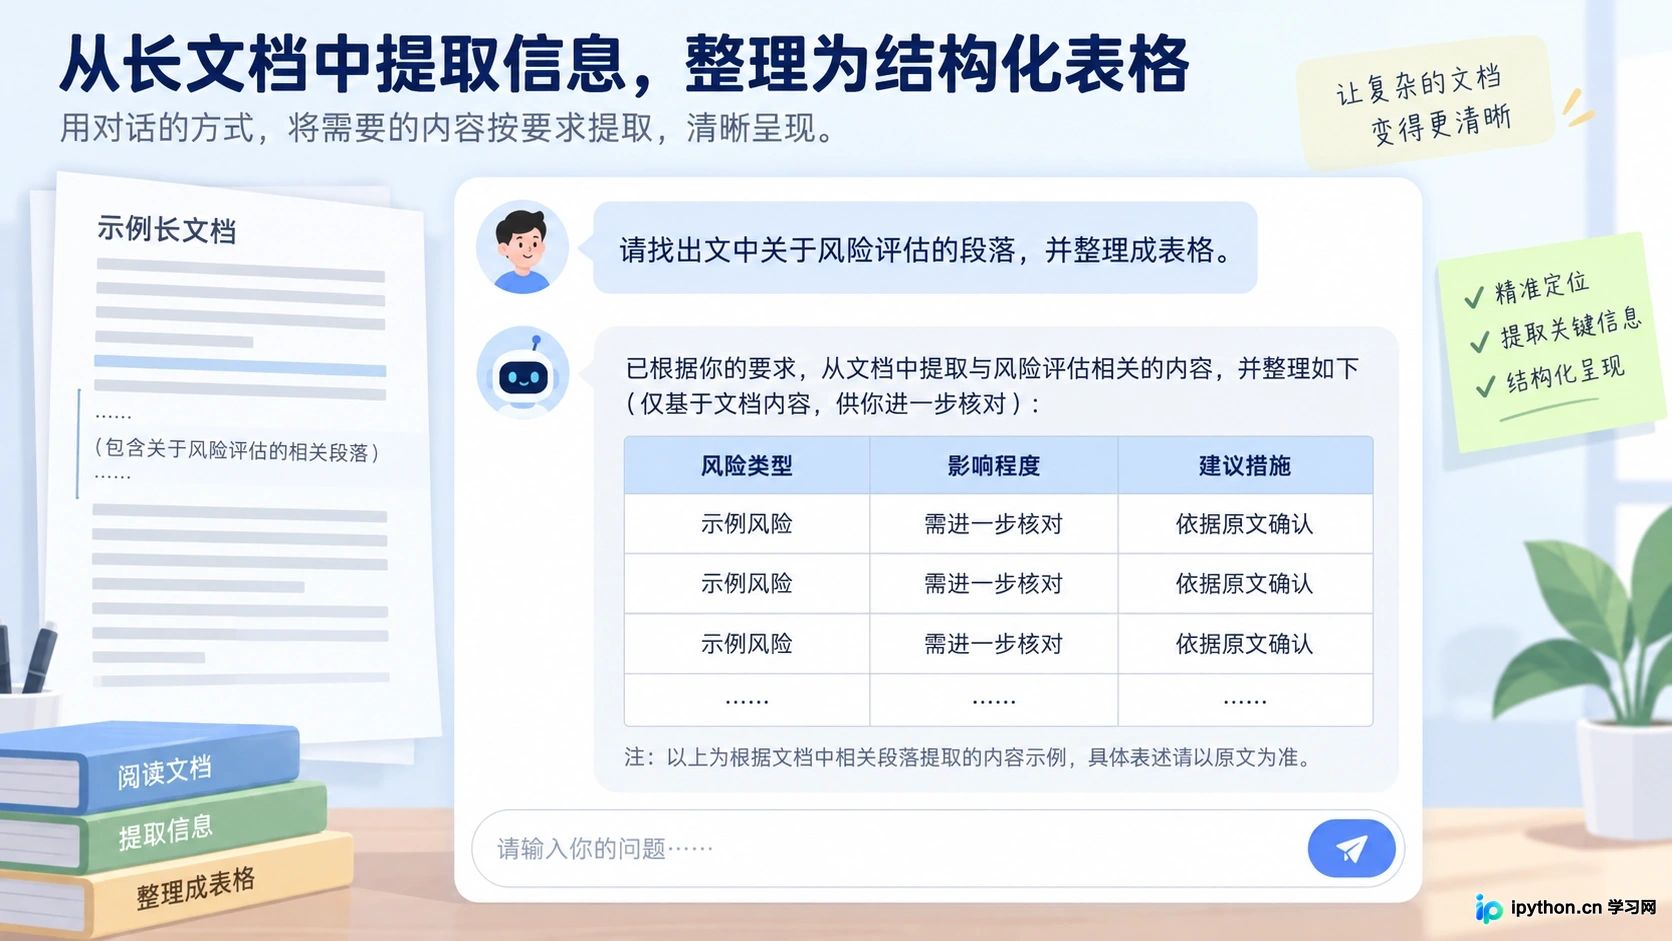
从长文档中提取关键信息并转换为表格
关于【复杂逻辑梳理】
部分学术或法律文档逻辑严密但表述晦涩。此时可以让 Kimi 扮演“解释者”角色。指令示例:“请用通俗易懂的语言,解释文中第三章提到的‘动态博弈模型’是如何运作的,并举一个生活中的例子。”
通过类比和简化,Kimi 能将抽象概念具象化。如果文档涉及多个主体或复杂流程,还可以要求生成流程图描述(Mermaid 代码)或步骤列表,将线性文字转化为可视化的逻辑结构,帮助读者快速理清脉络。
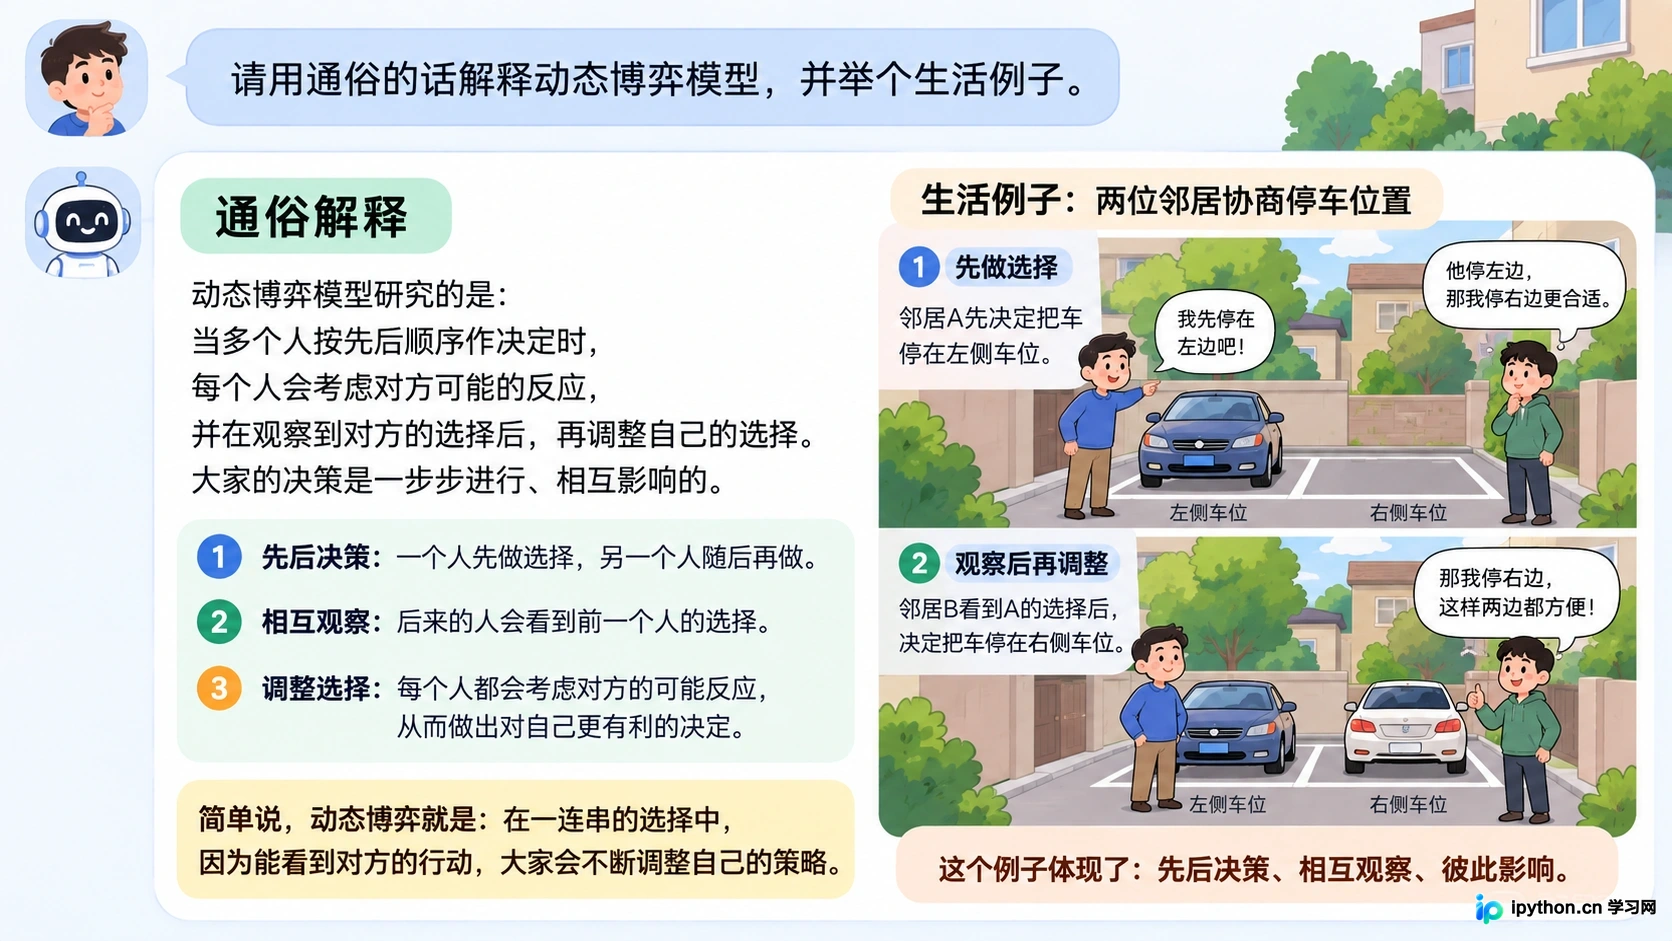
利用 Kimi 将晦涩理论转化为通俗解释
关于【注意事项与局限】
尽管 Kimi 擅长长文本,但仍需注意输入材料的质量。扫描版 PDF 若 OCR 识别效果差,可能导致乱码或断句错误,进而影响理解。此时建议先使用专业工具优化 PDF,或提取纯文本后再上传。此外,对于极度专业且冷门的领域术语,模型可能需要更多的上下文提示才能准确理解,适当提供背景信息有助于提升回答质量。
在处理敏感数据时,务必注意隐私保护,避免上传包含个人身份信息或商业机密的未脱敏文件。合理利用这些技巧,能让 Kimi 成为你处理海量信息时的得力助手,将精力集中在决策与思考上,而非繁琐的阅读中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















