


Python 提取 PDF 图片的三种实用方法:fitz、pdf2image 与优化技巧

本文详细介绍使用 Python 从 PDF 文件中提取图片的三种方法。首先讲解基于 fitz 库结合正则表达式匹配图片对象,并通过 pix.size 阈值过滤小色块;其次介绍 pdf2image 库的安装配置及 convert_from_path 与 convert_from_bytes 两种转换方式;最后补充多线程加速技巧,帮助开发者高效、安全地批量处理 PDF 图片资源。
在数据处理过程中,我们常遇到需要从单份或多份 PDF 文档中提取图片的需求。依赖在线工具存在数据泄露风险,而手动操作又过于繁琐。实际上,利用 Python 编程可以高效且安全地解决这一问题。本文将系统分享几种主流的 Python 提取 PDF 图片方案。需要注意的是,目前尚无一种方法能实现 100% 的完美提取,各方法各有优劣,建议结合使用多种方案以互补不足。主要涉及的技术方案包括:
- 基于
fitz库与正则表达式匹配提取 - 基于
pdf2image库的两种转换路径
利用 fitz 库配合正则搜索提取
fitz 作为 pymupdf 的子模块,需先通过命令行安装 pymupdf:
pip install pymupdf注意在代码中导入时,应使用 import fitz 语句引入模块。
以下代码演示如何利用 fitz 库提取图片。该方法通过正则表达式匹配图片元素,将模板元素转换为像素数据后,以图片格式保存输出。
import fitz
import re
import os

file_path = r'C:\xxx\xxx.pdf' # PDF 文件路径
dir_path = r'C:\xxx' # 存放图片的文件夹

def pdf2image1(path, pic_path):
  checkIM = r"/Subtype(?= */Image)"
  pdf = fitz.open(path)
  lenXREF = pdf._getXrefLength()
  count = 1
  for i in range(1, lenXREF):
    text = pdf._getXrefString(i)
    isImage = re.search(checkIM, text)
    if not isImage:
      continue
    pix = fitz.Pixmap(pdf, i)
    new_name = f"img_{count}.png"
    pix.writePNG(os.path.join(pic_path, new_name))
    count += 1
    pix = None

pdf2image1(file_path, dir_path)
运行示例文件后的提取结果如下所示:
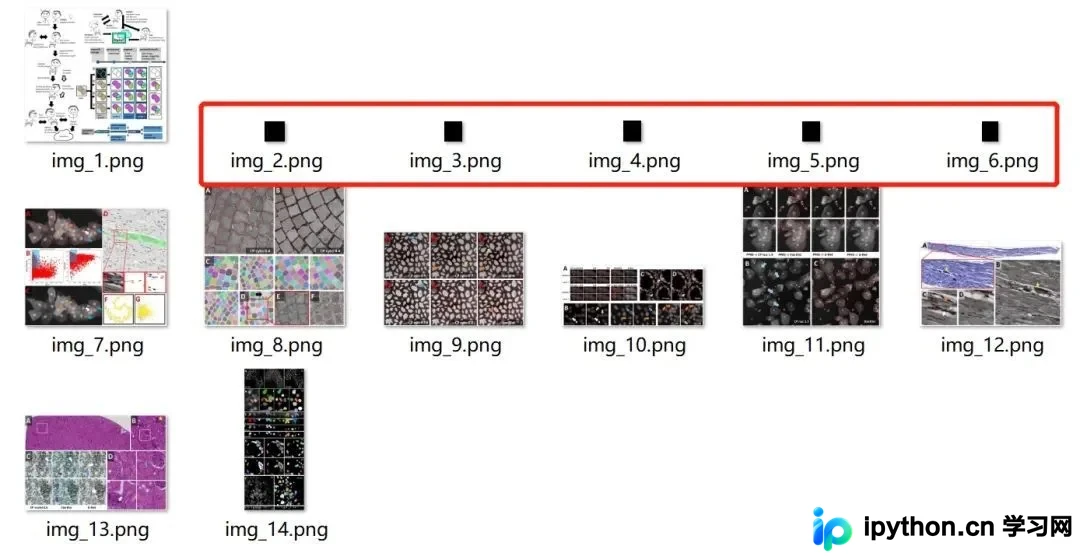
观察结果可知,部分极小的色块也被识别并提取为图片。如何有效过滤这些无效的小色块呢?
一种简单的过滤策略是基于尺寸判断。在 fitz 库中,pix 像素对象提供了一个关键属性 pix.size,用于反映像素数量。通常,无效的小色块该值较低,因此可设定阈值进行过滤。例如,以 10000 为阈值进行筛选:
import fitz
import re
import os

file_path = r'C:\xxx\xxx.pdf' # PDF 文件路径
dir_path = r'C:\xxx' # 存放图片的文件夹

def pdf2image1(path, pic_path):
  checkIM = r"/Subtype(?= */Image)"
  pdf = fitz.open(path)
  lenXREF = pdf._getXrefLength()
  count = 1
  for i in range(1, lenXREF):
    text = pdf._getXrefString(i)
    isImage = re.search(checkIM, text)
    if not isImage:
      continue
    pix = fitz.Pixmap(pdf, i)
    if pix.size < 10000: # 在这里添加一处判断一个循环
      continue # 不符合阈值则跳过至下
    new_name = f"img_{count}.png"
    pix.writePNG(os.path.join(pic_path, new_name))
    count += 1
    pix = None

pdf2image1(file_path, dir_path)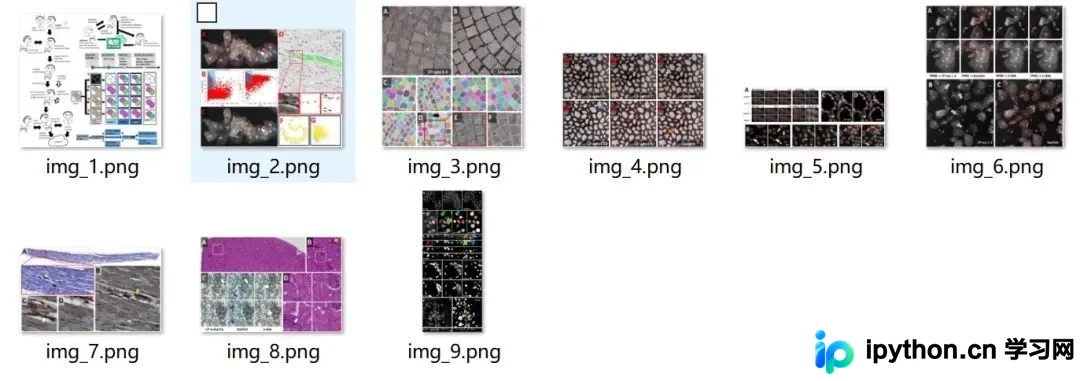
应用过滤后,可以看到所有有效图片均被正常提取,无效色块已被排除。
基于 pdf2image 库的两种实现方法
从库名即可推测其功能,官方文档地址为 https://www.cnpython.com/pypi/pdf2image。
可通过 pip install pdf2image 命令进行安装,但需注意,真正起转换作用的是 poppler 工具,因此必须额外安装并配置该环境:
- Windows 用户必须安装
poppler for Windows,并将 bin/ 文件夹路径添加到系统环境变量 PATH 中。 - Mac 用户则需安装
poppler for Mac。
具体发挥作用的代码在官方文档中已有详细说明:
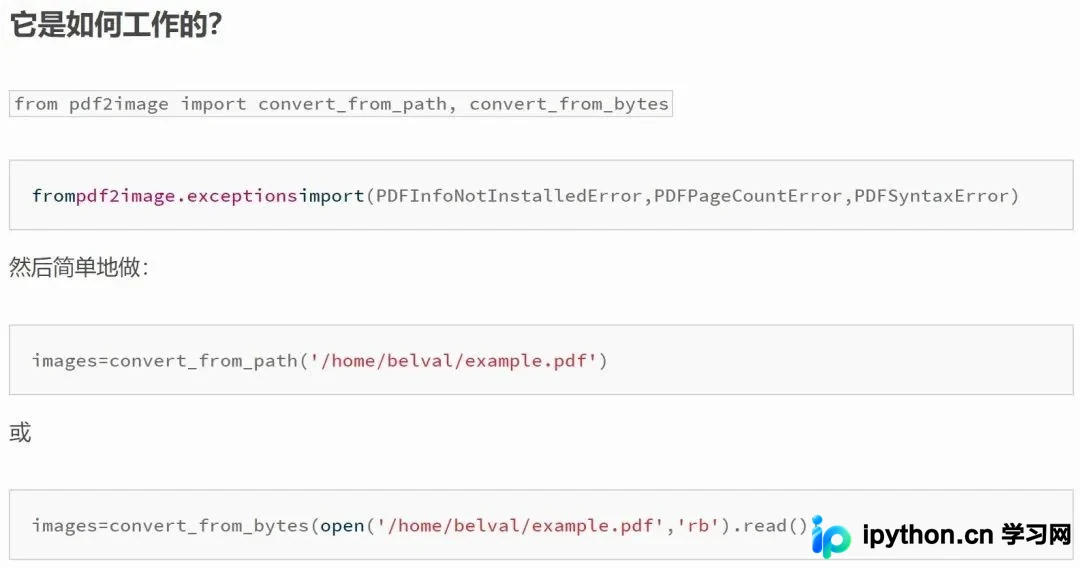
接下来,我们分别尝试这两种转换方法:
from pdf2image import convert_from_path,convert_from_bytes
import tempfile
from pdf2image.exceptions import PDFInfoNotInstalledError, PDFPageCountError, PDFSyntaxError
import os

file_path = r'C:\xxx\xxx.pdf' # PDF 文件路径
dir_path = r'C:\xxx' # 存放图片的文件夹

def pdf2image2(file_path, dir_path):
  images = convert_from_path(file_path, dpi=200)
  for image in images:
    if not os.path.exists(dir_path):
      os.makedirs(dir_path)
    image.save(file_path + f'\img_{images.index(image)}.png', 'PNG')

pdf2image2(file_path, dir_path)
第一种方法可成功提取图片。接着测试第二种方法:
from pdf2image import convert_from_path,convert_from_bytes
import tempfile
from pdf2image.exceptions import PDFInfoNotInstalledError, PDFPageCountError, PDFSyntaxError
import os

file_path = r'C:\xxx\xxx.pdf' # PDF 文件路径
dir_path = r'C:\xxx' # 存放图片的文件夹

def pdf2image3(file_path, dir_path):
  images = convert_from_bytes(open(file_path, 'rb').read())
  for image in images:
    if not os.path.exists(dir_path):
      os.makedirs(dir_path)
    image.save(file_path + f'\img_{images.index(image)}.png', 'PNG')

pdf2image3(file_path, dir_path)
结果显示与第一种方法一致,PDF 中的所有图片均被完整提取。
补充说明:核心方法 covert_from_bytes 包含大量参数,用户可根据需求自行调整。常用参数总结如下:
|
参数 |
意义 |
|---|---|
|
pdf_path |
PDF 文档路径 |
|
dpi |
图像质量(如果是学术期刊杂志常见 300dpi) |
|
output_folder |
将生成的图像写入文件夹(而不是直接写入内存) |
|
first_page |
起始转换页数 |
|
last_page |
转换至哪一页 |
|
fmt |
图像格式,可以指定为 png,默认为 ppm |
|
thread_count |
允许参与转换的线程数 |
|
userpw |
PDF 的密码 |
|
output_file |
输出文件名 |
|
poppler_path |
指定 poppler 的安装路径,一开始配置好就无需指定 |
值得一提的是 thread_count 参数,启用多线程可显著加快转换速度,尤其在处理页面较多的 PDF 文件时效果明显。感兴趣的用户可以尝试配置。
以上即为 Python 提取 PDF 图片的三种方法详解,更多相关内容请关注本站其他技术文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















