


Python实现ts视频碎片爬取与验证码登录教程

本文详细讲解如何使用Python爬取经过分片处理的TS视频文件,并解决验证码登录难题。通过手动或自动识别验证码完成Session保持,解析M3U8索引文件获取视频片段列表,批量下载后拼接并转换为MP4格式,完整展示从登录到视频保存的技术细节。
本次实践的目标是爬取用户账号内已购买课程的视频资源。
一、实现登录账号
本方案采用手动输入验证码的方式进行登录,具备技术能力的用户也可尝试通过图像识别接口自动填写验证码。登录成功后,需利用Session机制维持登录状态,以确保后续请求的合法性。
1.获取验证码地址
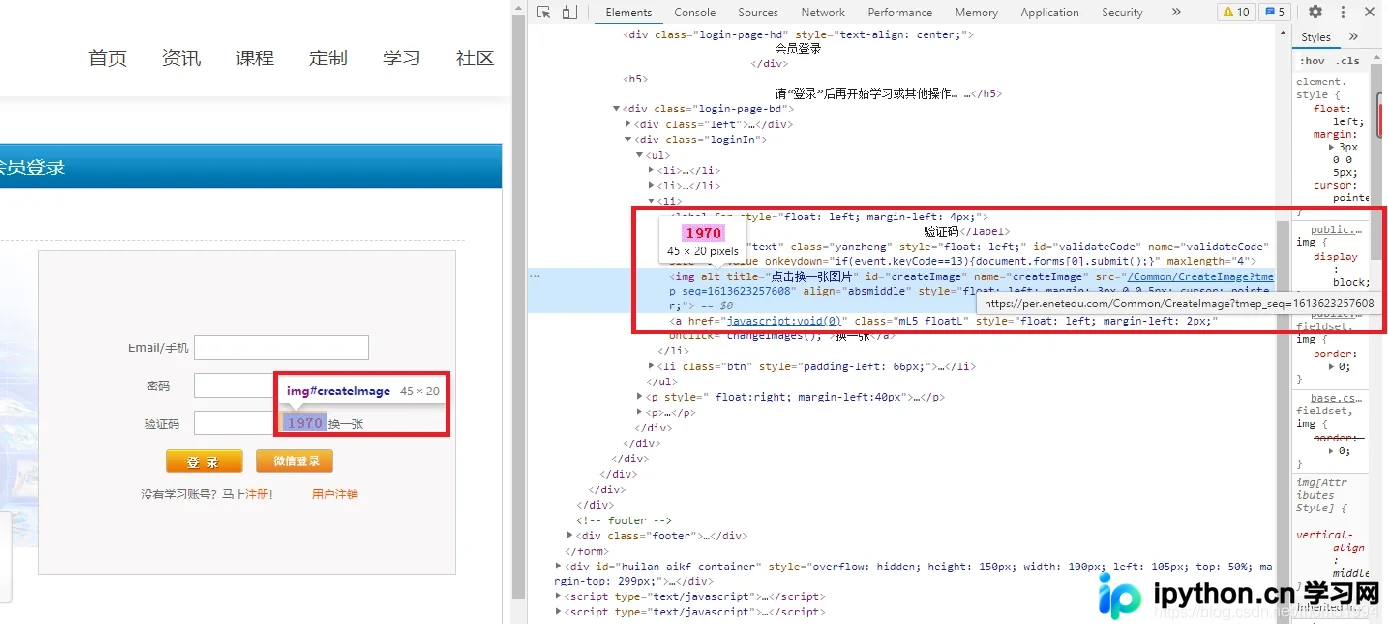
首先,通过分析网页源码或网络请求,定位验证码图片的生成接口。观察发现,验证码图片的请求地址包含一个时间戳参数,例如:https://per.enetedu.com/Common/CreateImage?tmep_seq=1613623257608。
其中,tmep_seq=1613623257608这一参数用于防止浏览器缓存,确保每次请求获取最新的验证码图片。因此,去除时间戳参数后,真正的验证码图片基础地址为:https://per.enetedu.com/Common/CreateImage。
接下来,需要确定登录时提交的表单数据内容及POST请求的目标地址。
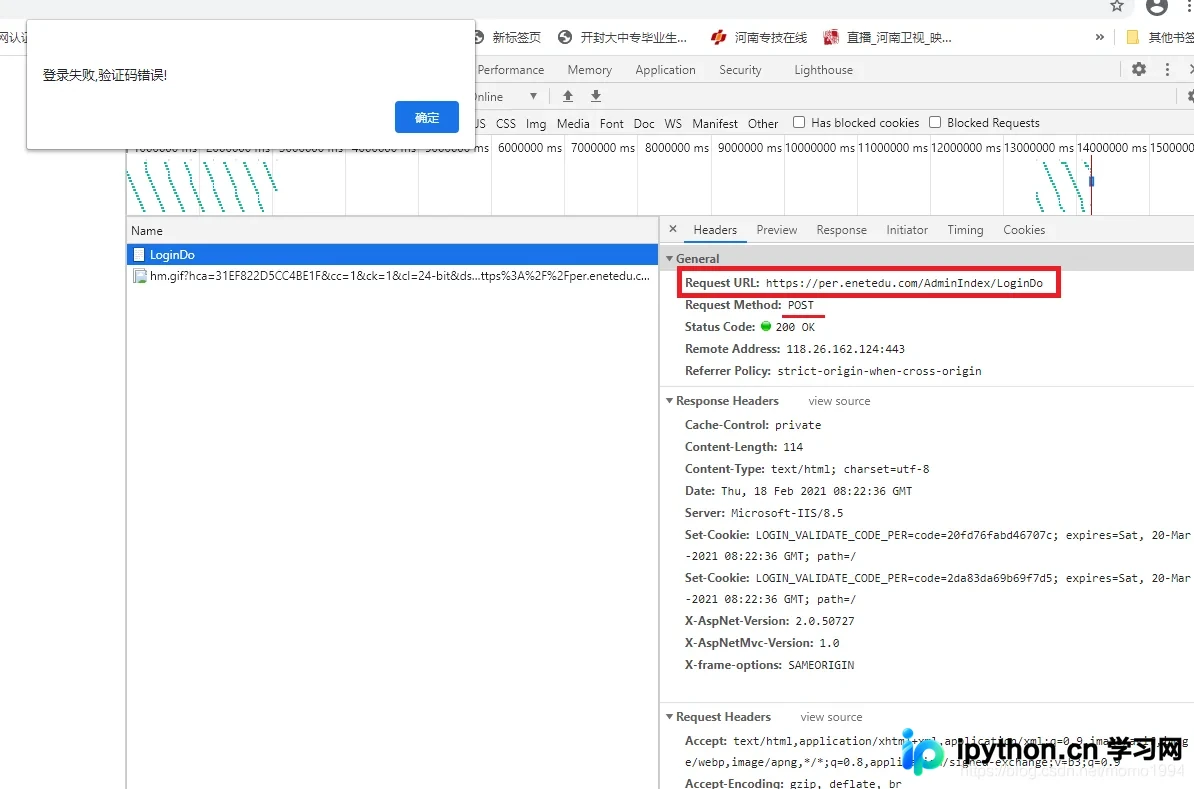
具体操作如下:(1) 在未填写用户名、密码及验证码的情况下,直接点击登录按钮,利用Chrome浏览器的开发者工具(Network面板)监控网络请求,定位到POST提交地址为:https://per.enetedu.com/AdminIndex/LoginDo。
(2) 继续分析该POST请求的Payload,找到Form Data部分,明确登录所需提交的字段结构。
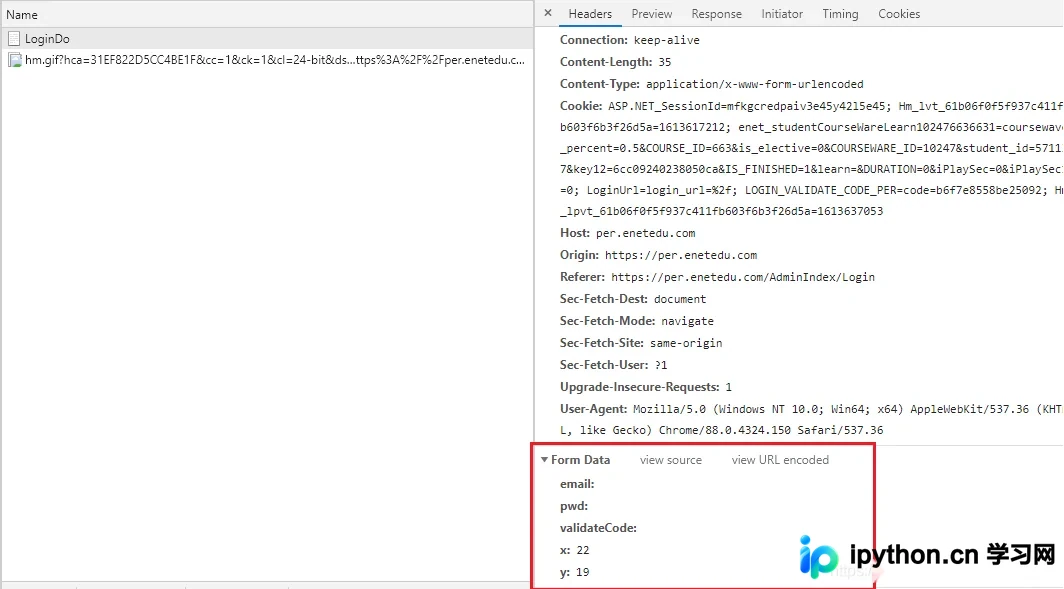
基于上述分析,包含验证码输入的完整登录代码如下:
import requests
from PIL import Image

#用户名-密码-验证码方式,登录
CaptchaUrl = "https://per.enetedu.com/Common/CreateImage" #获取验证码地址
PostUrl = "https://per.enetedu.com/AdminIndex/LoginDo"  #post登录信息地址

client = requests.Session()
username = '替换为自己的用户名'
password = '替换为自己的密码'

qr_code = client.get(CaptchaUrl)
open('login.jpg', 'wb').write(qr_code.content) #将验证码图片保存至本地
img = Image.open('login.jpg')
img.show()  #打开图片

code = input("请输入验证码: \n") #输入验证码
postData = {      #构造POST表单
 'email': username,
 'pwd': password,
 'validateCode': code,
 'x': '22',
 'y': '19'
}
result = client.post(PostUrl,postData) #向PostUrl提交表单
二、实现ts碎片视频下载,并转换为mp4格式
1.分析视频下载地址
登录成功后,检查视频播放区域的HTML代码,尝试直接获取视频地址并保存至本地。然而,实际观察发现(如下图所示),视频并非单一文件,而是被分割为多个.ts片段,通过分段加载的方式在页面中播放。每个视频片段的GET请求地址如右侧红框所示。
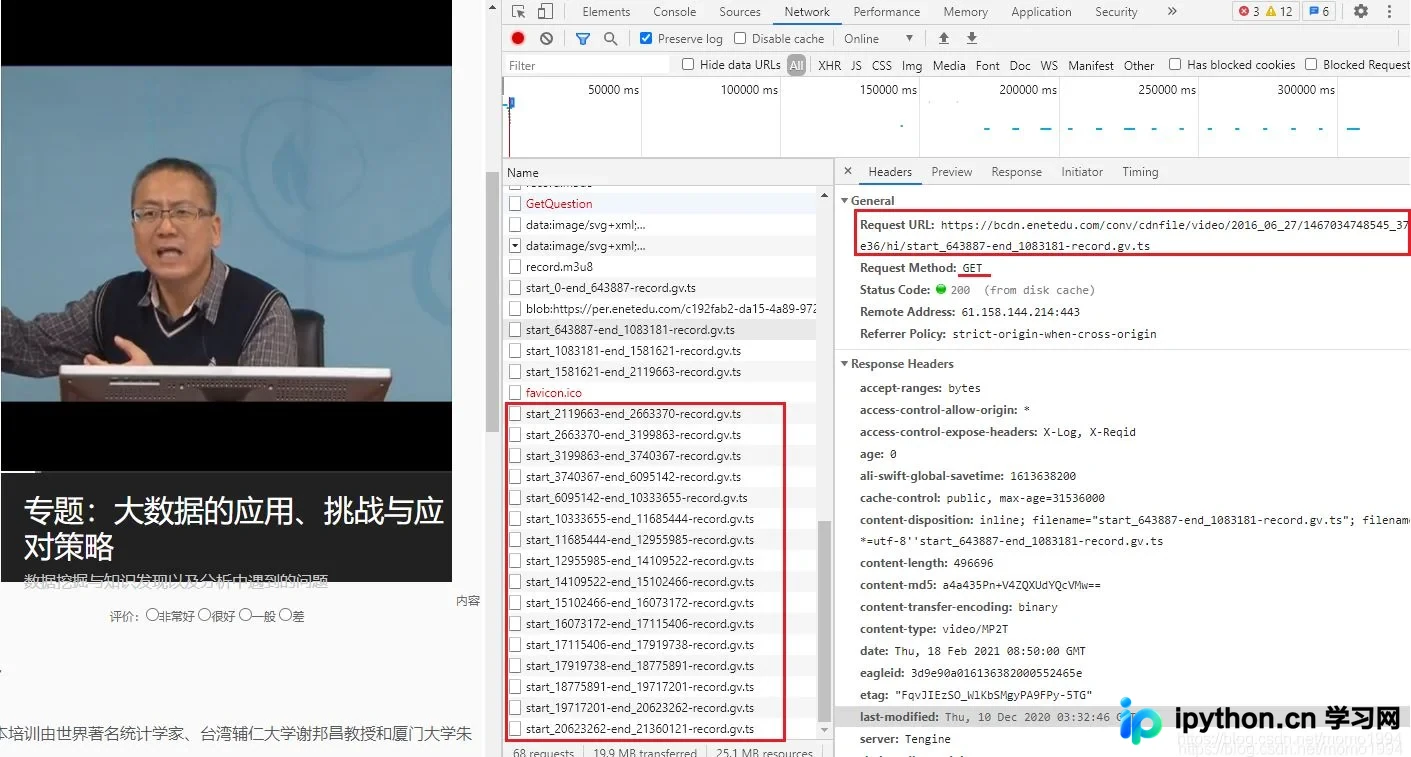
经查阅资料得知,视频的分段逻辑由一个.m3u8索引文件控制。该文件内容示例如下,其中记录了每个视频片段起始(start)和结束(end)的编号信息。
#EXTM3U
#EXT-X-VERSION:3
#EXT-X-ALLOW-CACHE:YES
#EXT-X-TARGETDURATION:10
#EXTINF:10.000000,
start_0-end_765064-record.gv.ts
#EXTINF:10.000000,
start_765064-end_1769567-record.gv.ts
#EXTINF:10.000000,
start_1769567-end_2600798-record.gv.ts
#EXTINF:10.000000,
start_2600798-end_3593502-record.gv.ts
#EXTINF:10.000000,
start_3593502-end_4500784-record.gv.ts
#EXTINF:10.000000,
start_4500784-end_5399861-record.gv.ts
#EXTINF:10.000000,
start_5399861-end_6288622-record.gv.ts
#EXTINF:10.000000,
start_6288622-end_7044459-record.gv.ts
#EXTINF:10.000000,
start_7044459-end_7878487-record.gv.ts
#EXTINF:10.000000,
start_7878487-end_8811793-record.gv.ts
#EXTINF:10.000000,
因此,下载视频的核心在于获取该.m3u8文件,并通过解析该文件来分段下载视频片段。
目前采用人工方式查找.m3u8文件的下载地址,尚未研究出通过视频地址自动解析出.m3u8地址的通用方法。查找方法较为简单:在Chrome浏览器的Network控制台中刷新页面,即可找到如图中所示的.m3u8文件请求。查看该文件的详细信息,红框标注的地址即为该视频的.m3u8下载地址。
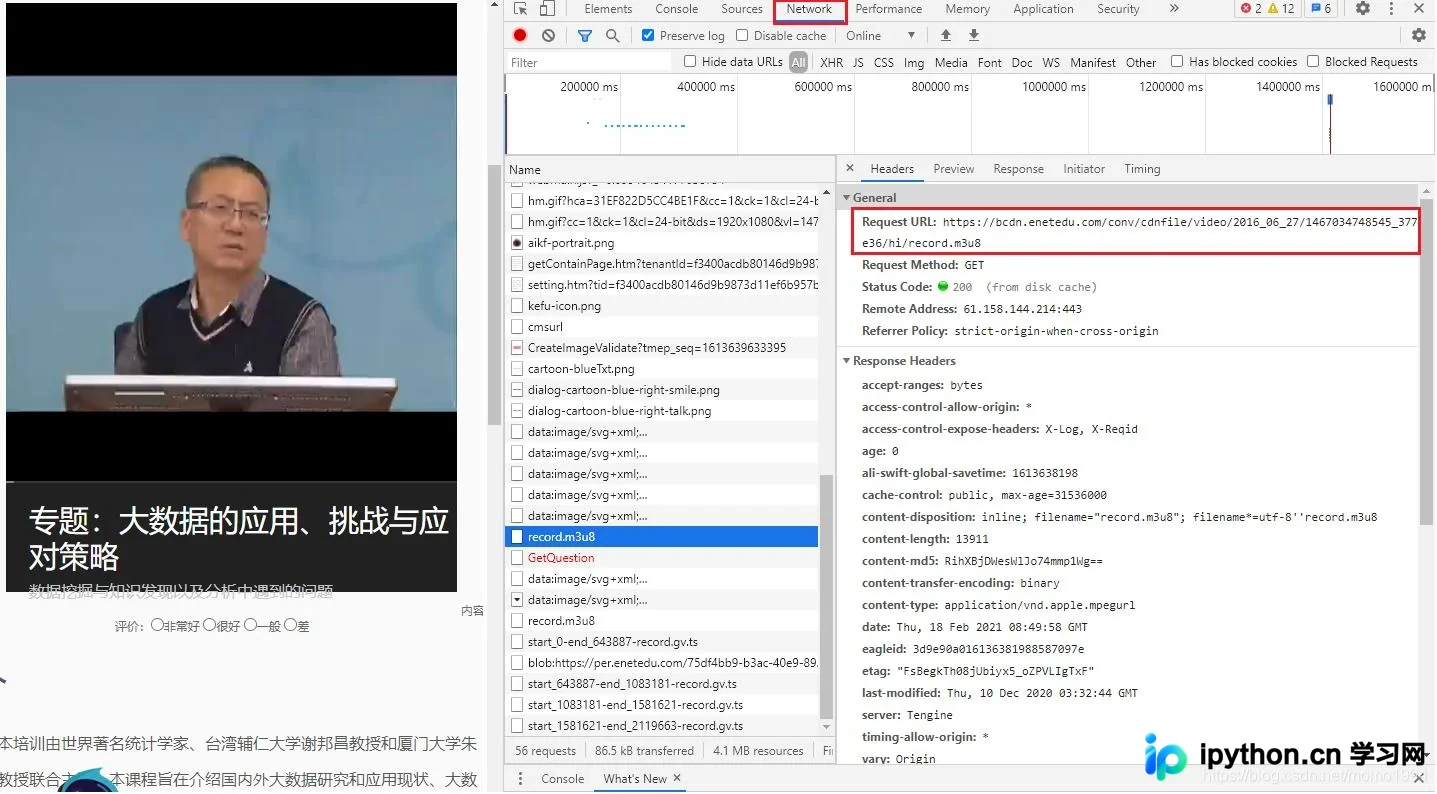
对比视频片段地址与.m3u8文件地址,可以发现两者前缀相同。视频实际下载地址由“标红的前缀地址”加上“.m3u8文件中列出的具体视频段文件名”拼接而成:
https://bcdn.enetedu.com/conv/cdnfile/video/2016_06_27/1467034852884_f5821b/hi/record.m3u8
https://bcdn.enetedu.com/conv/cdnfile/video/2016_06_27/1467034852884_f5821b/hi/start_643887-end_1083181-record.gv.ts
因此,可以将这部分公共前缀地址定义为变量:urlroot = https://bcdn.enetedu.com/conv/cdnfile/video/2016_06_27/1467034852884_f5821b/hi。
为了便于下载其他视频时动态调整,建议改为动态截取前缀的方式处理:
url = input("请输入m3u8文件地址:")
urlRoot=self.url[0:url.rindex('/')]
2.批量下载ts视频片段
利用上一步拼接好的完整地址,通过循环方式下载各个.ts视频片段。下载过程中,复用登录时创建的Session对象,以维持登录状态。
Session即会话,它允许服务器识别客户端身份。通俗理解,即将每个客户端与服务器的交互视为一个独立的“会话”。既然处于同一会话中,服务器便能确认该客户端是否已完成登录。相关代码如下:
client = requests.Session()
client.post(PostUrl,postData) #登录

resp = client.get(download_path) #下载
视频片段的拼接方法为:下载完第一个.ts片段后,直接在该文件末尾追加第二个.ts片段的内容,依此类推,而非新建文件写入。结合验证码登录流程,完整的代码如下:
import requests
from PIL import Image

import sys
import m3u8
import time
import os

#用户名-密码-验证码方式,登录
CaptchaUrl = "https://per.enetedu.com/Common/CreateImage" #获取验证码地址
PostUrl = "https://per.enetedu.com/AdminIndex/LoginDo"  #post登录信息地址

client = requests.Session()
username = '526257482@qq.com'
password = 'dashuju_9514'

qr_code = client.get(CaptchaUrl)
open('login.jpg', 'wb').write(qr_code.content) #将验证码图片保存至本地
img = Image.open('login.jpg')
img.show()  #打开图片

code = input("请输入验证码: \n") #输入验证码
postData = { #构造POST表单
 'email': username,
 'pwd': password,
 'validateCode': code,
 'x': '56',
 'y': '19'
}
result = client.post(PostUrl,postData) #向PostUrl提交表单

#循环下载ts视频
class VideoCrawler():

 def __init__(self,url):

  super(VideoCrawler, self).__init__()
  self.url=url
  self.final_path=r"D:\Download\Film"


 #下载并解析m3u8文件
 def get_url_from_m3u8(self,readAdr):
  print("正在解析真实下载地址...")
  with open('temp.m3u8','wb') as file:
   file.write(requests.get(readAdr).content)
  m3u8Obj=m3u8.load('temp.m3u8')
  print("解析完成")
  return m3u8Obj.segments

 def run(self):
  print("Start!")
  start_time=time.time()
  realAdr = self.url #m3u8下载地址
  urlList=self.get_url_from_m3u8(realAdr) #解析m3u8文件,获取下载地址
  urlRoot=self.url[0:self.url.rindex('/')]
  i=1
  outputfile=open(os.path.join(self.final_path,'%s.ts'%self.fileName),'wb')#初始创建一个ts文件,之后每次循环将ts片段的文件流写入此文件中从而不需要在去合并ts文件


  for url in urlList:
   try:
    download_path = "%s/%s" % (urlRoot, url.uri) #拼接地址
    resp = client.get(download_path) #使用拼接地址去爬取数据
    progess = i/len(urlList)#记录当前的爬取进度
    outputfile.write(resp.content) #将爬取到ts片段的文件流写入刚开始创建的ts文件中
    sys.stdout.write('\r正在下载:{},进度:{:.2%}'.format(self.fileName,progess))#通过百分比显示下载进度
    sys.stdout.flush()#通过此方法将上一行代码刷新,控制台只保留一行
   except Exception as e:
    print("\n出现错误:%s",e.args)
    continue#出现错误跳出当前循环,继续下次循环
   i+=1
  outputfile.close()
  print("下载完成!总共耗时%d s"%(time.time()-start_time))
  print("开始转换视频格式!")
  success = os.system(r'copy /b D:\Download\Film\{0}.ts D:\Download\Film\{0}.mp4'.format(self.fileName)) #ts转成mp4格式
  if (not success):
   print("格式转换成功!")
   os.remove(self.final_path+'\\'+self.fileName+".ts") #删除ts和m3u8临时文件
   os.remove("temp.m3u8")

if __name__=='__main__':
 m3u8_addr = input("输入m3u8文件下载地址:\n")
 crawler=VideoCrawler(m3u8_addr)
 crawler.fileName = input("输入文件名:\n")
 crawler.run()
 quitClick=input("请按Enter键确认退出!")
三、总结
上述代码实现了分段加载视频的爬取功能,但仍有许多细节有待完善,例如:
- 验证码环节可通过图像识别技术实现自动识别与填写。
- 通过解析视频地址自动获取.m3u8文件,可降低非计算机专业用户的使用门槛。
- 示例中的网站未对.m3u8文件进行加密,若涉及加密的.m3u8文件,则需增加解密步骤。
到此这篇关于Python爬虫爬取ts碎片视频+验证码登录功能的文章就介绍到这了,更多相关Python爬虫爬取视频内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















