


利用Pandas读取表格行数据判断是否相同的方法

发布时间:2026-10-14 |
3人浏览过
本文介绍如何使用Python的Pandas库自动化处理Excel表格数据。通过读取Excel文件,提取航线、舱位及价格信息,程序遍历每一行数据,找出数值相同的列索引,将对应的舱位字母合并,并提取返点价格。最终生成包含航线、合并舱位及价格的标准化结果列表,适用于供应链部门每周重复性数据清洗任务,替代手工操作。
描述:
临近下班时,公司供应链部门的同事提出需求,希望借助程序自动化解决每周需手工重复处理的Excel表格任务。尽管Excel是市场与运营人员常用的数据处理工具,但程序员通常更擅长编写代码而非直接使用Excel。为此,本文介绍Pandas库,它是一个基于Numpy的强大结构化数据分析工具集,广泛应用于数据挖掘、分析及数据清洗场景。
具体需求:
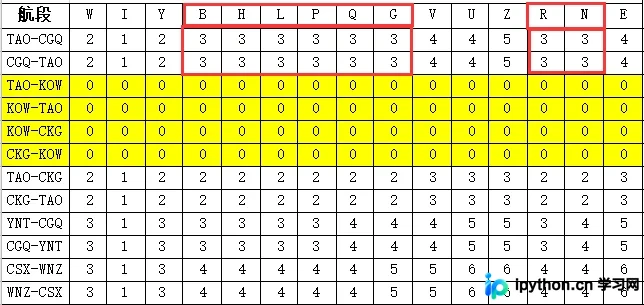
核心任务是从表格数据中找出数值相同的列,并将与这些数值对应的英文字母(舱位代码)合并在一起。
期望最终生成值:
TAOCGQ I 1
TAOCGQ WY 2
TAOCGQ BHLPQGRN 3
TAOCGQ VUE 4
TAOCGQ Z 5
代码实现:
import pandas as pd
df = pd.read_excel(r'E:\代码\tables_results\价格表.xlsx')
pd_result = df.to_dict(orient='split')
'''舱位信息列表['航线', 'W', 'I', 'Y', 'B', 'H', 'L', 'P', 'Q', 'G', 'V', 'U', 'Z', 'R', 'N', 'E', 'K']'''
cabin_list = pd_result['columns']
'''航线信息及价格列表 [['LHW-ZUH', 2.0, 0.0, 2.0, 2.0, 2.0, 3.0, 3.0, 3.0, 3.0, 3.0, 3.0, 3.0, 2.0, 2.0, 2.0, 0] ]'''
data_lists = pd_result['data']
for data in data_lists:
 for number in range(0,20):
  ''' 循环航线信息取出列表的索引id'''
  idxs = [i for i, x in enumerate(data) if x == number]
  if idxs: #索引列表
   news_data_list = []
   for idx in idxs: #循环索引列表
    news_data_list.append(cabin_list[idx])
   cabin_merge = ''.join(news_data_list) # 将多个舱位合并
   aviation_rebate = idxs[0] # 取出返点价格,因为有多个索引,只取第一个就行
   air_route = str(data[0]).split('-') #航线 LHW-ZUH
   dpt = air_route[0] # 出发城市
   arr = air_route[1] # 到达城市
   result = dpt + arr + ',' + cabin_merge + ',' + str(int(data[aviation_rebate]))
   '''
   最终结果:
   ['LHWZUH', 'IK', '0']
   ['LHWZUH', 'WYBHRNE', '2']
   ['LHWZUH', 'LPQGVUZ', '3']
   ['ZUHLHW', 'IK', '0']
   '''
   print(result.split(','))
程序执行结果:
['TAOCGQ', 'I', '1'] ['TAOCGQ', 'WY', '2'] ['TAOCGQ', 'BHLPQGRN', '3'] ['TAOCGQ', 'VUE', '4'] ['TAOCGQ', 'Z', '5']
总结
至此,关于利用Pandas读取表格行数据并判断相同项的方法介绍完毕。如需了解更多Pandas读取表格行数据的相关内容,可搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















