


Python使用Pandas自动填充Excel供应商简称

本文介绍如何利用Python的Pandas库处理包含数万条记录的Excel文件,自动根据预设的供应商全称与简称对应关系填充数据。通过构建字典映射并遍历数据列,实现批量填写简称的功能。文章同时探讨了字符串匹配中因括号、空格等细微差异导致的匹配失败问题,为后续优化提供思路。
Python使用Pandas自动填充Excel供应商简称
在处理Excel数据时,常遇到需要根据供应商全称自动填充简称列的需求。当数据量达到数万条时,依赖Excel手动筛选和填充效率极低。为此,本文采用Python中的pandas模块读取并处理Excel文件,以自动化方式完成这一任务。
1、需求
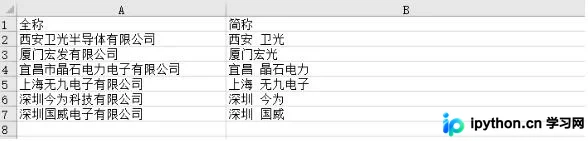
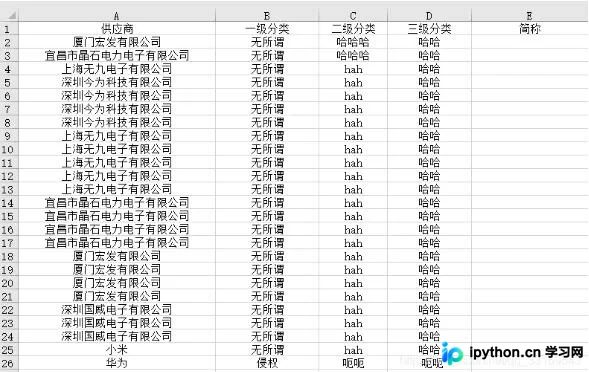
核心目标是依据预先整理好的“对应关系.xlsx”文件,自动将“待处理文件.xlsx”中供应商全称对应的简称填入指定列。
脚本实现思路
2.脚本思路
首先,利用pandas读取“对应关系.xlsx”文件,并将其内容转换为字典对象。该字典以供应商的全称作为键(key),以简称作为值(value)。
接着,读取“待处理文件.xlsx”,通过列标题定位到包含供应商全称的列。遍历该列中的每一个全称,在字典中查找对应的键值,并将结果写入待处理文件中对应的简称列。此处暂假设两份文件中的供应商全称完全一致,若存在细微差异的处理逻辑将在后续文章中补充。
3.代码
Python代码实现
# -*- coding: utf-8 -*-
"""
Created on Thu Mar 4 21:25:05 2021
@author: ruofei
"""

import pandas as pd


#填写待处理文件和对应关系的excel文件路径
#注意:脚本运行时需保证被使用excel文件处于关闭状态
file1 = r'待处理文件.xlsx'
file2 = r'对应关系.xlsx'


#填写待处理文件中 全称所在的列名和简称要放置的列名
qc1="供应商"
jc1="简称"

#填写对应关系中  全称所在的列数和简称所在的列数
qc2="全称"
jc2="简称"


#填写读取excel文件的sheet表名
sheet1="Sheet1"
sheet2="Sheet1"

#--------------------*-------------*--------------*---------------------
#--------------------*-------------*--------------*---------------------
data1 = pd.read_excel(file1, sheet_name = sheet1)
data2 = pd.read_excel(file2, sheet_name = sheet2)

#print("输出表格所有")
#print(data1)

row1 = data1.shape[0]#行数
col1=data1.shape[1]#列数

row2 = data2.shape[0]#行数
col2=data2.shape[1]#

#print("表格文件有"+str(row1)+"行,"+str(col1)+"列")

duiying=dict()

#生成对应关系的字典
for i in range(row2):

  quancheng=data2.loc[i,qc2]
  jiancheng=data2.loc[i,jc2]

  duiying[quancheng]=jiancheng


  #print(quancheng)

#company1=data1.loc[0][0]
#company2=data1.loc[1][0]
#print("公司一为"+str(company1)+"\n"+"公司二为"+str(company2))

for i in range(row1):

  a=data1.loc[i,qc1]
  #[qc1-1]
  #print(str(a))

  jiancheng=duiying.get(a)
  if a in duiying.keys():

    #print(jiancheng)
    data1.loc[i,jc1]=jiancheng
  else:


    #此处修改没有简称赋予值,若赋予全称值则=a,若为空则="  "
    data1.loc[i,jc1]=a

data1.to_excel('处理好的文件.xlsx',sheet_name='Sheet1')
功能效果与注意事项
4.实现功能
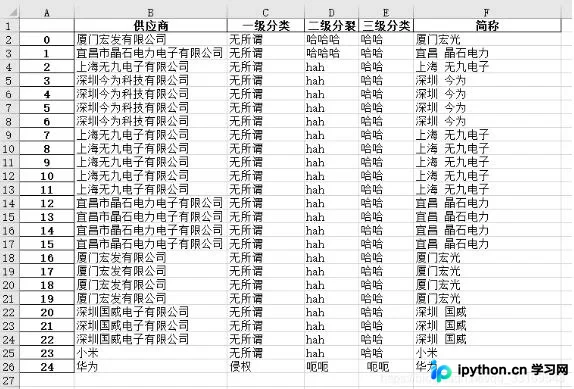
脚本成功根据预设的对应关系表,自动填充了待处理文件中简称列的空白。对于在对应关系中未找到简称的公司,脚本将其全称直接填入简称列。例如,若“小米”和“华为”在对应关系中无记录,则其简称列将显示为全称本身。
5.存在问题
在处理大规模数据时,虽然大部分情况正常,但仍存在匹配失败的问题。例如,若对应关系中的全称为“(中国)茅台公司”,而待处理文件中缺少括号、括号中英文不同或空格数量不一致,pandas会将这些视为不同的字符串,导致字典查询返回None。此类字符串标准化问题将在下一篇文章中详细讨论解决方案。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















