


Python基于Pyppeteer生成PDF文件实战:解决懒加载图片丢失问题

本文介绍如何使用Python库Pyppeteer将网页批量转换为PDF文件。通过对比截图与PDF导出功能,重点解析微信公众号文章因懒加载导致图片丢失的问题,并提供通过JavaScript模拟滚动页面以触发图片加载的完整解决方案与代码示例。
Pyppeteer 是什么
在深入介绍 Pyppeteer 之前,有必要先了解其前身 Puppeteer。Puppeteer 是谷歌官方推出的一个 Node.js 库,通过 DevTools 协议控制 headless Chrome 浏览器。借助 Puppeteer,开发者可以直接操控 Chrome 浏览器,模拟绝大多数用户操作行为。
Headless Chrome 指的是 Chrome 浏览器的无界面运行形态,即在没有图形用户界面的服务器环境中运行浏览器。
Pyppeteer 则是 Puppeteer 的 Python 非官方实现版本。该库由一位日本工程师基于 Puppeteer 的部分功能开发而成,旨在为 Python 用户提供类似的浏览器自动化能力。
Pyppeteer 采用了 Python 的 async/await 异步机制,因此要求运行环境为 Python 3.5 或更高版本。
Pyppeteer能做什么
凡是可以通过 Chrome 浏览器手动完成的操作,理论上都可以利用 Pyppeteer 实现自动化。具体应用场景包括:
- 生成页面截图
- 生成PDF文件
- 抓取单页面应用(SPA)并生成预先渲染的内容
- 从网站抓取所需数据内容
- 自动提交表单、UI 测试、键盘输入模拟等
截图
例如,若需将页面生成截图,可直接调用 page.screenshot 方法。
import asyncio
from pyppeteer import launch

async def main():
 browser = await launch()
 page = await browser.newPage()
 await page.goto('https://foofish.net')
 await page.screenshot({'path': 'example.png'})
 await browser.close()

asyncio.get_event_loop().run_until_complete(main())
截图功能在海报分享等场景中应用广泛。有赞工程师曾分享过使用 Puppeteer 制作海报的文章,其性能表现优于 Canvas 方案。
相比之下,将网页转换为 PDF 的应用场景更为广泛。例如,批量导出网站博客、专栏或公众号文章为 PDF 以便离线阅读;又如近期一个医疗项目中,需要将用户填写的资料批量导出为 PDF 格式,最终选择了 Pyppeteer 实现。
导出PDF
导出 PDF 只需直接调用 page.pdf 方法即可,代码实现非常简洁。
import asyncio
from pyppeteer import launch

async def main():
 browser = await launch()
 page = await browser.newPage()
 await page.goto('https://foofish.net')
 await page.pdf({
  "path": "example.pdf", "format": 'A4'})
 await browser.close()

asyncio.get_event_loop().run_until_complete(main())
接下来,我们以公众号文章为例,演示如何将 HTML 页面制作成 PDF 文件。
公众号链接导出PDF示例
首先安装 pyppeteer 库。
pip install pyppeteer
任意选取一篇公众号文章链接作为测试目标。
url = "https://mp.weixin.qq.com/s/6VBXs19icV0O5hT7cHYwgw"
基础实现代码如下:
 browser = await launch(
  options={'headless': True,
     'args': ['--no-sandbox',
       '–disable-gpu',
       '–disable-dev-shm-usage',
       '–disable-setuid-sandbox',
       '–no-first-run',
       '–no-zygote',
       '–single-process'
       ]}, )
 page = await browser.newPage()
 url = "https://mp.weixin.qq.com/s/6VBXs19icV0O5hT7cHYwgw"
 await page.goto(url)
 file_name = "test.pdf"
 await page.pdf({"path": file_name, "format": 'A4'})
 await browser.close()
首次运行时,程序会自动下载 Chromium 浏览器(Chrome 的开源版本),该过程可能需要几分钟时间。
[W:pyppeteer.chromium_downloader] start chromium download.
Download may take a few minutes.
100%|██████████| 127496521/127496521 [00:20<00:00, 6268578.80it/s]
[W:pyppeteer.chromium_downloader]
chromium download done.
[W:pyppeteer.chromium_downloader] chromium extracted to: C:\Users\lzjun\AppData\Local\pyppeteer\pyppeteer\local-chromium\575458
执行完成后,我们可以预览生成的 PDF 文件。
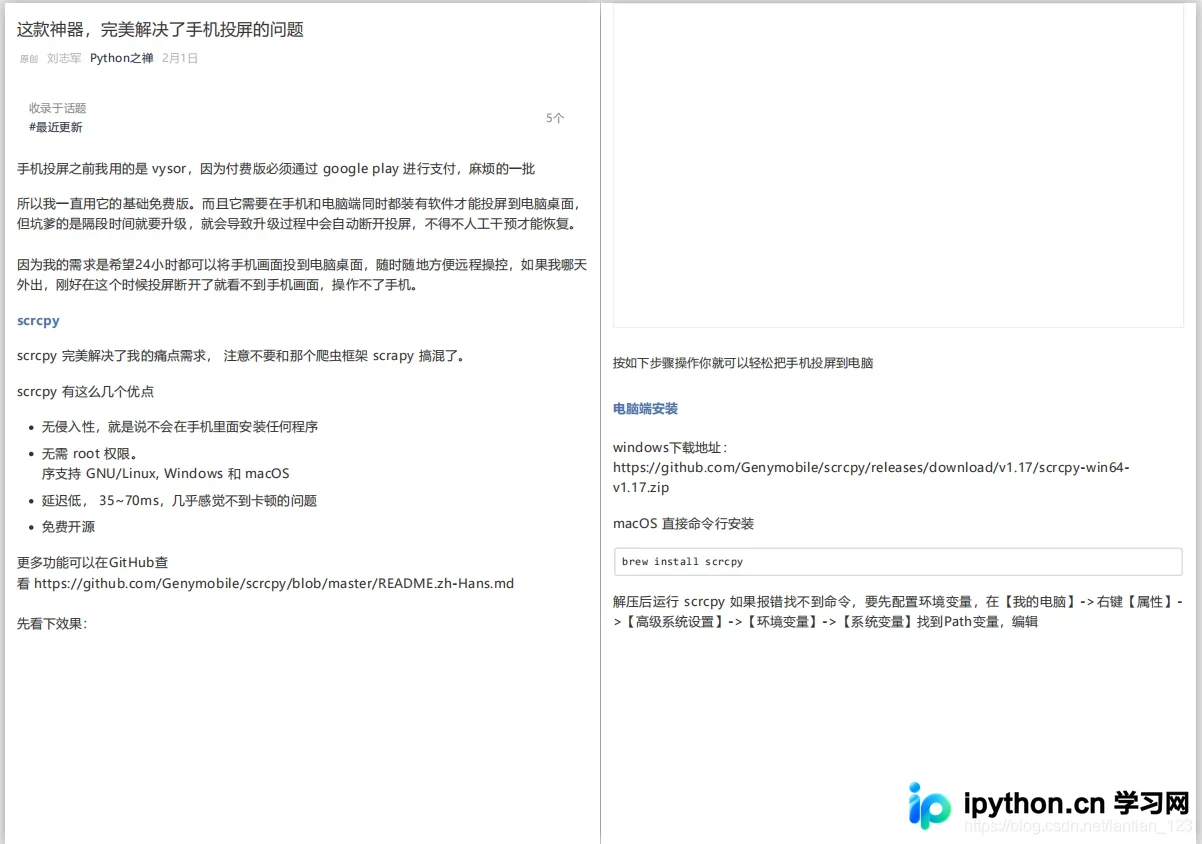
与原文链接对比后发现,文章中的图片全部丢失。
经分析,原因是页面源代码中 img 标签缺少 src 属性,仅包含 data-src 属性。默认情况下,图片无法直接显示。图片之所以能在浏览器中正常展示,是因为有 JavaScript 脚本动态修改了 DOM 元素,将其替换为 <img src='xxxx'> 形式。
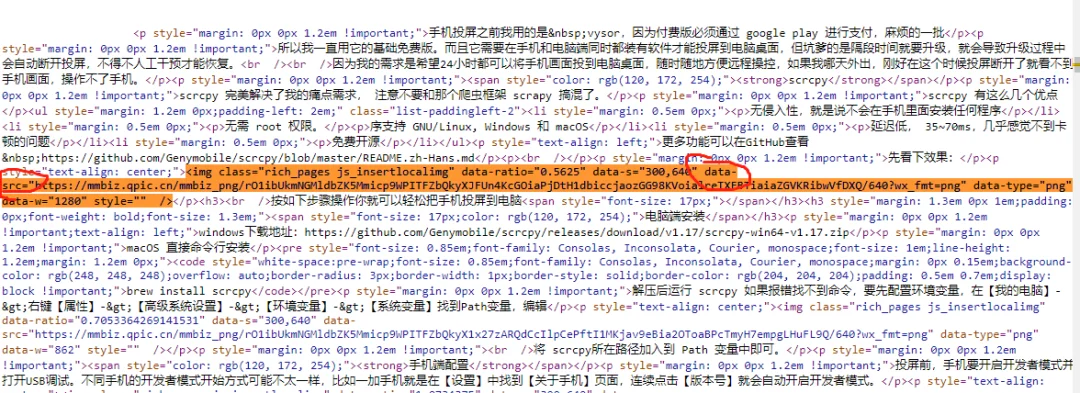
该网页采用了懒加载技术来展示图片。所谓懒加载,即图片不会一次性全部下载,而是根据当前浏览位置动态加载对应图片。这种机制能提高页面响应速度并减轻服务器负载。
因此,我们可以通过 JavaScript 代码模拟真人浏览行为,即不断滚动鼠标向下滑动,从而触发图片的动态加载。
最终,完整代码调整为如下形式:
async def main():
    browser = await launch()
    page = await browser.newPage()
    url = "https://mp.weixin.qq.com/s/6VBXs19icV0O5hT7cHYwgw"
    await page.goto(url)
    await page.evaluate('''async () => {
                    await new
                Promise((resolve, reject) => {
                    var
                totalHeight = 0;
                var
                distance = 100;
                var
                timer = setInterval(() => {
                    var
                scrollHeight = document.body.scrollHeight;
                window.scrollBy(0, distance);
                totalHeight += distance;

                if (totalHeight >= scrollHeight){
                clearInterval(timer);
                resolve();
                }
                }, 100);
                });
        }''')
    await page.pdf({
        "path": "test.pdf", "format": 'A4'})
    await browser.close()

if __name__ == '__main__':
    asyncio.get_event_loop().run_until_complete(main())
将 JavaScript 代码封装为字符串,作为参数传递给 page.evaluate 函数。该脚本的作用是不断滚动页面直至底部,从而确保整个页面的图片全部加载完成。
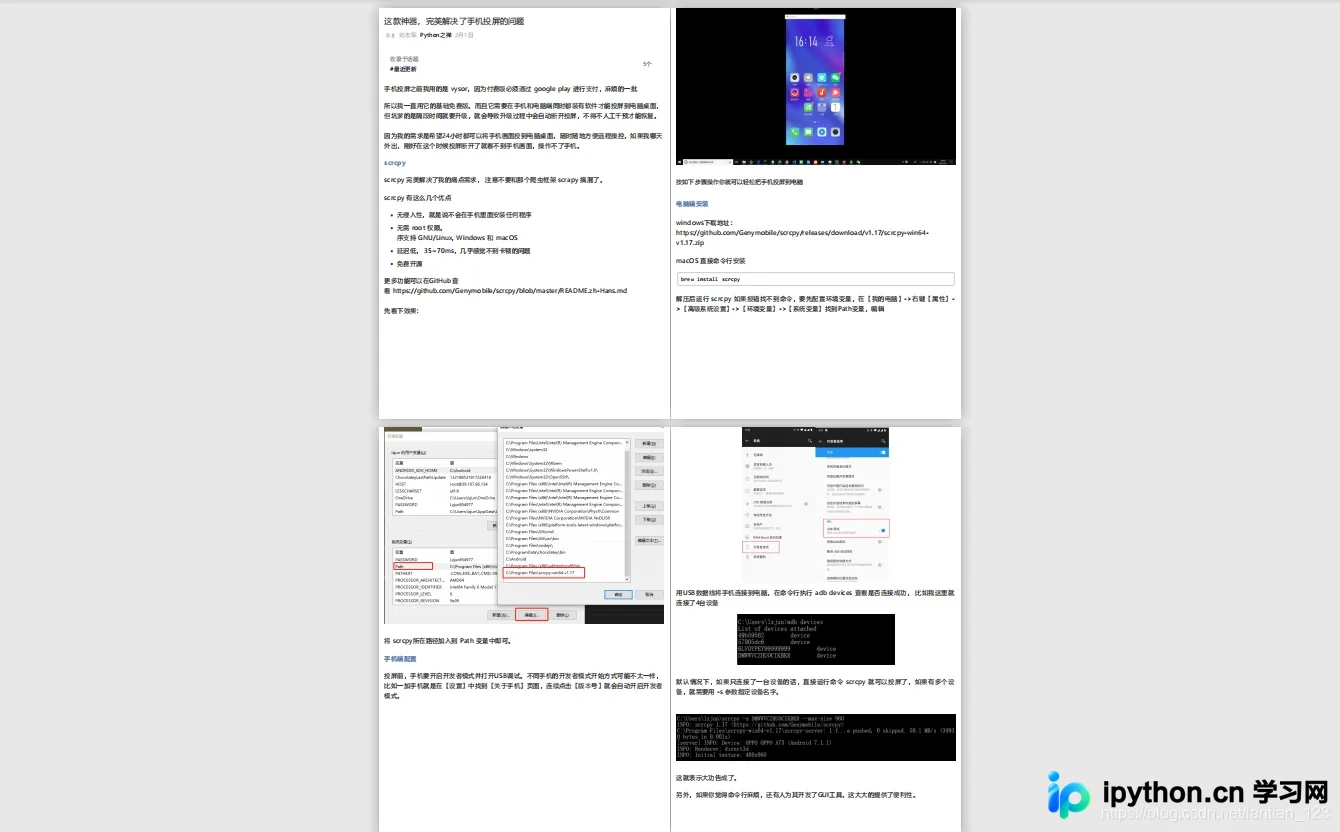
最终效果良好,生成的 PDF 与原页面样式保持一致。
在 Pyppeteer 的实践应用过程中,我们也遇到了不少坑,但均已逐一解决。这本身可以单独写成一篇长文。如果您在使用过程中遇到任何问题,欢迎与我交流。
以上就是python基于pyppeteer制作PDF文件的详细内容,更多关于python pyppeteer制作PDF文件的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















