


Python模拟网站登录的多种实现方式详解

本文详细介绍Python实现网站模拟登录的几种主流方法。包括通过浏览器手动获取Cookie进行模拟请求、分析Form Data与Request Payload两种数据提交格式的差异,以及利用requests.Session保持会话状态。此外,还讲解了使用Selenium库调用真实浏览器(Chrome/Firefox)进行自动化登录的操作步骤与注意事项。
利用已有的Cookie进行登录
通过浏览器执行登录操作,提取浏览器中存储的Cookie信息,随后在代码中使用这些Cookie完成登录验证。
以博客园平台为例,首先需要登录个人账号。访问随笔列表页面后,打开浏览器开发者工具的控制台,即可查看到登录后浏览器保存的Cookie数据。
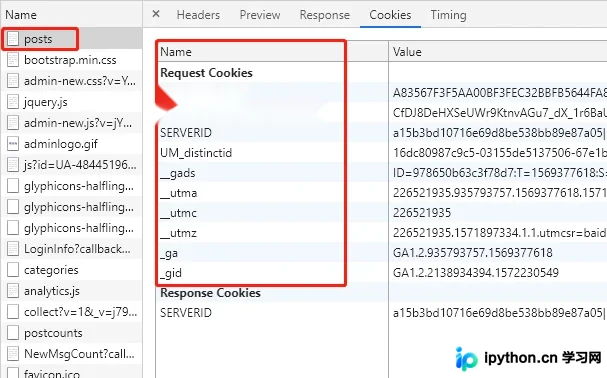
过滤掉用于数据统计和分析的Cookie字段,剩余的关键Cookie主要包括.CNBlogsCookie和.Cnblogs.AspNetCore.Cookies,这两项通常是维持登录状态所必需的。
# _ga google分析 cookie
# UM_distinctid 友盟cookie
# CNZZxxx CNZZcookie
# __utma,__utmc,__utmz google统计网站
# Hm_lvt_xxx 百度统计网站
import urllib.request

url = 'https://i.cnblogs.com/posts'

user_agent = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.90 Safari/537.36'

#浏览器登录后得到的cookie,也就是刚才复制的字符串
cookie_str = '.CNBlogsCookie=xxx; .Cnblogs.AspNetCore.Cookies=xxx'

headers = {
 'User-Agent': user_agent,
 'cookie':cookie_str
}

req = urllib.request.Request(url,headers=headers)
resp = urllib.request.urlopen(req).read().decode('utf-8')

print(resp)
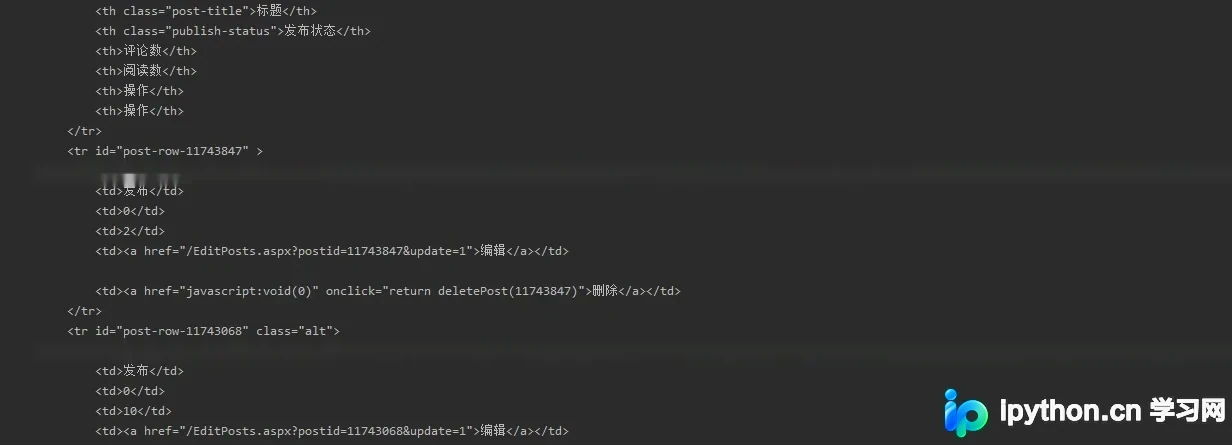
通过提交表单获取Cookie
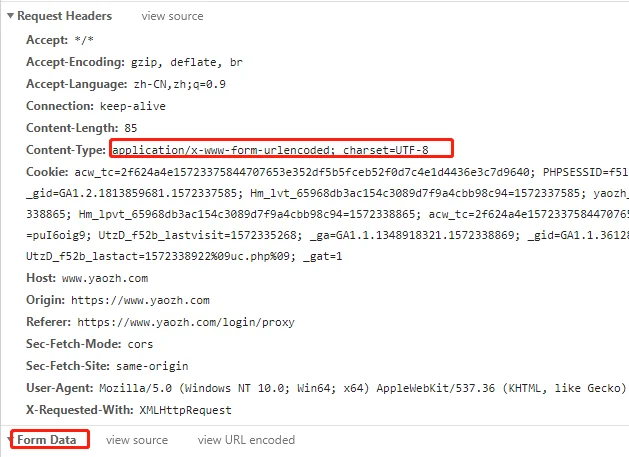
大多数网站的登录表单采用form data格式提交数据,但部分现代网站已改用request payload方式,即以JSON格式传输参数。
以药智网为例,其登录接口使用form data格式。
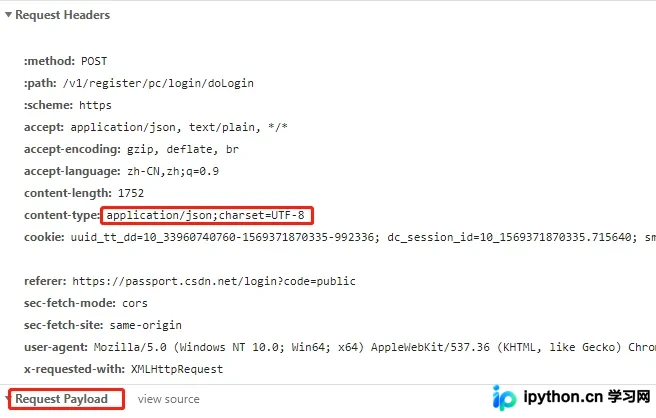
以博客园为例,其登录接口使用request payload格式。
Form Data提交方式
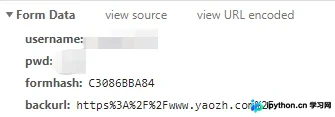
由于博客园登录涉及拖动验证,此处暂不演示。以药智网为例,通过控制台观察可知,登录请求需传递特定的表单参数,且采用form data格式。模拟登录后,程序获取返回的Cookie,进而访问登录后的个人中心页面。
import urllib.request
import http.cookiejar

url = 'https://www.yaozh.com/login'

user_agent = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.90 Safari/537.36'

# formData数据
data = {'username': '用户名',
  'pwd': '密码',
  'formhash': 'C3086BBA84',
  'backurl': 'https%3A%2F%2Fwww.yaozh.com%2F'}

post_data = urllib.parse.urlencode(data).encode('utf-8')

# 请求头设置
headers = {
 'User-Agent': user_agent
}

# 构造登陆请求
req = urllib.request.Request(url, headers=headers, data=post_data)

# cookie
cookie = http.cookiejar.CookieJar()

# 构造一个opener携带登录后的cookie
opener = urllib.request.build_opener(urllib.request.HTTPCookieProcessor(cookie))

# 发送登陆请求
resp = opener.open(req)

print(resp)

# 登录后个人中心
url = 'https://www.yaozh.com/member/'

# 构造访问请求
req = urllib.request.Request(url, headers=headers)

resp = opener.open(req).read().decode('utf-8')

print(resp)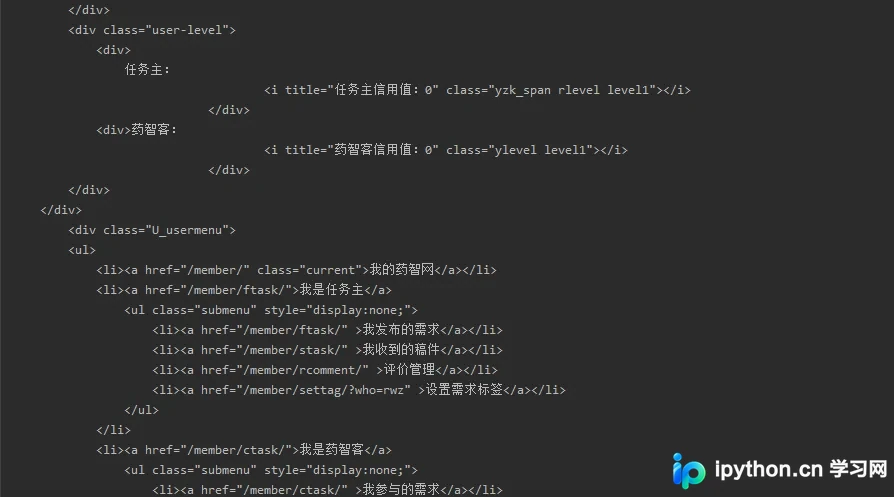
Request Payload提交方式
若登录接口要求使用request payload,需将参数字典转换为JSON字符串,并在请求头中显式设置Content-Type为application/json。
import json
...

data = {'loginType': '1',
  'pwdOrVerifyCode': '密码',
  'userIdentification': '账号',
  'uaToken': '',
  'webUmidToken':''}

headers = {
 'Content-Type': 'application/json;charset=UTF-8',
 'User-Agent': user_agent
}


req = urllib.request.Request(url, headers=headers, data=json.dumps(data))
...
使用Session保持登录状态
利用Python requests库提供的Session对象,可以自动管理Cookie和会话信息,从而简化登录后的多次请求操作。
import requests

url = 'https://www.yaozh.com/login'

user_agent = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.90 Safari/537.36'

# formData数据
data = {'username': 'chenjy1225',
  'pwd': '19931225yjy',
  'formhash': 'C3086BBA84',
  'backurl': 'https%3A%2F%2Fwww.yaozh.com%2F'}


#构造Session
session = requests.Session()

# 发送post请求
resp = session.post(url, data)

# 登录后个人中心
url = 'https://www.yaozh.com/member/'

# 发送请求访问个人中心
resp = session.get(url).content.decode('utf-8')

print(resp)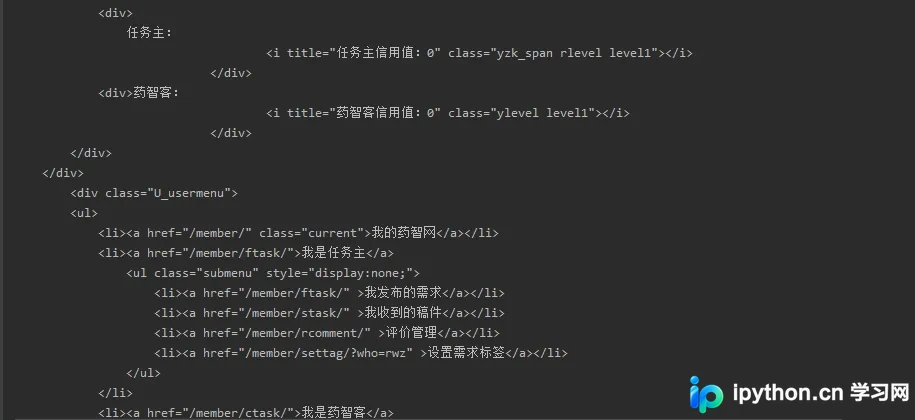
调用浏览器进行自动化登录
除了代码模拟,还可以直接在程序中调用浏览器访问目标网站。在Python中,借助Selenium库可以轻松实现浏览器控制,支持Chrome、Firefox等多种浏览器。 注:早期常用的PhantomJS已被Python官方弃用。
UserWarning: Selenium support for PhantomJS has been deprecated, please use headless versions of Chrome or Firefox instead warnings.warn('Selenium support for PhantomJS has been deprecated, please use headless '
Firefox浏览器对应的驱动为geckodriver
Chrome浏览器对应的驱动可通过国内镜像站下载,例如:chrnpm.taobao.org/mirrors/chromedriveromedriver
1. 安装Selenium库,下载Firefox浏览器及其对应的驱动文件。
2. 将下载的geckodriver可执行文件放置于Firefox浏览器的安装目录中。
3. 将Firefox浏览器的安装路径添加到系统环境变量path中。
4. 重启集成开发环境(IDE)以生效配置。
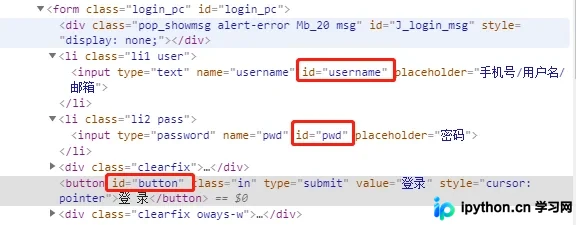
定位登录页面中输入框及登录按钮的元素ID。
from selenium import webdriver
import time

# 新建selenium浏览器对象,后面是geckodriver.exe下载后本地路径
browser = webdriver.Firefox()

url = 'https://www.yaozh.com/login'

# 浏览器访问登录页面
browser.get(url)

# 等待3s用于加载脚本文件
browser.implicitly_wait(3)

# 输入用户名
username = browser.find_element_by_id('username')
username.send_keys('chenjy1225')

# 输入密码
password = browser.find_element_by_id('pwd')
password.send_keys('19931225yjy')

# 点击登录按钮
login_button = browser.find_element_by_id('button')
login_button.submit()

# 网页截图
browser.save_screenshot('screenshot.png')

# 强制等待5s,等待登录后的跳转
time.sleep(5)

url = 'https://www.yaozh.com/member/'

browser.get(url)

# 网页截图个人中心
browser.save_screenshot('screenshot1.png')

# 关闭浏览器
browser.quit()
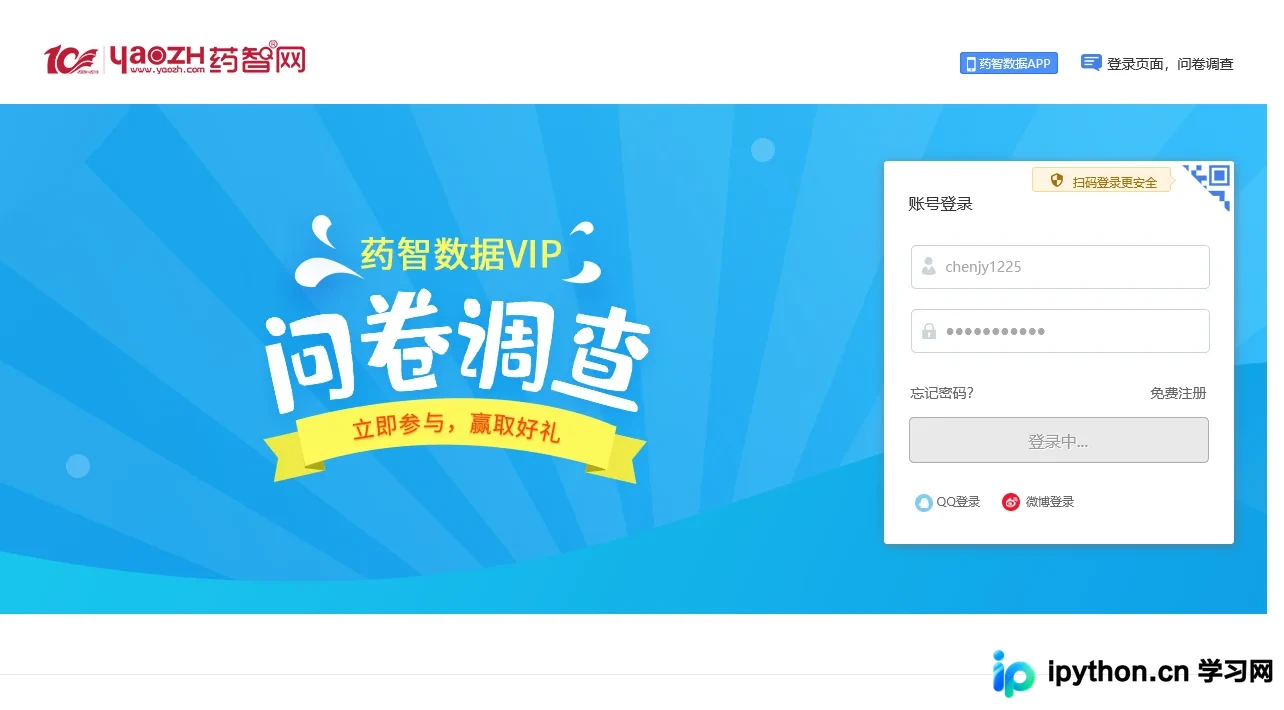
截图文件screenshot.png:
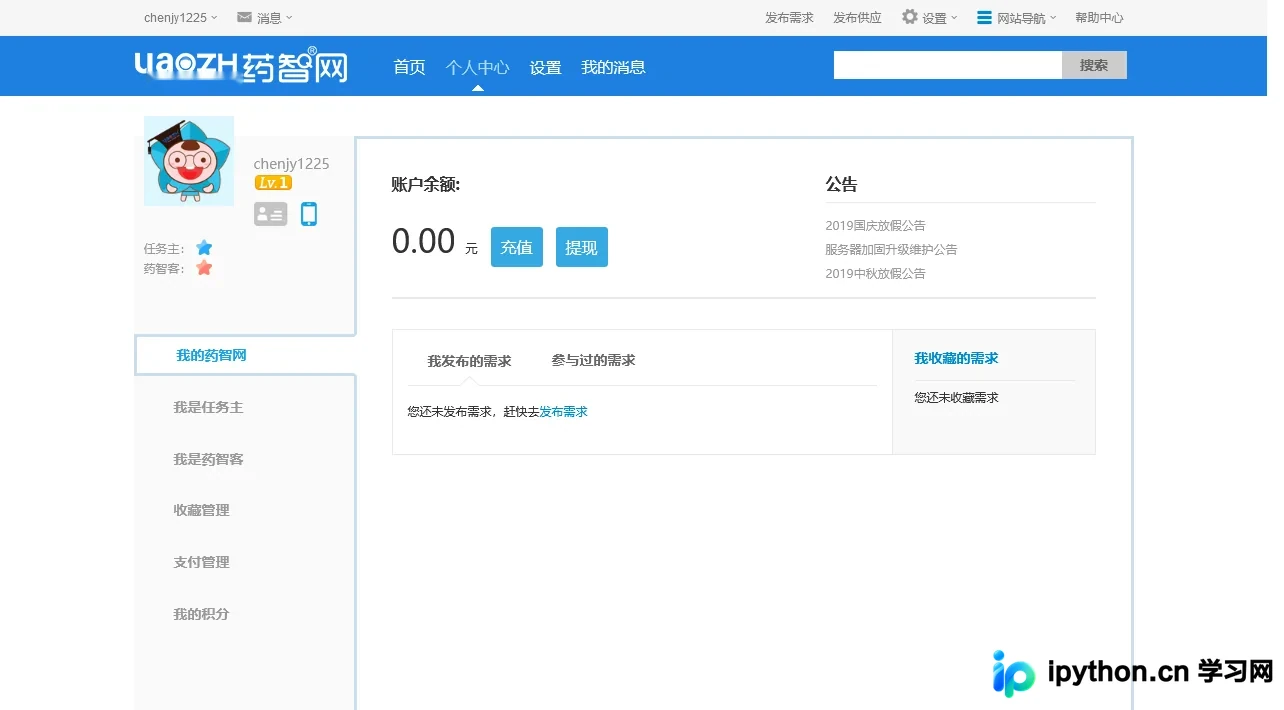
截图文件screenshot1.png:
以上即为Python模拟网站登录的完整示例,更多相关技术细节请参阅本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















