


Python关联规则分析详解:从Apriori算法到mlxtend实战

本文深入解析Python中的关联规则分析,涵盖支持度、置信度和提升度等核心概念,详细阐述Apriori算法的迭代逻辑。通过mlxtend库的完整代码示例,演示数据预处理、频繁项集挖掘及关联规则生成的全过程,帮助读者掌握从理论到实战的应用技能。
1. 关联规则
在数据挖掘的宣传案例中,常提及“啤酒与尿布”的故事:据称沃尔玛通过分析顾客购买记录发现,许多购买啤酒的顾客也会同时购买婴儿尿布。超市据此调整货架布局,将两者相邻摆放,最终使两类商品销量均显著增长。这一现象背后的解释是,刚有了新生儿的父亲在选购啤酒时,往往顺手采购婴幼儿用品。
无论该案例是否完全真实,这种通过分析顾客购买记录来挖掘商品间联系的方法,正是关联规则分析法(Association Rules)。
关联规则分析也常被称为购物篮分析,其核心目的是分析数据集中各项之间的关联关系。
1.1 基本概念
- 项集(Itemset):指项(item)的集合。例如,集合{牛奶、麦片、糖}构成一个3项集,可视为购买记录中物品的集合。
- 频繁项集:指频繁出现的项的集合。如何定义“频繁”?通常采用支持度和置信度两个指标来计算比例值进行判定。
- 支持度(Support):指共同出现的项在整体项中的比例。以购买记录为例,若有100条记录,其中商品A和B同时出现的记录有50条,则A和B这个2项集的支持度为50%。
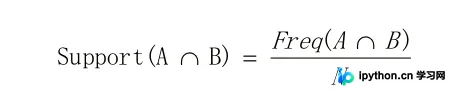
- 置信度(Confidence):指在购买A的前提下再购买B的条件概率。根据贝叶斯公式,其计算方式如下:
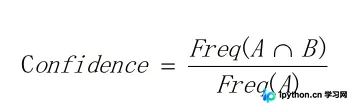
提升度(Lift):用于判断产生规则的实际价值,即使用规则后商品出现的次数是否高于商品单独出现的频率。提升度衡量了购买X对购买Y概率的提升作用。从公式可见,如果X和Y相互独立,提升度为1;提升度越大,说明X->Y的关联性越强。
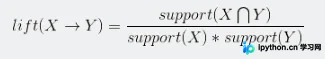
1.2 关联规则Apriori算法
关联规则分析的主要步骤如下:
- 1. 发现频繁项集
- 2. 找出关联规则
Apriori算法是经典的关联规则挖掘算法,其目标是找到最大的K项频繁集。该算法从寻找1项集开始,通过最小支持度阈值进行剪枝,依次寻找2项集、3项集,直到没有更多的项集为止。
下面通过一个案例图解说明:
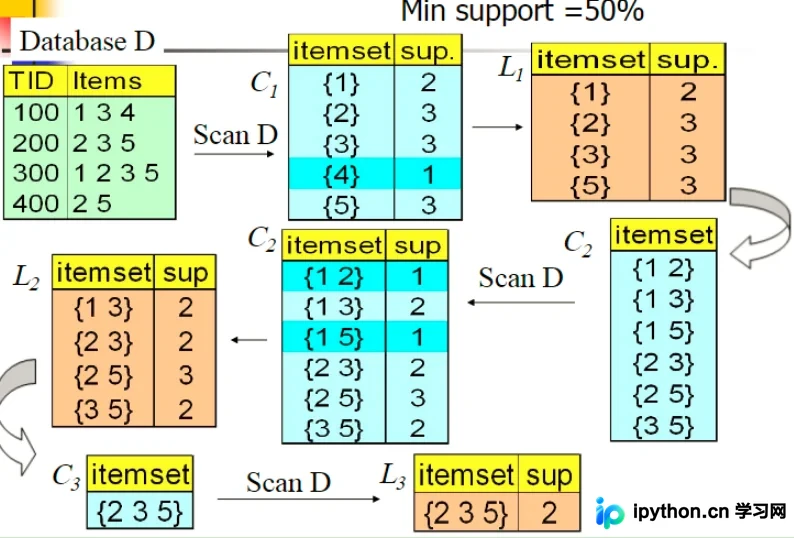
- 图中包含4条记录,涉及的项有1、2、3、4、5等若干项。
- 首先计算1项集的支持度(C1),可以看出项4的支持度低于最小支持阈值,因此被剪枝(L1)。
- 接着从1项集生成2项集并计算支持度(C2),可以看出组合(1,5)和(1,2)的支持度低于最小支持阈值,因此被剪枝(L2)。
- 从2项集生成3项集时,(1,2,3)、(1,2,5)和(2,3,5)中,只有(2,3,5)满足要求。
- 当没有更多的项集可以生成时,迭代停止。
2. mlxtend实战关联规则
目前scikit-learn库中并未实现关联规则算法,这里介绍另一个Python库mlxtend。
2.1 安装
pip install mlxtend
2.2 简单的例子
首先查看数据集:
import pandas as pd

item_list = [['牛奶','面包'],
    ['面包','尿布','啤酒','土豆'],
    ['牛奶','尿布','啤酒','可乐'],
    ['面包','牛奶','尿布','啤酒'],
    ['面包','牛奶','尿布','可乐']]

item_df = pd.DataFrame(item_list)
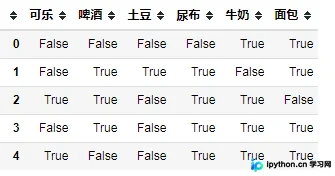
数据格式处理:传入模型的数据需要转换为布尔值(bool)格式。
from mlxtend.preprocessing import TransactionEncode

te = TransactionEncoder()
df_tf = te.fit_transform(item_list)
df = pd.DataFrame(df_tf,columns=te.columns_)
- 计算频繁项集:
from mlxtend.frequent_patterns import apriori

# use_colnames=True表示使用元素名字,默认的False使用列名代表元素, 设置最小支持度min_support
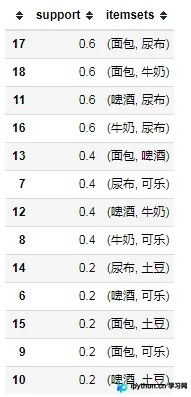
frequent_itemsets = apriori(df, min_support=0.05, use_colnames=True)

frequent_itemsets.sort_values(by='support', ascending=False, inplace=True)

# 选择2频繁项集
print(frequent_itemsets[frequent_itemsets.itemsets.apply(lambda x: len(x)) == 2])
- 计算关联规则:
from mlxtend.frequent_patterns import association_rules

# metric可以有很多的度量选项,返回的表列名都可以作为参数
association_rule = association_rules(frequent_itemsets,metric='confidence',min_threshold=0.9)

#关联规则可以提升度排序
association_rule.sort_values(by='lift',ascending=False,inplace=True)
association_rule
# 规则是:antecedents->consequents
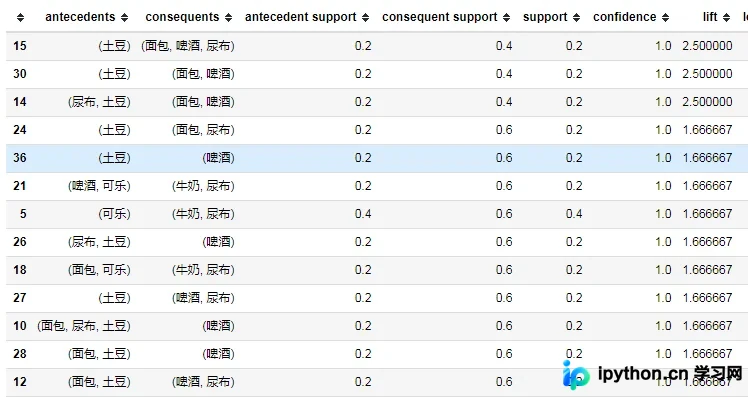
筛选出关联规则后,若按提升度排序,最高提升度的规则可能属于常识范围内,此类规则的实际价值不高。因此,我们需要根据业务特点对产生的规则进行筛选,例如开篇提到的“啤酒->尿布”这种看似完全不同的品类之间的关联。
笔者近期利用关联规则分析用户的体检报告记录,得出了关于各病症之间有意义的关联,如并发症、不同病症相互影响等情况。
3. 总结
本文介绍了关联规则的基本概念和经典算法Apriori,以及Python实现库mlxtend的使用方法。
总结如下:
- 关联规则用于分析数据集中各项之间的关联关系,可回顾“啤酒和尿布”的故事。
- 三个重要概念:支持度、置信度和提升度。
- Apriori算法通过迭代先找1项集,用支持度过滤项集,逐步找出所有k项集。
- 使用置信度或提升度来选择满足要求的规则。
- mlxtend要求将数据转换成bool值后方可使用。
以上就是详解Python关联规则分析的详细内容,更多关于Python关联规则分析的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















