


Python列表推导式中for/if连写与分开写的差异及遍历删除陷阱

发布时间:2026-10-15 |
2人浏览过
本文通过实验对比Python列表推导式中for/in/if连写与分开写的行为差异,指出连写时隐式类型转换需配合append使用。同时深入解析在遍历列表时直接remove元素导致的索引跳跃陷阱,并给出使用切片拷贝进行安全遍历删除的解决方案。
具体表现如下:
links.extend(link for link in get_links(html) if re.match(link_regex, link))
# 上面的语句分开写,如下
# 但下面需要使用links.append,如果依然使用links.extend会出现错误的结果
for link in get_links(html):
  if re.match(link_regex, link):
     links.append(link)
我们可以借助ipython环境进行实际测试:
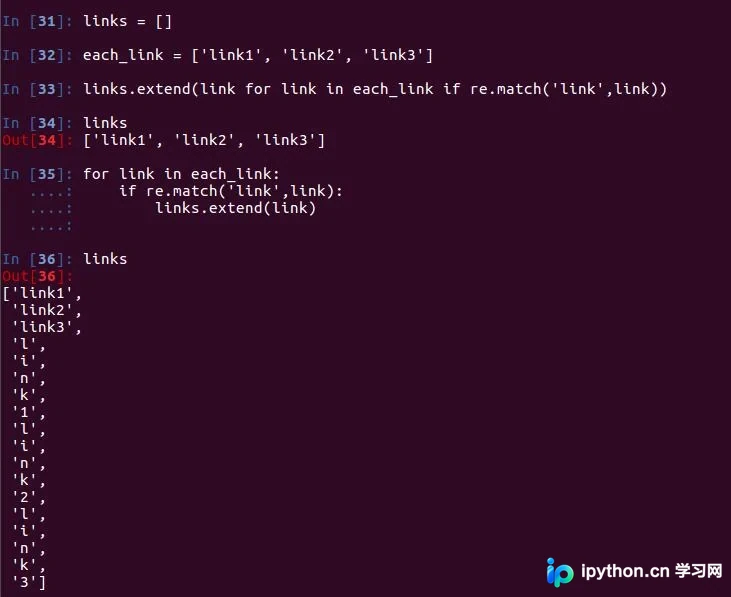
观察上述运行结果可以发现,在列表推导式中采用for/in/if连写的方式,系统会隐式地将link从字符串类型转换为列表类型;而若将语句分开书写,Python不会自动执行这种转换,因此必须显式使用append方法将整个字符串追加到列表中。
补充说明:Python中for i in list循环的常见陷阱
d = [1,2,3,4,5]
for i in d:
  d.remove(i)
print d
最终输出结果为:
[2, 4]这一陷阱较为隐蔽,在使用白盒测试方法时被发现。其根本原因在于:执行d.remove(d[0])后,迭代器索引i自动指向原列表的d[1]位置,但此时列表d的结构已变为d[2,3,4,5],导致i=d[1]实际指向了元素3,从而跳过了元素2。
由此可见,深入理解Python的底层实现机制至关重要。
推荐的解决代码如下:
d = [1,2,3,4,5]
for i in d[:]:
  d.remove(i)
print d
通过该方式即可实现遍历过程中安全地删除元素。
以上为个人经验总结,旨在提供参考。欢迎读者提出指正或补充未考虑周全之处。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















