


大模型是什么意思?通俗解释其定义与核心特征

我们每天都在和一种新的“智能”打交道:它能写诗、能编程,甚至能像真人一样和你闲聊。很多人听到“大模型”这个词,第一反应是深奥的数学公式或昂贵的显卡集群。但如果剥离掉这些技术外壳,大模型本质上是一个读过几乎所有书、记住了所有规律,并能根据语境猜出下一句话的“超级大脑”。
它不是搜索引擎,不直接检索答案;它更像是一个拥有惊人记忆力和联想力的学者,通过海量的阅读训练出了对语言的“直觉”。理解大模型,不需要成为计算机科学家,只需要理解它是如何“学习”以及如何“思考”的。
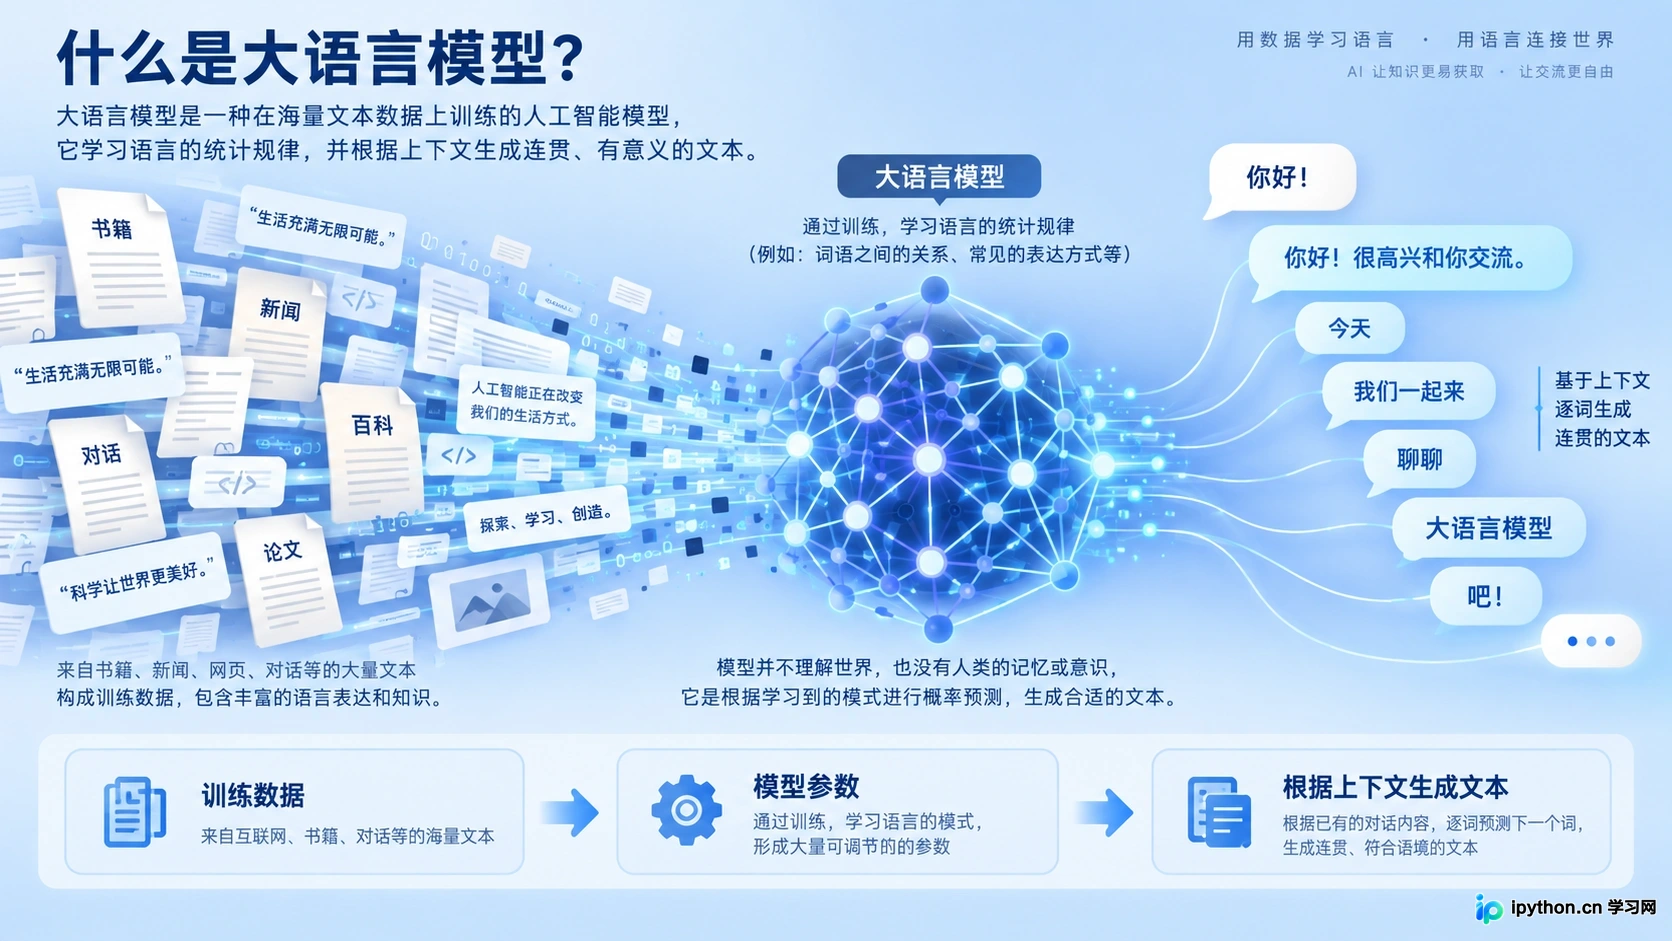
大模型如同一个拥有海量记忆的超级大脑,通过数据训练形成语言直觉
定义的基石:为什么叫“大”模型
要理解大模型是什么意思,首先要拆解它的名字。这里的“大”,并非指物理体积,而是指其在三个维度上的极致规模:数据、算力和参数。这三者共同构成了大模型的底座,缺一不可。
首先是大数据。想象一下,如果把互联网上公开的书籍、文章、代码、对话全部打印出来,堆叠的高度可能超过珠穆朗玛峰。大模型就是在这样的“数据海洋”中浸泡长大的。它阅读的不仅是文字的表面,更是文字背后的逻辑、事实和表达方式。没有这种规模的投喂,模型就无法建立起对世界的广泛认知。
其次是大算力。处理如此庞大的数据,普通电脑需要几万年才能完成一次训练。大模型的训练依赖于成千上万块高性能GPU组成的集群,它们日夜不停地计算,将数据中的规律转化为模型内部的权重。这就好比让一支庞大的工程队,在短时间内读完并消化整个图书馆的藏书。
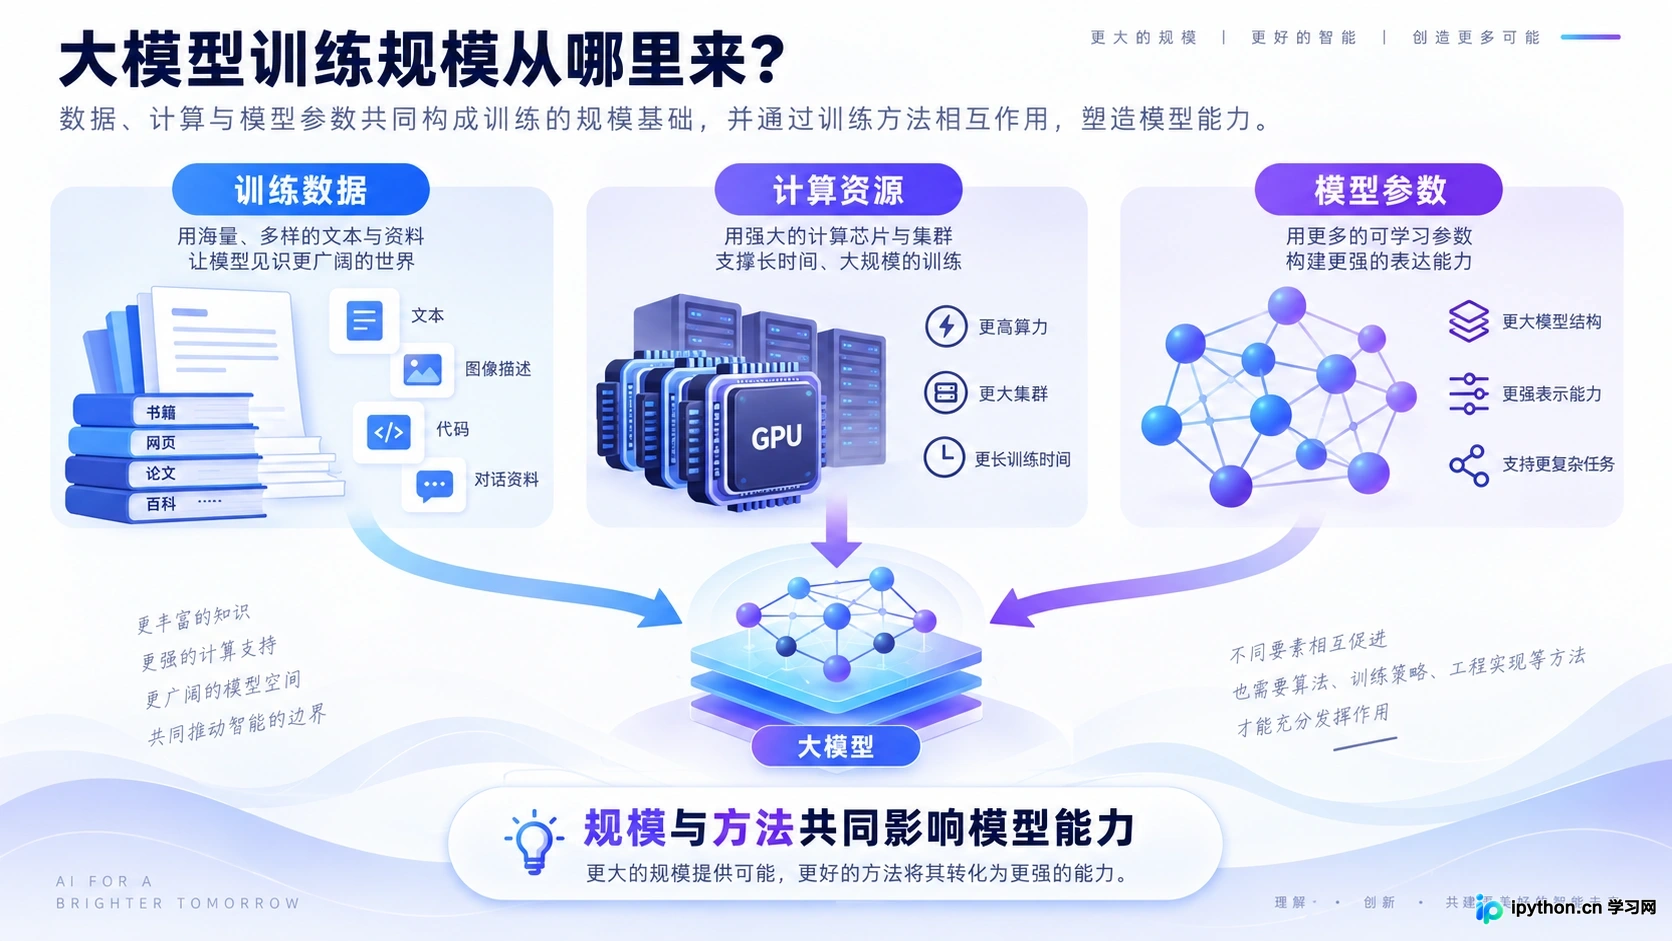
大数据、大算力与大参数共同构建了大模型的坚实基础
最后是大参数。这是大模型最核心的内部结构。参数可以理解为模型大脑中的“神经元连接点”。传统软件可能有几千行代码,而大模型拥有数千亿甚至万亿级的参数。每一个参数都存储着一点点关于语言规律的知识。当参数数量达到一定阈值,量变引起质变,模型就不再只是简单的统计工具,而是展现出了类似人类的推理和理解能力。
运作逻辑:不是检索,是概率预测
很多人误以为大模型像一个高级搜索引擎,你在框里输入问题,它去数据库里找答案返回给你。这是一个常见的误解。大模型并不“知道”事实,它是在“预测”下一个字。
当我们问大模型“天空是什么颜色的?”时,它并不是去查阅气象百科,而是基于它读过的亿万次文本,计算出在“天空是”这三个字后面,出现“蓝色”的概率最高,出现“绿色”的概率极低。它通过复杂的数学运算,从词汇表中选出概率最大的那个词,然后接着预测再下一个词,直到生成完整的句子。
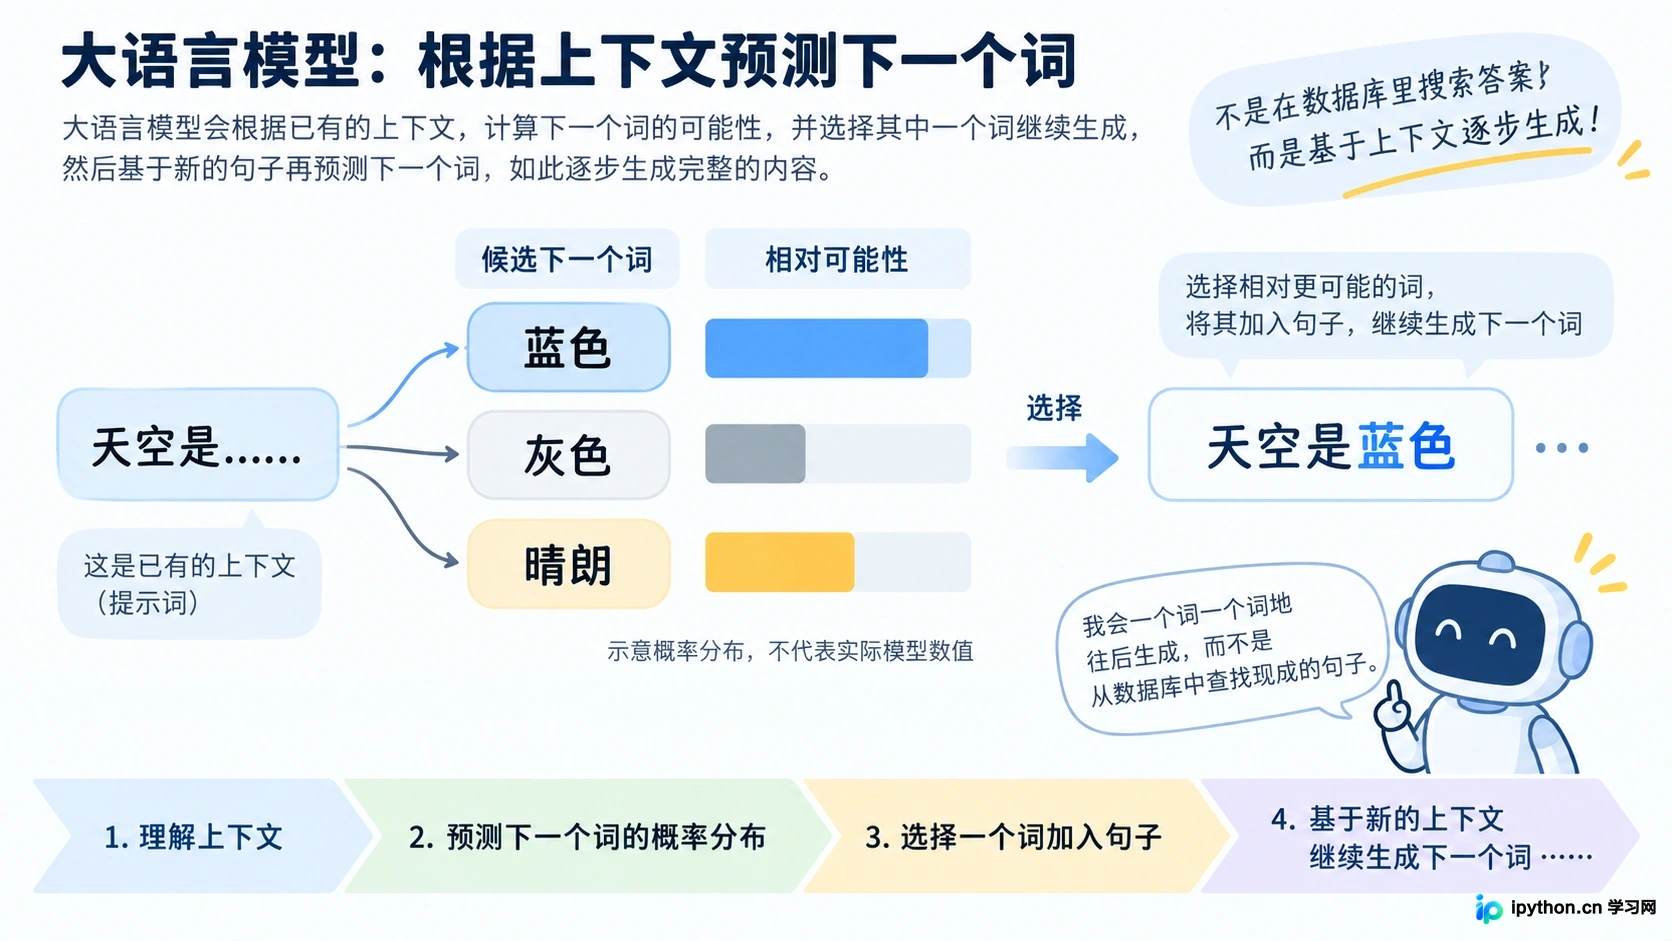
大模型通过计算下一个词的概率来生成连贯的文本
这种机制听起来简单,但因为参数量巨大,它能够捕捉到极其细微的语言关联。比如,它能理解“苹果”在水果店和科技新闻中代表完全不同的事物,因为它见过这两种语境下周围出现的其他词汇不同。这种基于上下文的概率预测,让它的回答看起来流畅自然,仿佛真的理解了你的意思。
然而,这也带来了它的局限性:因为它是在预测概率,所以有时会一本正经地胡说八道,也就是所谓的“幻觉”。当训练数据中没有确切答案,或者概率分布模糊时,它可能会编造一个看似合理但完全错误的事实。
核心特征:从“鹦鹉学舌”到“涌现智慧”
如果大模型只是会接龙,那它只是一个高级的输入法。大模型之所以被称为“智能”,是因为它在规模扩大后,出现了一些小模型不具备的涌现能力(Emergent Abilities)。
第一个特征是上下文理解与多轮对话。早期的聊天机器人只能回答单句指令,而大模型能记住前面的对话内容。你可以先让它写一段代码,再让它优化这段代码,最后让它解释优化的原因。它能在长篇幅的交流中保持逻辑的一致性,就像人类在谈话中会参考前文一样。
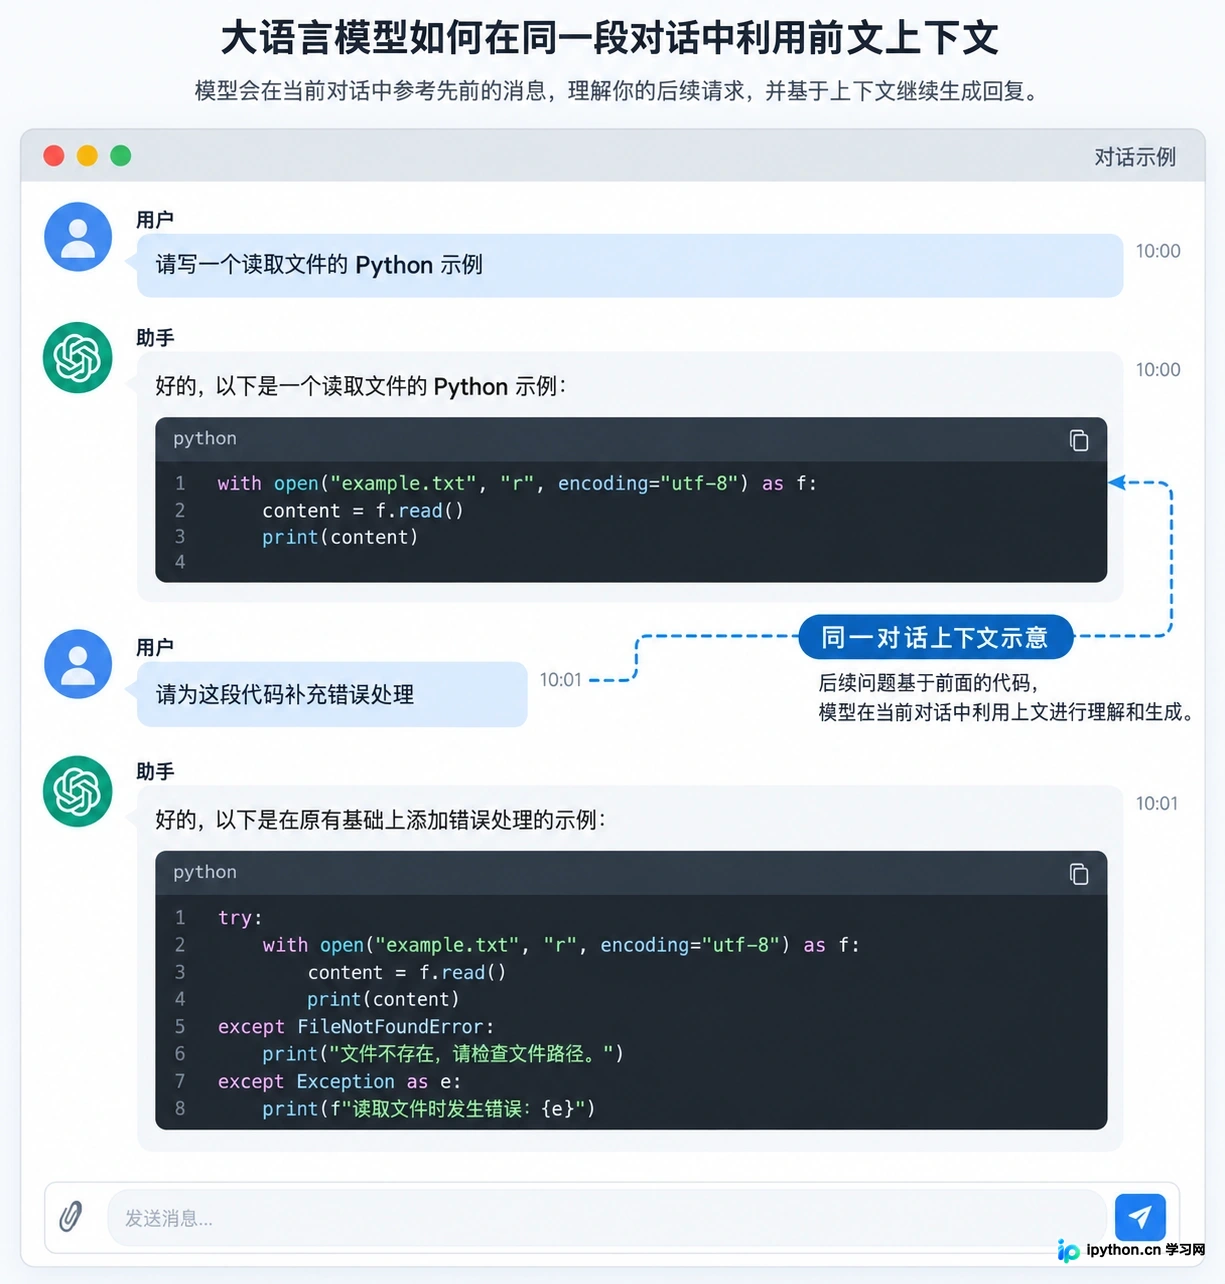
大模型能够记忆前文信息,进行连贯的多轮交互
第二个特征是少样本学习(Few-shot Learning)。你不需要教它成千上万个例子,只需给它一两个示范,它就能举一反三。例如,你告诉它“高兴->开心”,然后问它“悲伤->?”,它能立刻推断出“难过”。这种迁移学习能力,让它能够快速适应从未见过的任务类型,无论是翻译古文还是撰写营销文案。
第三个特征是逻辑推理与代码生成。虽然本质是概率预测,但当参数量足够大时,模型内部似乎形成了某种逻辑链条。它能够处理复杂的数学问题,或者写出可运行的程序代码。这并不是因为它真的懂微积分或Python语法,而是它在海量代码库中见过无数种解题模式和语法结构,从而能够模仿出正确的逻辑路径。
边界与启示:它是工具,不是真理
回到最初的问题,大模型是什么意思?它是一个基于海量数据和巨大算力训练出来的、通过概率预测来生成内容的统计模型。它强大,是因为它见多识广;它局限,是因为它缺乏真实的物理世界体验和价值判断。
理解大模型的核心,在于接受它的“不确定性”。 它不是一个全知全能的神,而是一个博学但偶尔会犯错的助手。在使用时,我们需要发挥人类的判断力,去核实关键事实,去引导它的输出方向,而不是盲目依赖。
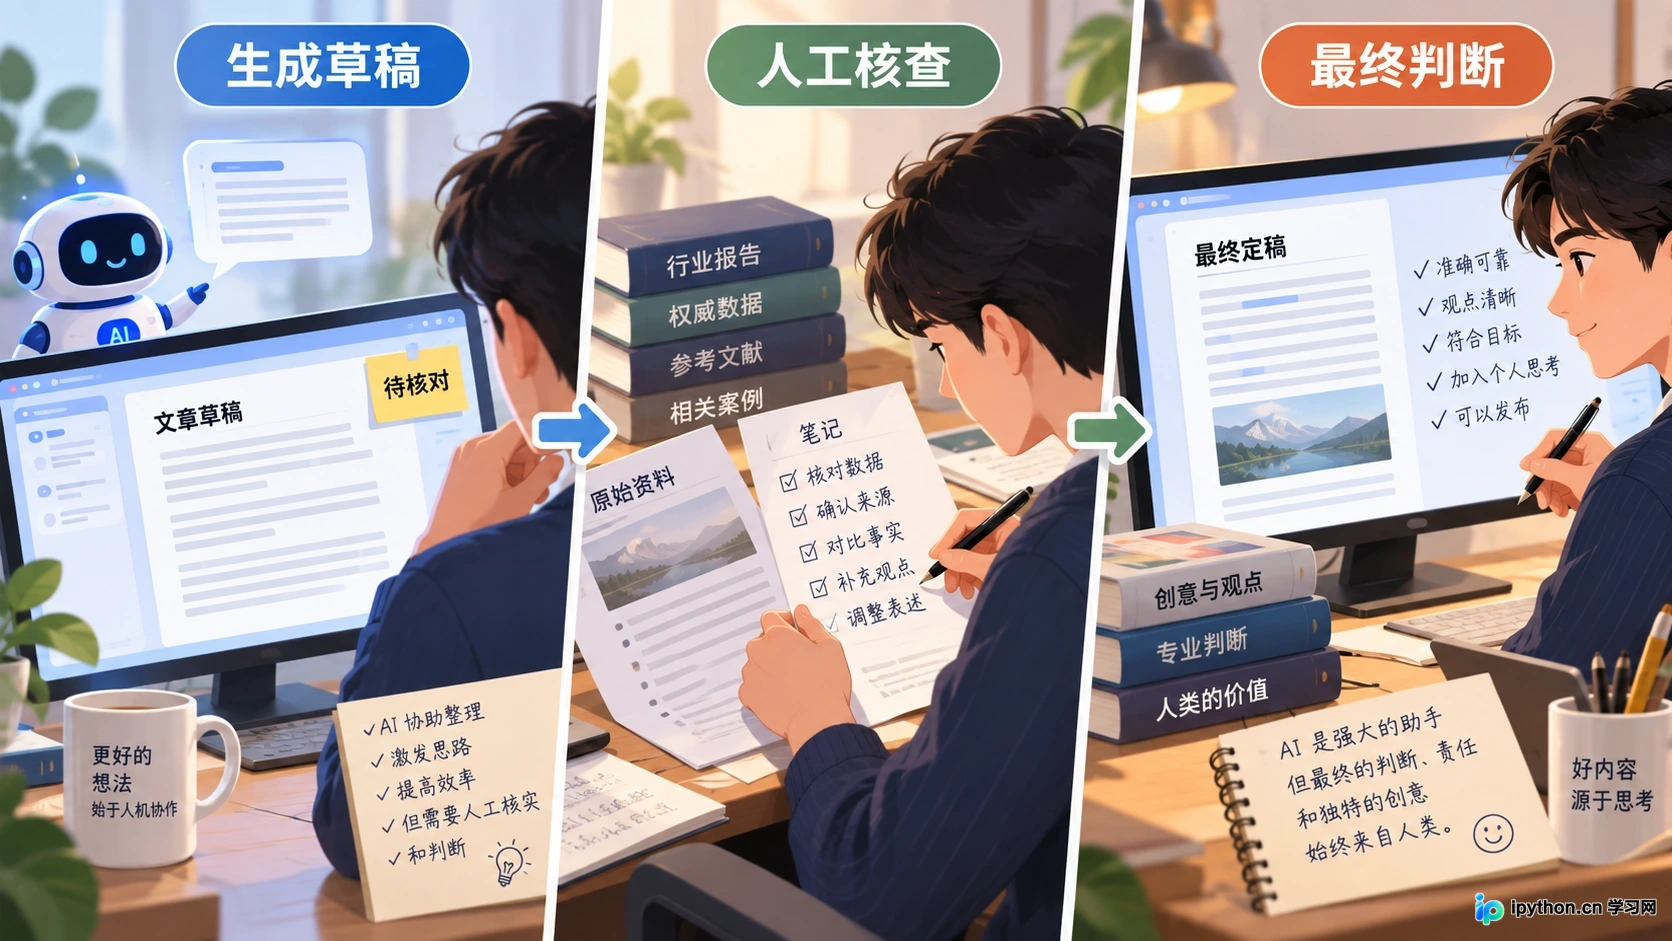
人类负责判断与创意,大模型负责执行与生成
对于普通用户而言,不必纠结于背后的Transformer架构或反向传播算法。更重要的是学会如何向它提问,如何利用它的发散思维来激发灵感,以及如何识别它的错误。大模型不是要取代人类的思考,而是将我们从重复性的信息整理和基础创作中解放出来,让我们有更多精力去从事真正需要创造力、情感共鸣和复杂决策的工作。在这个意义上,理解大模型,就是理解未来人机协作的新起点。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















