


Python机器学习线性回归详解:从OLS到梯度下降与多项式回归

本文深入解析Python中的线性回归模型,涵盖最小二乘法(OLS)的原理与代码实现、梯度下降算法的迭代优化过程,以及多项式回归的特征转换技巧。通过具体代码示例,展示如何利用statsmodels和scikit-learn构建模型,帮助读者掌握从基础线性拟合到非线性多项式处理的完整技术路径。
一、Python机器学习中的线性回归
线性回归属于最基础的机器学习模型范畴,其结构简洁且易于实现,同时构成了众多复杂机器学习算法的理论基石。
针对给定的训练数据集,线性回归的核心目标在于寻找一个与数据分布最为契合的线性函数。
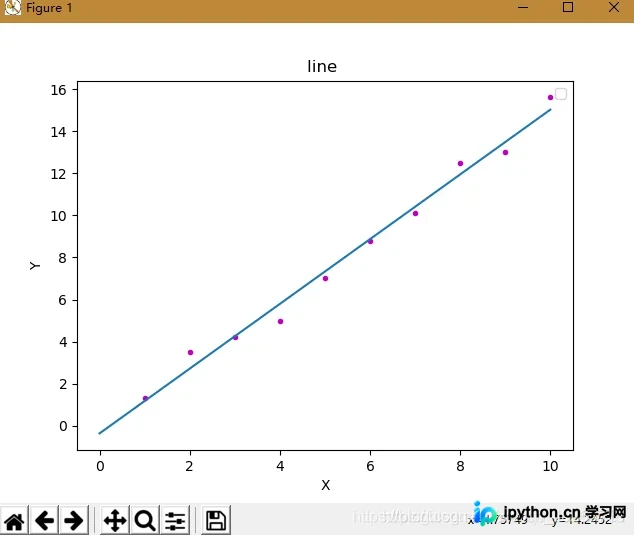
二、OLS线性回归
2.1 Ordinary Least Squares 最小二乘法
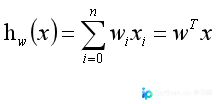
通常情况下,线性回归模型设定如下形式,其中w代表模型的参数变量。
在评估线性回归模型时,通常采用MSE(均方误差)作为损失函数。假设数据集包含m个样本,均方损失函数的计算方式为所有实例预测值与实际值误差平方的均值。
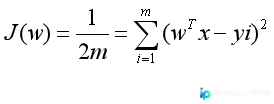
模型训练的目标是寻找使损失函数最小化的参数w。经过数学推导与变换,可得使损失函数达到最小值的w的解析解。
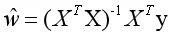
通过上述公式求得的w即为最优模型参数。
2.2 OLS线性回归的代码实现
#OLS线性回归
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
%matplotlib inline
data = pd.DataFrame(pd.read_excel(r'C:/Users/15643/Desktop/附件1.xlsx'))
feature_data = data.drop(['企业信誉评估'],axis=1)
target_data = data['企业信誉评估']
X_train,X_test,y_train, y_test = train_test_split(feature_data, target_data, test_size=0.3)
from statsmodels.formula.api import ols
from statsmodels.sandbox.regression.predstd import wls_prediction_std
df_train = pd.concat([X_train,y_train],axis=1)
lr_model = ols("企业信誉评估~销项季度均值+有效发票比例+是否违约+企业供求关系+行业信誉度+销项季度标准差",data=df_train).fit()
print(lr_model.summary())
# 预测测试集
lr_model.predict(X_test)
三、梯度下降算法
许多机器学习算法的最优参数无法通过如最小二乘法那样的“闭式”方程直接计算,此时必须依赖迭代优化方法。
梯度下降算法的执行逻辑可描述为以下步骤:
(1) 基于当前参数w计算损失函数的梯度∇J( w )。
(2) 沿着梯度反方向−∇J( w )对w进行调整,调整幅度由学习率η控制,更新公式为w:= w−η∇J( w )。
(3) 反复执行上述过程,直至梯度为0或损失函数降低幅度小于设定阈值,此时判定算法收敛。
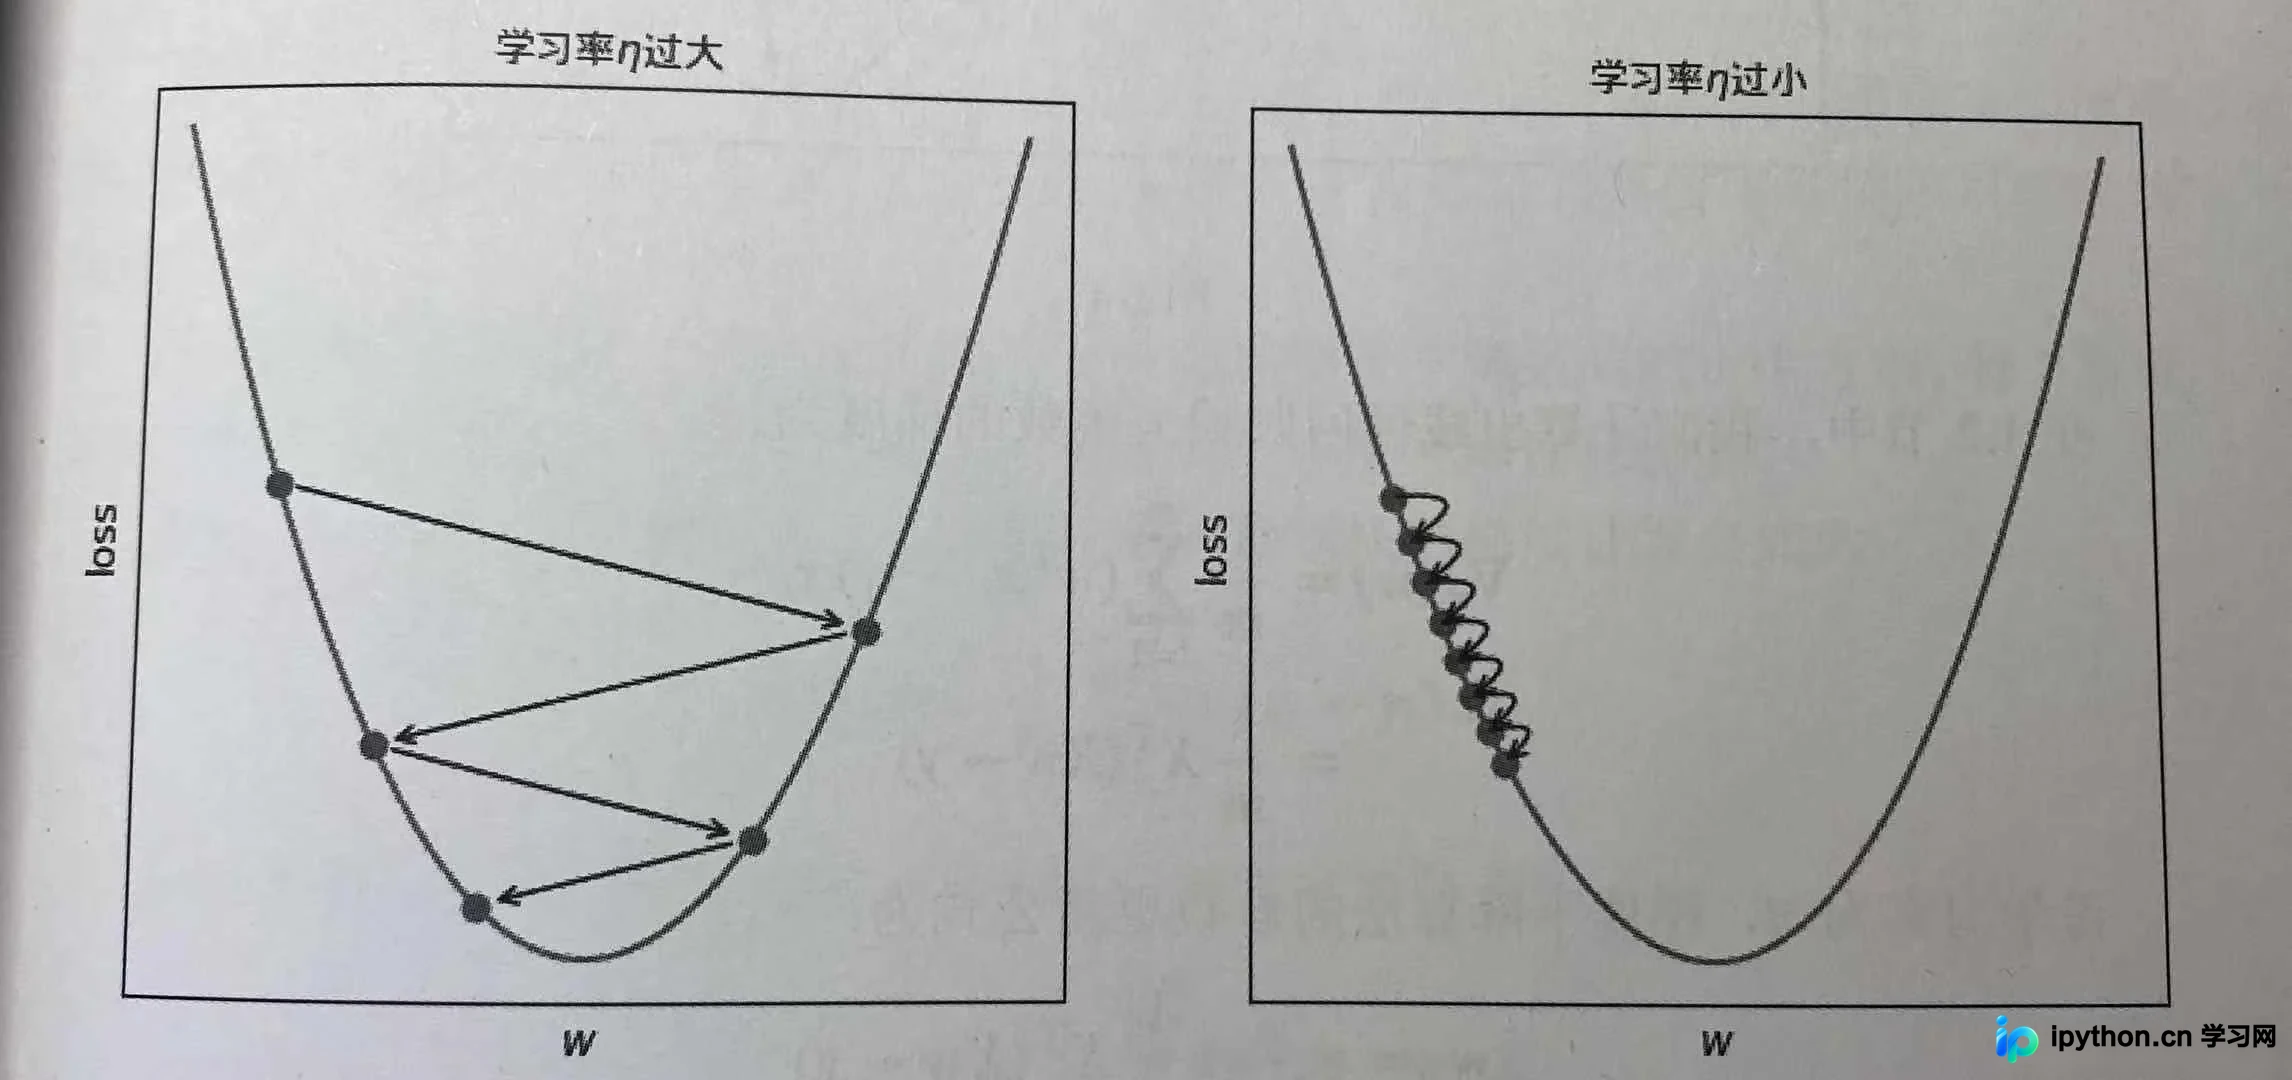
3.1 GDLinearRegression代码实现
from linear_regression import GDLinearRegression
gd_lr = GDLinearRegression(n_iter=3000,eta=0.001,tol=0.00001)
#梯度下降最大迭代次数n_iter
#学习率eta
#损失降低阈值tol
四、多项式回归分析
多项式回归是一种用于研究因变量与一个或多个自变量之间多项式关系的回归分析方法。
多项式回归的模型方程式表达如下:
hθ(x)=θ0+θ1x+θ2x2+...+θmxm
简而言之,当阶数设为k时,需将每个特征转换为一个k阶的多项式。这些多项式共同构成一个矩阵,并将该矩阵视为单一特征,从而将多项式回归模型转化为简单的线性回归问题。以下是特征x的多项式转换示例:
x−>[1,x,x2,x3...xk]
4.1 多项式回归的代码实现
在Python中实现多项式回归,需要导入PolynomialFeatures类。
#scikit-learn 多项式拟合(多元多项式回归)
#PolynomialFeatures和linear_model的组合 (线性拟合非线性)
#[x1,x2,x3]==[[1,x1,x1**2],[1,x2,x2**2],[1,x3,x3**2]]
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression,Perceptron
from sklearn.metrics import mean_squared_error,r2_score
from sklearn.model_selection import train_test_split
target = std_df_female['总分']
data_complete_ = std_df_female.loc[:,['1000/800','50m','立定跳远','引仰']]
x_train, x_test, y_train, y_test = train_test_split(data_complete_,target, test_size=0.3)
# 多项式拟合
poly_reg  =PolynomialFeatures(degree=2)
x_train_poly = poly_reg.fit_transform(x_train)
model = LinearRegression()
model.fit(x_train_poly, y_train)
#print(poly_reg.coef_,poly_reg.intercept_) #系数及常数
# 测试集比较
x_test_poly = poly_reg.fit_transform(x_test)
y_test_pred = model.predict(x_test_poly)
#mean_squared_error(y_true, y_pred) #均方误差回归损失,越小越好。
mse = np.sqrt(mean_squared_error(y_test, y_test_pred))
# r2 范围[0,1],R2越接近1拟合越好。
r2 = r2_score(y_test, y_test_pred)
print(r2)
至此,关于Python机器学习线性回归的详解介绍完毕。如需了解更多Python线性回归相关内容,建议搜索本站历史文章或继续浏览后续相关文章,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















