


Python使用KNN与K折交叉验证寻找最优K值

发布时间:2026-10-14 |
4人浏览过
本文介绍如何使用Python的sklearn库实现K折交叉验证,结合KNN算法在iris数据集上训练模型。通过遍历不同K值并计算平均准确率,自动筛选出最优的K值,为机器学习模型调参提供具体代码参考。
K折交叉验证与KNN实现
以下示例展示了利用Python代码实现K折交叉验证的具体方法,供读者参考学习。
本例采用KNN算法对iris数据集进行训练,并通过K折交叉验证技术来寻找最优的K值参数。
import numpy as np
from sklearn import datasets
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import KFold # 主要用于K折交叉验证

# 导入iris数据集
iris = datasets.load_iris()
X = iris.data
y = iris.target
print(X.shape,y.shape)

# 定义想要搜索的K值,这里定义8个不同的值
ks = [1,3,5,7,9,11,13,15]

# 进行5折交叉验证,KFold返回的是每一折中训练数据和验证数据的index
# 假设数据样本为:[1,3,5,6,11,12,43,12,44,2],总共10个样本
# 则返回的kf的格式为(前面的是训练数据,后面的验证集):
# [0,1,3,5,6,7,8,9],[2,4]
# [0,1,2,4,6,7,8,9],[3,5]
# [1,2,3,4,5,6,7,8],[0,9]
# [0,1,2,3,4,5,7,9],[6,8]
# [0,2,3,4,5,6,8,9],[1,7]
kf = KFold(n_splits = 5, random_state=2001, shuffle=True)

# 保存当前最好的k值和对应的准确率
best_k = ks[0]
best_score = 0

# 循环每一个k值
for k in ks:
    curr_score = 0
    for train_index,valid_index in kf.split(X):
        # 每一折的训练以及计算准确率
        clf = KNeighborsClassifier(n_neighbors=k)
        clf.fit(X[train_index],y[train_index])
        curr_score = curr_score + clf.score(X[valid_index],y[valid_index])

    # 求一下5折的平均准确率
    avg_score = curr_score/5
    if avg_score > best_score:
        best_k = k
        best_score = avg_score
    print("current best score is :%.2f" % best_score,"best k:%d" %best_k)

print("after cross validation, the final best k is :%d" %best_k)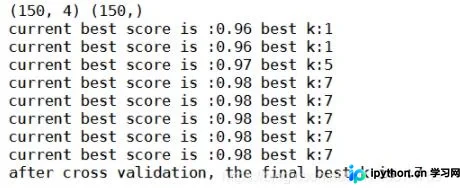
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















