


Python Scrapy实现多个爬虫同时运行的方法

本文介绍如何在Scrapy项目中配置多个爬虫同时运行。通过自定义commands模块,修改crawlall.py以遍历并启动所有spider,并在settings.py中指定模块路径。最后通过命令行验证命令可用性并执行启动,实现多爬虫并行抓取。
Scrapy多爬虫并行运行配置
在Scrapy项目中创建多个爬虫后,默认情况下它们是按顺序依次执行的。若希望实现多个爬虫同时并行运行,需要进行特定的配置操作。
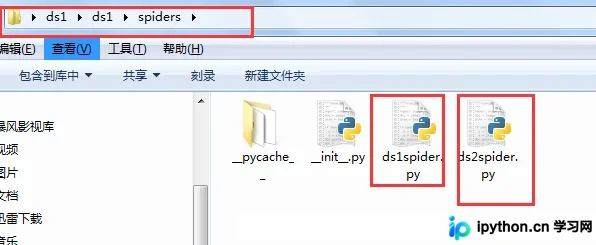
自定义命令模块实现
首先,在spiders目录的同级位置新建一个commands目录,并在其中创建crawlall.py文件。将该文件内容替换为Scrapy源码中commands文件夹下的crawl.py代码,但只需对run()方法进行自定义修改即可。
import os
from scrapy.commands import ScrapyCommand
from scrapy.utils.conf import arglist_to_dict
from scrapy.utils.python import without_none_values
from scrapy.exceptions import UsageError

class Command(ScrapyCommand):
    requires_project = True
    def syntax(self):
        return "[options] <spider>"
    def short_desc(self):
        return "Run all spider"
    def add_options(self, parser):
        ScrapyCommand.add_options(self, parser)
        parser.add_option("-a", dest="spargs", action="append", default=[], metavar="NAME=VALUE",
                          help="set spider argument (may be repeated)")
        parser.add_option("-o", "--output", metavar="FILE",
                          help="dump scraped items into FILE (use - for stdout)")
        parser.add_option("-t", "--output-format", metavar="FORMAT",
                          help="format to use for dumping items with -o")

    def process_options(self, args, opts):
        ScrapyCommand.process_options(self, args, opts)
        try:
            opts.spargs = arglist_to_dict(opts.spargs)
        except ValueError:
            raise UsageError("Invalid -a value, use -a NAME=VALUE", print_help=False)
        if opts.output:
            if opts.output == '-':
                self.settings.set('FEED_URI', 'stdout:', priority='cmdline')
            else:
                self.settings.set('FEED_URI', opts.output, priority='cmdline')
            feed_exporters = without_none_values(
                self.settings.getwithbase('FEED_EXPORTERS'))
            valid_output_formats = feed_exporters.keys()
            if not opts.output_format:
                opts.output_format = os.path.splitext(opts.output)[1].replace(".", "")
            if opts.output_format not in valid_output_formats:
                raise UsageError("Unrecognized output format '%s', set one"
                                 " using the '-t' switch or as a file extension"
                                 " from the supported list %s" % (opts.output_format,
                                                                  tuple(valid_output_formats)))
            self.settings.set('FEED_FORMAT', opts.output_format, priority='cmdline')

    def run(self, args, opts):
        #获取爬虫列表
        spd_loader_list=self.crawler_process.spider_loader.list()#获取所有的爬虫文件。
        print(spd_loader_list)
        #遍历各爬虫
        for spname in spd_loader_list or args:
            self.crawler_process.crawl(spname, **opts.spargs)
            print ('此时启动的爬虫为:'+spname)
        self.crawler_process.start()
接着,在commands目录下添加一个__init__.py文件,使其成为有效的Python包。
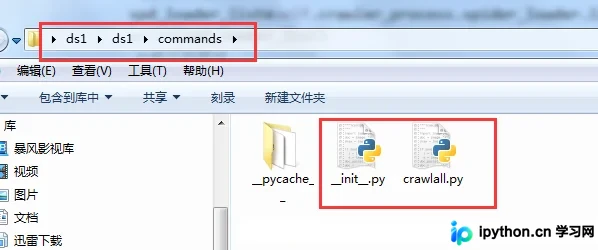
此外,还需要修改项目根目录下的settings.py配置文件,添加特定的配置项。
在settings.py中添加如下配置:COMMANDS_MODULE = '项目名称.目录名称'。
COMMANDS_MODULE = 'ds1.commands'完成上述配置后,即可通过启动crawlall命令来运行所有爬虫。
为确保配置正确,建议先在命令行中进入项目所在目录,输入scrapy -h查看命令列表。如果列表中出现了crawlall命令,说明配置成功,可以开始执行。
启动与验证方法
另外,也可以编写一个启动脚本文件,将其放置在项目的第一级目录中以便调用。
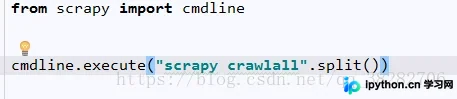
或者,直接在命令行终端中输入scrapy crawlall命令即可启动所有配置的爬虫。
运行注意事项
需要注意的是,实际运行结果显示,多个爬虫(如2个)会同时启动,且它们的运行日志输出可能是交叉进行的。
此外,settings.py中的配置仅针对当前项目生效,需确保配置正确指向自定义的commands模块。
至此,关于在Scrapy项目中实现多个爬虫同时运行的配置方法介绍完毕。如需了解更多相关技术细节,可参考本站其他文章或继续浏览后续内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















