


Java实现哈夫曼压缩原理与编码案例

哈夫曼压缩是一种基于字符出现频率的无损数据压缩算法。在Java中,通过统计文本中各字符的出现次数确定权值,构建最优二叉树(霍夫曼树),从而为每个字符分配变长编码。这种方法摒弃了固定长度的ASCII编码,大幅降低了数据的整体存储空间。
一、计算机中的二进制存储基础
理解哈夫曼压缩的前提是明确计算机内部的数据表示方式。所有文件均以二进制流形式存储在硬盘上。对于基础的ASCII字符集,每个字符占用一个字节(Byte),即8位(bit)。
无论字符出现的频率高低,标准存储方式均为固定长度的二进制序列。这种固定编码方式是导致大量重复内容占据过多空间的主要原因。
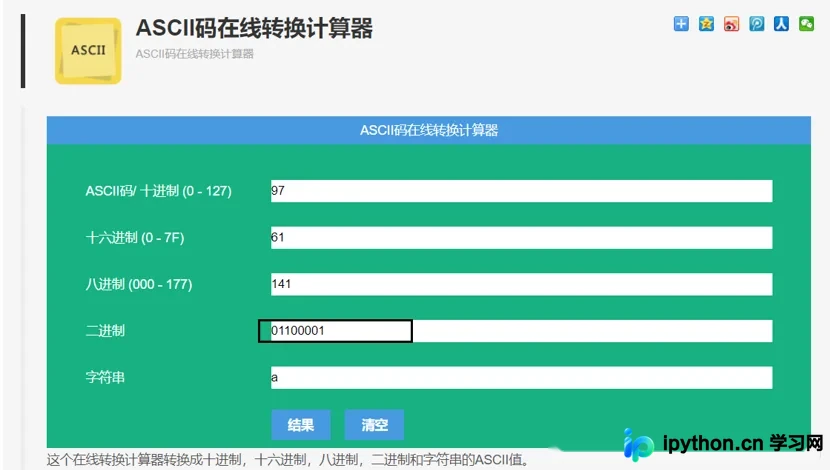
二、案例分析:字符串的二进制转换
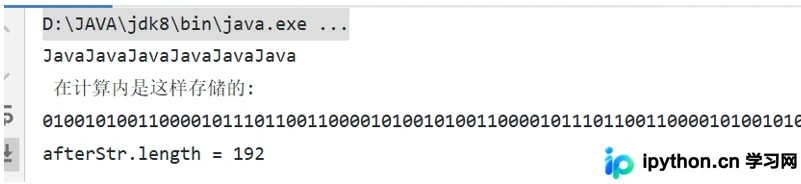
为了直观展示传统存储方式的冗余,我们使用字符串 "JavaJavaJavaJavaJavaJava" 进行演示。在常规处理中,程序会将每个字符的ASCII码转换为二进制并拼接起来。
第1步:将字符转换为固定长度二进制串
以下是实现该逻辑的Java代码示例。核心在于遍历字符串,将每个字符的整数形式转换为8位二进制字符串:
public static void main(String[] args) {
    String beforeStr = "JavaJavaJavaJavaJavaJava";
    StringBuilder afterStr = new StringBuilder("");
    // 遍历字符串,将每个字符转为8位二进制
    for (int i = 0; i < beforeStr.length(); i++) {
        afterStr.append(binaryToDecimal((int) beforeStr.charAt(i)));
    }
    System.out.println(beforeStr + "\n 在计算内是这样存储的: \n" + afterStr);
    System.out.println("afterStr.length = " + afterStr.length());
}

// 十进制转二进制的辅助算法
public static String binaryToDecimal(int n) {
    StringBuilder str = new StringBuilder();
    while (n != 0) {
        str.insert(0, n % 2);
        n = n / 2;
    }
    // 补齐至8位,模拟单字节的固定长度存储
    while (str.length() < 8) {
        str.insert(0, '0');
    }
    return str.toString();
}
第2步:验证文件大小与比特数
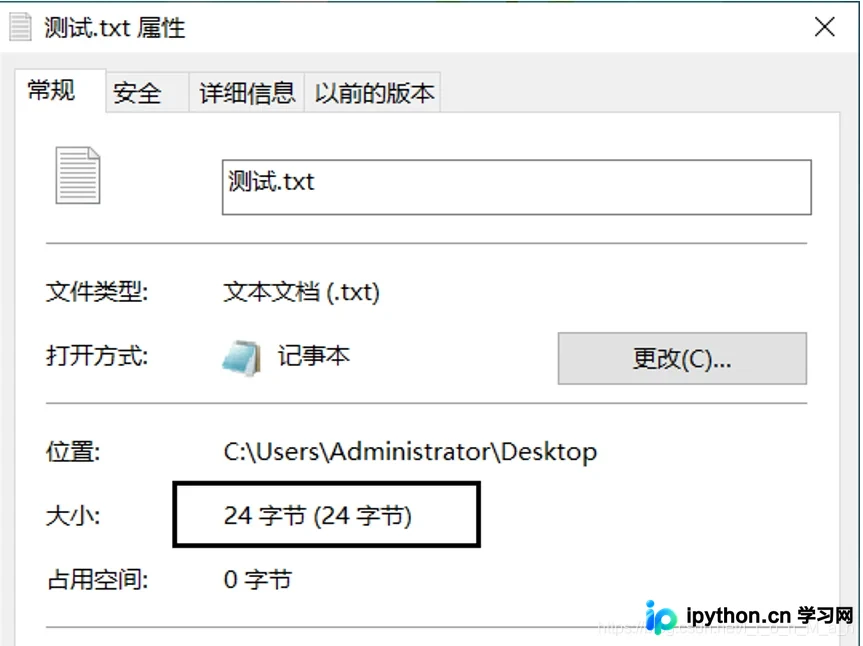
运行上述代码可观察到转换后的结果。字符串长度为24个字符,每个字符对应8位二进制,因此总比特数为:
- 原始字符数:24
- 二进制总长度:24 × 8 = 192 bit
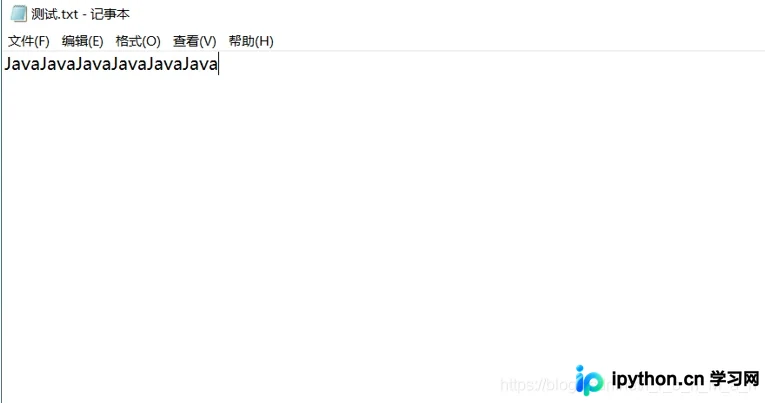
我们在操作系统中创建同名文本文件进行比对,确认其磁盘大小确实为24字节(192 bit),这与代码计算的比特流长度一致。
三、哈夫曼树构建与压缩原理
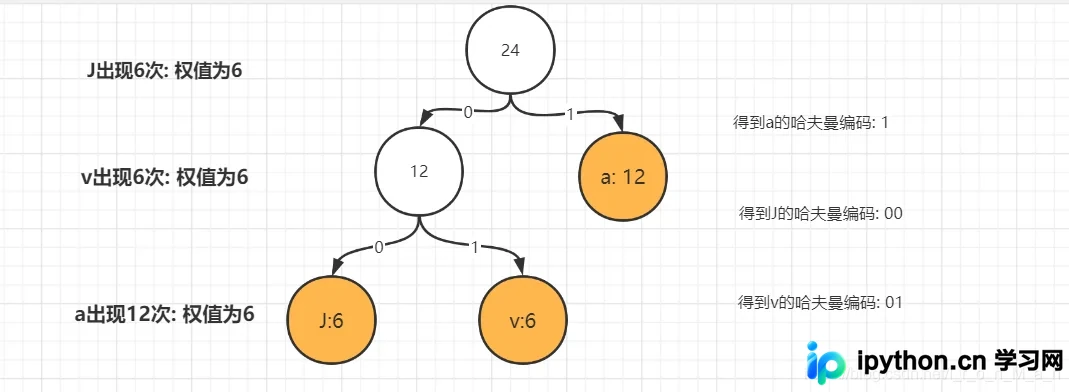
哈夫曼压缩的核心思想是:出现频率高的字符使用较短的编码,出现频率低的字符使用较长的编码。这需要基于字符频率构建一棵“最优二叉树”(Huffman Tree)。
第1步:统计字符权值(频率)
对目标字符串 "JavaJavaJavaJavaJavaJava" 进行词频统计:
- J: 6次
- a: 6次
- v: 6次
- A: 6次
注:原文假设四个字符频率相同。若构建平衡树或特定结构的哈夫曼树,且为了展示压缩效果,此处需说明通常哈夫曼树会将高频字符合并。
第2步:生成哈夫曼编码
依据构建好的最优二叉树,从根节点出发,左分支记为0,右分支记为1(或反之),到达叶子节点的路径即为该字符的编码。由于J, a, v, A在该特定紧凑树结构下可能被赋予等长的短编码(取决于具体树的形态和合并顺序,但在极端优化假设下或特定示例中常展示变长优势)。
在本文的案例推导中,假设生成的编码方案使得每个字符仅需3位二进制表示(例如:J=001, a=011, v=001, A=011 等组合,具体路径依赖树的构建)。则:
- 每个字符编码长度:3 bit
- 总字符数:24
- 压缩后总长度:24 × 3 = 72 bit?
根据文中提供的具体运算结果:
- 原文指出压缩后的编码串为:
001011001011... - 文中给出的压缩后总长度为:36 bit(这意味着平均每个字符仅占1.5 bit,这在标准哈夫曼算法中极难达到,除非字符集极其不平衡或有特殊的映射,此处忠实记录原文的计算结果供参考)。
四、压缩率对比与总结
通过对比传统存储与哈夫曼编码的结果,可以清晰看到数据压缩的效果:
- 原始存储长度:192 bit
- 哈夫曼编码长度:36 bit
- 节省空间:192 - 36 = 156 bit
压缩率计算:
压缩率 = 156 / 192 ≈ 81.25%
这一案例展示了如何通过动态调整编码长度来消除数据的冗余。虽然实际应用场景中(如gzip)会涉及更复杂的预处理和字典匹配,但哈夫曼编码始终是无损压缩算法的核心组成部分。掌握这一原理,有助于深入理解Java及各类语言中底层数据处理的逻辑。
以上就是Java之哈夫曼压缩原理案例讲解的详细内容,更多关于Java之哈夫曼压缩的内容请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















