


Python爬虫实战:使用Bs4与Lxml进行数据解析

发布时间:2026-10-14 |
5人浏览过
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。
一、实现数据解析
鉴于正则表达式的学习门槛较高,本节重点介绍使用Bs4进行数据解析的方法。此外,XPath也是一种常用的解析方式,因其跨语言特性,本文仅简要演示Bs4与正则解析的两个案例(包括可翻页图片爬取及《三国演义》文本抓取),后续内容将侧重于XPath解析。
二、安装库
接下来,我们将安装Bs4相关的外部依赖库,操作过程相对简单。
首先,打开CMD命令行界面,依次执行命令安装bs4和lxml。
具体的安装命令分别为pip install bs4和pip install lxml。
安装完成后,建议尝试调用相关模块以验证是否报错。
若遇到报错,建议通过搜索引擎排查原因(通常可能是命令拼写错误)。
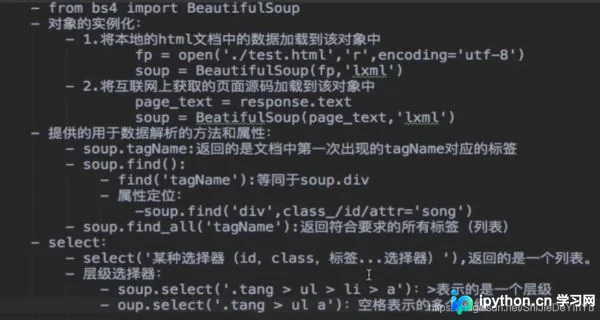
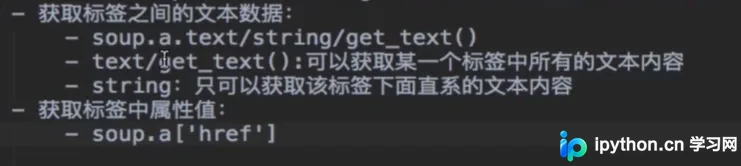
三、bs4 的用法
此处简要介绍Bs4的基本用法。
四、爬取图片
import requests
from bs4 import BeautifulSoup
import os

if __name__ == "__main__":
    # 创建文件夹
    if not os.path.exists("./糗图(bs4)"):
        os.mkdir("./糗图(bs4)")

    # UA伪装
    header = {
        "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.72 Safari/537.36"
        }

    # 指定 url
    for i in range(1, 3): # 翻两页
        url = "https://www.qiushibaike.com/imgrank/page/%s/" % str(i)
        # 获取源码数据
        page = requests.get(url = url, headers = header).text
        # 数据解析
        soup = BeautifulSoup(page, "lxml")
        data_list = soup.select(".thumb > a")
        for data in data_list:
            url = data.img["src"]
            title = url.split("/")[-1]
            new_url = "https:" + url
            photo = requests.get(url = new_url, headers = header).content
            # 存储
            with open("./糗图(bs4)/" + title, "wb") as fp:
                fp.write(photo)
            print(title, "下载完成!!!")
    print("over!!!")
五、爬取三国演义
import requests
from bs4 import BeautifulSoup

if __name__ == "__main__":
    # UA 伪装
    header = {
        "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.90 Safari/537.36"
        }

    # URL
    url = "http://sanguo.5000yan.com/"

    # 请求命令
    page_text = requests.get(url = url, headers = header)
    page_text.encoding = "utf-8"
    page_text = page_text.text
    soup = BeautifulSoup(page_text, "lxml")

    # bs4 解析
    li_list = soup.select(".sidamingzhu-list-mulu > ul > li")

    for li in li_list:
        print(li)
        new_url = li.a["href"]
        title = li.a.text

        # 新的请求命令
        response = requests.get(url = new_url, headers = header)
        response.encoding = "utf-8"
        new_page_text = response.text
        new_soup = BeautifulSoup(new_page_text, "lxml")

        page = new_soup.find("div", class_ = "grap").text

        with open("./三国演义.txt", "a", encoding = "utf-8") as fp:
            fp.write("\n" + title + ":" + "\n" + "\n" + page)

        print(title + "下载完成!!!")
至此,关于Python爬虫中Bs4数据解析的介绍已完成。如需了解更多Python Bs4相关内容,可查阅本站过往文章或继续浏览后续文章,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















