


Python字符串操作全解:拼接、截取、分割、格式化与编码转换

本文系统讲解Python中字符串的常规操作。涵盖使用+运算符拼接、利用len与encode计算字节长度、通过切片语法截取、split与join分割合并,以及find、index等检索方法。详细解析%与format两种格式化方式,并深入说明str与bytes类型的encode编码及decode解码转换机制,助您掌握核心技能。
拼接字符串
- 利用“+”运算符可以将多个字符串连接起来,生成一个新的字符串对象。
- 需要注意的是,字符串类型不能直接与数字等其他数据类型进行拼接操作。
- 若需将其他类型数据与字符串拼接,必须先使用str()函数将其转换为字符串类型。
str1 = 'Hello World'
str2 = '你好,世界'
print(str1+str2)
num = 2021
print(str1+str2+str(num))
计算字符串长度
由于不同字符占用的字节数存在差异,计算字符串长度前需明确字符编码规则。在Python中,数字、英文字母、小数点、下划线及空格均占用1个字节;汉字占用的字节数通常为2至4个,具体取决于编码方式。例如,在GBK或GB2312编码中,一个汉字占2个字节;而在UTF-8或Unicode编码中,通常占用3或4个字节。Python默认采用UTF-8编码,因此一般一个汉字占用3个字节。
str1 = '人生苦短,我用python!'
print(len(str1))             #结果为14
默认情况下,len()函数计算字符串长度时不区分英文、数字或汉字,将所有字符均视为1个字符进行计数。
注:
在实际开发中,若需获取字符串实际占用的字节数,可先使用encode()方法指定编码格式,再计算其长度。
str1 = '人生苦短,我用python!'
print(len(str1.encode()))      #UTF-8结果为28
print(len(str1.encode('gbk'))) #gbk结果为21
截取字符串
语法格式:string[start : end : step]
string:表示需要截取的原始字符串;
start:表示截取的起始索引(包含该位置的字符),若未指定则默认为0;
end:表示截取的结束索引(不包含该位置的字符),若未指定则默认为字符串长度;
step:表示切片的步长,若省略则默认为1;
进行截取操作时,若指定的索引超出字符串范围,程序将抛出异常。
programer_1 = '你知道我的生日吗?'  # 程序员甲问程序员乙的台词
print('程序员甲说:',programer_1)  # 输出程序员甲的台词
programer_2 = '输入你的身份证号码。' # 程序员乙的台词
print('程序员乙说:',programer_2)  # 输出程序员乙的台词
idcard = '123456199006277890'  # 定义保存身份证号码的字符串
print('程序员甲说:',idcard)  # 程序员乙说出身份证号码
birthday = idcard[6:10] + '年' + idcard[10:12] + '月' + idcard[12:14] + '日'   # 截取生日
print('程序员乙说:','你是' + birthday + '出生的,所以你的生日是' + birthday[5:]) # 输出程序员乙的生日
分割字符串
语法格式:string.split(sep,maxsplit)
string:指定需要分割的源字符串;
sep:指定分隔符,可包含多个字符,默认为None(即空字符,包括空格、换行符“\n”、制表符“\t”等);
maxsplit:可选参数,用于指定最大分割次数。若未指定或设为-1,则分割次数无限制;否则返回结果列表的元素个数最多为maxsplit+1;
该方法的返回值是一个字符串列表;
str1 = '分割一个字符串 >>> http://www.baidu.com'
print('原字符串:',str1)
list1 = str1.split()
list2 = str1.split('>>>')
list3 = str1.split('.')
list4 = str1.split(' ',4)  #用空格进行分割,只分割前4个空格
print(str(list1)+'\n'+str(list2)+'\n'str(list3)+'\n'str(list4))
list5 = str1.split('>')
print(list5)
合并字符串
语法格式:strnew = string.join(iterable)
strnew:表示合并后生成的新字符串;
string:字符串类型,用于指定合并时使用的分隔符;
iterable:可迭代对象,例如列表、字符串、元组等。
list_friend = ['扎克伯格','俞敏洪','马云','马化腾']  # 好友列表
str_friend = ' @'.join(list_friend)  # 用空格+@符号进行连接
at = '@'+str_friend  # 由于使用join()方法合并时,第一个元素前不加分隔符,所以需要在前面加上@符号
print('您要@的好友:',at)
检索字符串
语法格式:str.count(sub[,start[,end]])
用于统计指定子字符串在原字符串中出现的次数。
str:表示原字符串;
sub:表示需要检索的子字符串;
start:可选参数,表示检索范围的起始索引,若未指定则从头开始检索;
end:可选参数,表示检索范围的结束索引,若未指定则检索至末尾。
find()方法
语法格式:str.find(sub[,start[,end]])
用于检索字符串中是否包含指定的子字符串。
str:表示原字符串;
sub:表示需要检索的子字符串;
start:可选参数,表示检索范围的起始索引,若未指定则从头开始检索;
end:可选参数,表示检索范围的结束索引,若未指定则检索至末尾。
补充:
如果仅需判断子字符串是否存在,建议使用in关键字;若未找到,find()方法返回-1。若需从右向左查找,可使用rfind()方法。
index()方法
语法格式:str.index(sub[,start[,end]])
index()方法与find()类似,用于检索是否包含指定子字符串,区别在于若未找到会抛出异常。
str:表示原字符串;
sub:表示需要检索的子字符串;
start:可选参数,表示检索范围的起始索引,若未指定则从头开始检索;
end:可选参数,表示检索范围的结束索引,若未指定则检索至末尾。
startswith()方法
语法格式:str.startswith(sub[,start[,end]])
用于检索字符串是否以指定子字符串开头,若是返回True,否则返回False。
str:表示原字符串;
sub:表示需要检索的子字符串;
start:可选参数,表示检索范围的起始索引,若未指定则从头开始检索;
end:可选参数,表示检索范围的结束索引,若未指定则检索至末尾。
endswith()方法
语法格式:str.endswith(sub[,start[,end]])
用于检索字符串是否以指定子字符串结尾,若是返回True,否则返回False。
str:表示原字符串;
sub:表示需要检索的子字符串;
start:可选参数,表示检索范围的起始索引,若未指定则从头开始检索;
end:可选参数,表示检索范围的结束索引,若未指定则检索至末尾。
去除字符串中空格和特殊字符
strip()方法
用于去除字符串两侧(首尾)的空格和特殊字符。
lstrip()方法
用于去除字符串左侧(开头)的空格和特殊字符。
rstrip()方法
用于去除字符串右侧(结尾)的空格和特殊字符。
特殊字符指:
制表符\t、回车符\r、换行符\n等。
格式化字符串格式一
字符串格式化是指先定义一个包含占位符的模板,预留空位,随后填入相应内容。这些占位符在最终输出前不会显示。
使用“%”操作符
语法格式:'%[-][+][0][m][.n]格式化字符'%exp (注意别漏了单引号)
-:可选参数,用于指定左对齐,正数前方无符号,负数前面加负号;
+:可选参数,用于指定右对齐,正数前方加正号,负数前面加负号;
0:可选参数,表示右对齐,正数前方无符号,负数前方加负号,用0填充空白处(一般与m参数一起使用);
m:可选参数,表示占有宽度;
n:可选参数,表示小数点后保留的位数;
格式化字符:用于指定数据类型;
exp:要转换的项,若指定多个值,需通过元组传递,不能使用列表。
常用格式化字符串
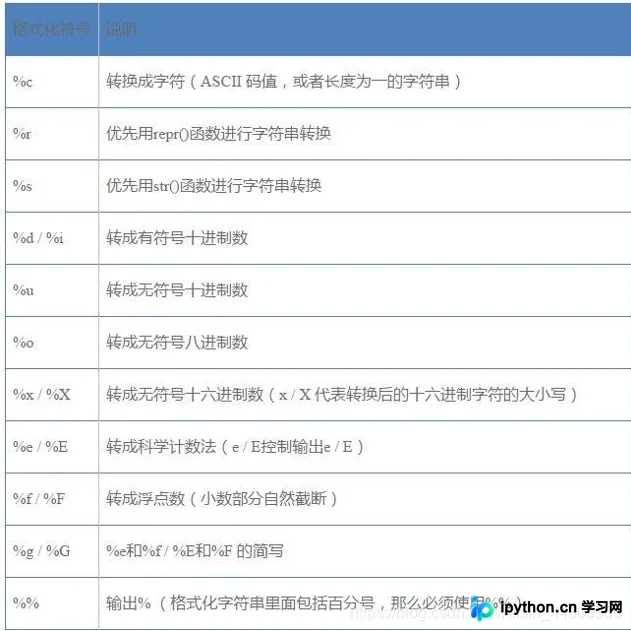
实例
template = '编号:%09d\t公司名称: %s\t官网:http://www.%s.com'
context1 = (7,'百度','baidu')
context2 = (8,'新浪','sina')
print(template%context1)
print(template%context2)
格式化字符串格式二(常用)
目前大多数场景已较少使用%方法,转而采用第二种format对象来实现格式化。
使用字符串对象的format()方法
语法格式:template.format(args)
template:用于指定字符串显示样式(即模板)的字符串;
args:用于指定要转换的项,若有多项,则用逗号进行分割。
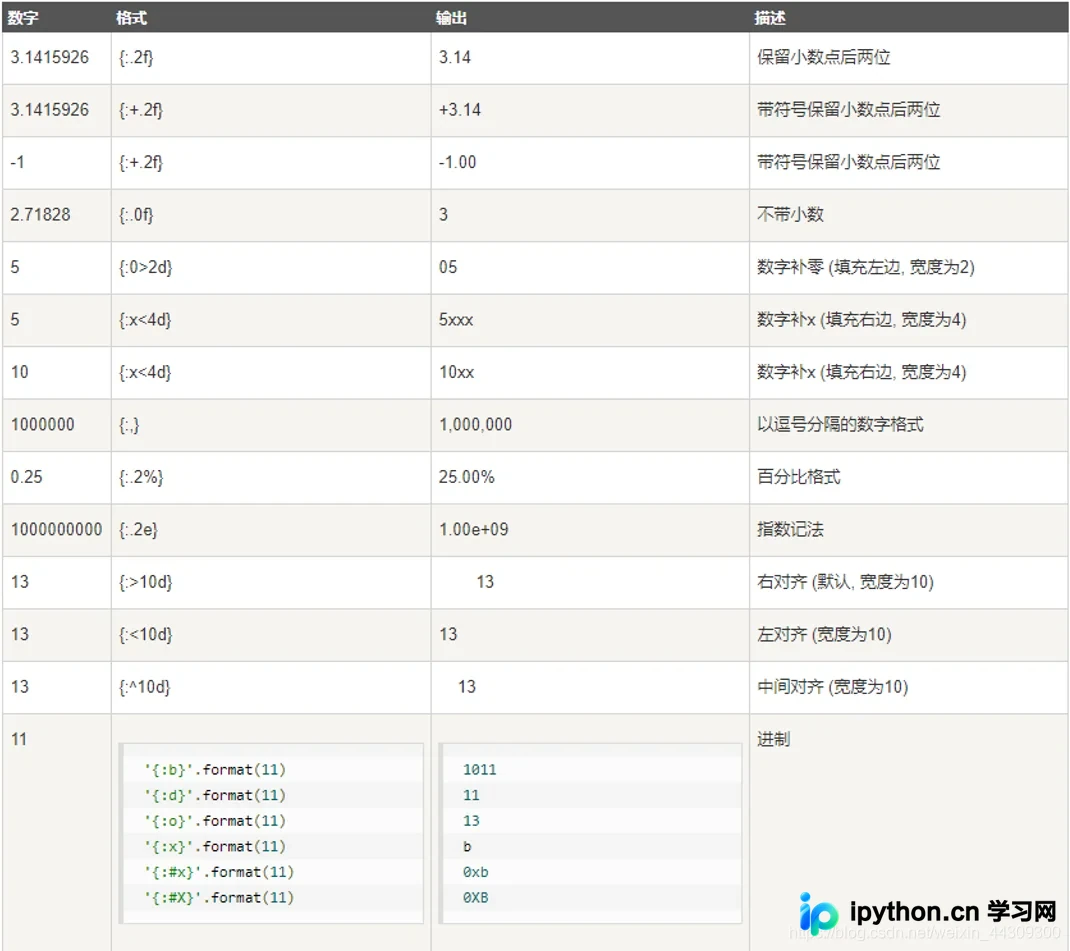
创建模板时,需要使用“{}”和“:”指定占位符。
语法格式:{[index][:[[fill]align][sign][#][width][.precision][type]]}
index:可选参数,用于指定要设置格式的对象在参数列表中的索引位置;
fill:可选参数,指定空白处填充的字符;
align:可选参数,用于指定对齐方式(“<”:左对齐,“>”:右对齐,“=”:仅对数字有效的右对齐,“^”:表示居中,需与width一起使用);
width一起使用。
sign:可选参数,用于指定是否显示符号(正数、负数);
#:可选参数,对二进制、八进制和十六进制数,加上#会显示0b/0o/0x前缀;
width:可选参数,用于指定宽度;
.precision:可选参数,用于指定保留的小数位数;
type:可选参数,用于指定类型。
实例
import math        # 导入Python的数学模块
print('1251+3950的结果是(以货币形式显示):¥{:,.2f}元'.format(1251+3950)) # 以货币形式显示
print('{0:.1f}用科学计数法表示:{0:E}'.format(120000.1))    # 用科学计数法表示
print('π取5位小数:{:.5f}'.format(math.pi))     # 输出小数点后五位
print('{0:d}的16进制结果是:{0:#x}'.format(100))     # 输出十六进制数
print('天才是由 {:.0%} 的灵感,加上 {:.0%} 的汗水 。'.format(0.01,0.99))   # 输出百分比,并且不带小数
字符串编码转换
最早的字符串编码是美国标准信息交换码(ASCII),仅包含10个数字、26个大写英文字母、26个小写英文字母及一些其他符号。ASCII码最多只能表示256个符号,每个字符占1个字节。GBK和GB2312是我国制定的中文编码规则,使用1个字节表示英文字母,2个字节表示中文。UTF-8是国际通用编码,对全球各国所需字符进行了编码。UTF-8采用1个字节表示英文,3个字节表示中文。
在Python中,有两种常用的字符串类型,分别为str和bytes。其中str表示Unicode字符(即ASCII);bytes表示二进制数据。这两种类型的字符串不能直接拼接使用。通常情况下,str在内存中以Unicode表示,一个字符对应若干个字节。但在网络传输或保存到硬盘时,需要将str转换为字节类型,即bytes。
bytes类型的数据带有b前缀(使用单引号或双引号)。
例如:b'\xd2\xb0' 和 b'mr' 都是bytes类型。
str类型和bytes类型可以通过encode()和decode()方法进行相互转换。
使用encode()方法编码
encode()方法是str对象的方法,用于将字符串转换为二进制数据(即bytes),也称为“编码”。
语法格式:str.encode([encoding= “utf-8”][,errors= “strict”])
- str:表示要进行转换的字符串;
- encoding = “utf-8”:可选参数,用于指定转码时采用的字符编码,默认为UTF-8。若需使用简体中文,可设置为gb2312。当仅有此参数时,可省略“encoding=”,直接写编码值;
- errors = “strict”:可选参数,用于指定错误处理方式,可选值包括strict(遇到非法字符抛出异常)、ignore(忽略非法字符)、replace(用“?”替换非法字符)或xmlcharrefreplace(使用XML字符引用)等,默认值为strict。
实例
verse = '野渡无人舟自横'
byte = verse.encode('GBK')  # 采用GBK编码转换为二进制,不处理异常
print('原字符串:',verse)    # 输出原字符串(没有改变)
print('转换后:',byte)    # 输出转换后的二进制数据,如果用UTF-8来转换呢?
使用decode()方法解码
decode()方法是bytes对象的方法,用于将二进制数据转换为字符串,即将encode()方法转换的结果还原为字符串,也称为“解码”。
语法格式:bytes.decode([encoding= “utf-8”][,errors= “strict”])
- bytes:表示要进行转换的二进制数据,通常是encode()方法转换的结果;
- encoding = “utf-8”:可选参数,用于指定转码时采用的字符编码,默认为UTF-8。若需使用简体中文,可设置为gb2312。当仅有此参数时,可省略“encoding=”,直接写编码值;
- errors = “strict”:可选参数,用于指定错误处理方式,可选值包括strict(遇到非法字符抛出异常)、ignore(忽略非法字符)、replace(用“?”替换非法字符)或xmlcharrefreplace(使用XML字符引用)等,默认值为strict。
实例
verse = '野渡无人舟自横'
byte = verse.encode('GBK')  # 采用GBK编码转换为二进制,不处理异常
print('原字符串:',verse)    # 输出原字符串(没有改变)
print('转换后:',byte)    # 输出转换后的二进制数据,如果用UTF-8来转换呢?
print('解码后:',byte.decode('GBK'))  # 对二进制数据进行解码
总结
到此这篇关于Python字符串常规操作大全的文章就介绍到这了,更多相关Python字符串操作内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















