


Python四大核心高级数据类型详解:字符串、列表、元组与字典

发布时间:2026-10-14 |
3人浏览过
本文系统讲解Python中四大核心高级数据类型。涵盖字符串的下标与切片机制、列表的增删改查及排序、元组的不可变特性与特殊可变元素处理,以及字典的键值对存储、安全访问与深浅拷贝。通过代码示例解析count、index、get等常用方法,帮助开发者掌握高效数据处理技巧。
一、字符串
在现实生活中,大巴车的座位通常按顺序编号,每个位置对应唯一的索引。Python中的字符串同样具备这种有序性,每个字符都拥有对应的下标,我们可以通过下标精准提取字符串中的特定字符。
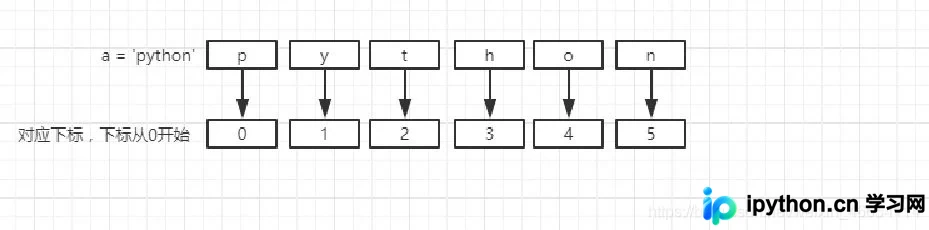
- Python提供了切片(Slicing)功能,用于截取字符串的指定片段。需要注意的是,切片操作遵循“左闭右开”原则,即截取的内容包含起始下标对应的字符,但不包含结束下标对应的字符。
- 切片的标准语法格式为:[起始下标:结束下标:步长]。其中,步长参数决定了获取字符的间隔频率,例如步长为2表示每隔一个字符取一个值。
需要特别区分的是,直接通过下标访问字符串时若索引超出范围会引发越界错误,而使用切片操作时即使下标超出字符串长度也不会报错,而是返回尽可能多的可用字符。
字符串内置了丰富的常用函数,用于处理文本数据。
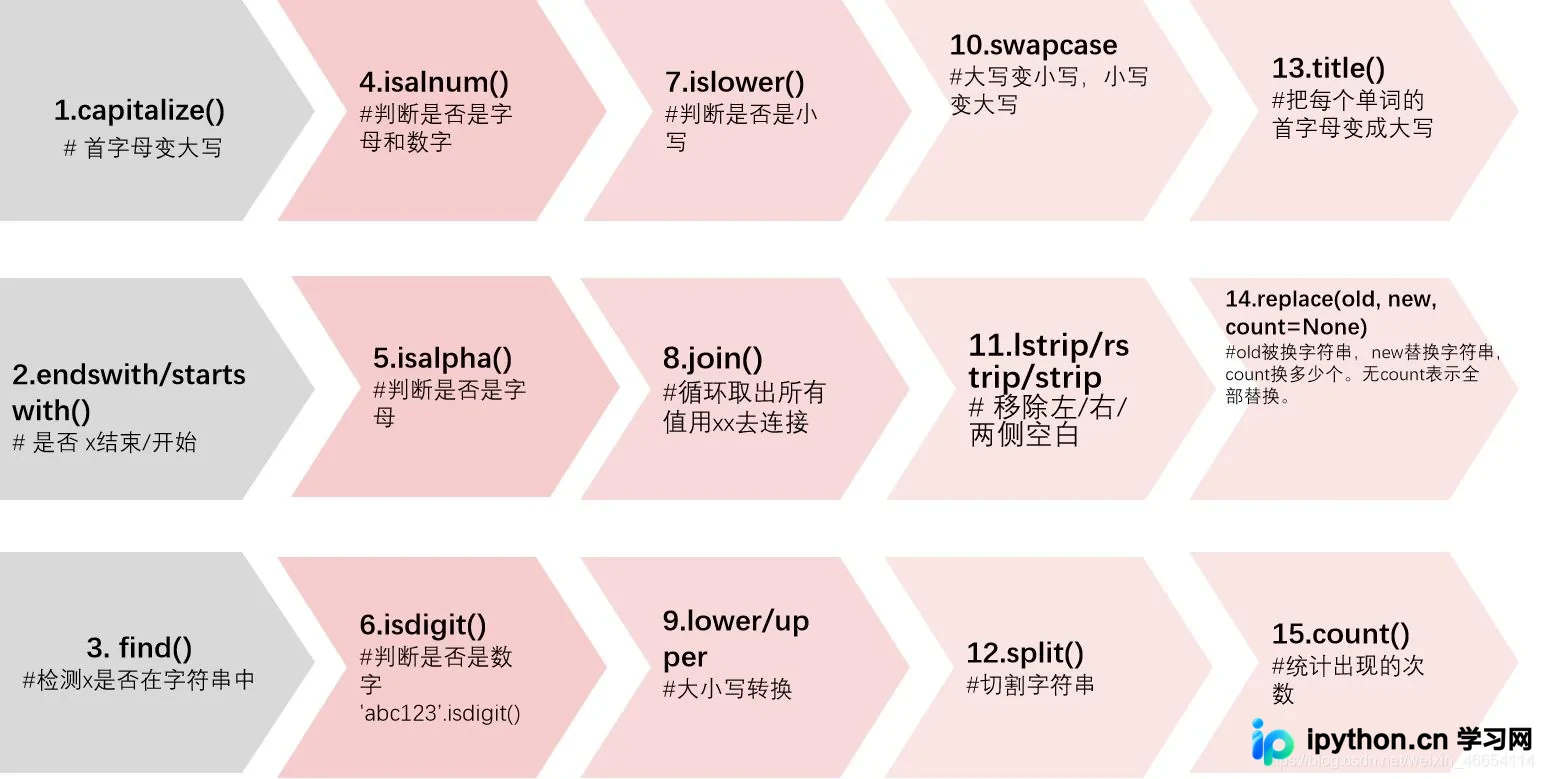
以下是字符串操作的练习代码示例。
Test='rodma  '
print(type(Test))
print('Test的一个字符串%s'%Test[0])#跟数组差不多
#循环输出
for i in Test:
     print(i,end=" ")#也可以用‘ '
print('\n')

# count():统计出现的次数
print(Test.count('r'))

# join():循环取出所有值用xx去连
str='-'
print(str.join(Test))

#去除两边空格strip(),去除右边空格:lstrip(),去除右边空格:rstrip
print(Test.strip())

#复制字符串,id函数可以查看对象的内存地址
print('Test的内存地址%d'%id(Test))
b=Test #在此只是把a对象的内存地址赋给了b
print('Test的内存地址%d'%id(Test))
print(b)

#定义一个数接下来用
datastr='i love Python'
#find函数:可以查找目标对象在序列对象中的为值,如果没找到就返回-1
print(datastr.find('M'))
# index()函数:检测字符串中是否包含子字符串 返回的是下标值
print(datastr.index('i'))
#find 和 index 的区别:如果index没有找到对象就会报错,find输出-1,找到输出0

#starswith()函数:判断开头,如果是就true
#endswith()函数是判断结尾
print(datastr.startswith('i'))

# capitalize():首字母转换为大写
# isalnum():判断是否是字母和数字,全部是字母就输出true,有空格也不行
# isalpha() :判断是否是字母
# isdigit():判断是否全部是数字
# swapcase():大写变小写,小写变大写
# title() :把每个单词的首字母变成大写
# lower():装换为小写。
# upper():转换为大写

a='tsx'
print(type(a))
print(datastr.capitalize())
print(a.isalnum())
print(datastr.isalpha())
print('abc123'.isdigit())
print(datastr.swapcase())
print(datastr.title())
print(datastr.lower())
print(datastr.upper())

# 切片:是指截取字符串中的其中一段内容。
# 切片使用语法:[起始下标:结束下标:步长]
# 切片截取的内容不包含结束下标对应的数据,步长指的是隔几个下标获取一个字符。
# slice [start:end:step] 左闭右开  start<=value<end 范围
# 下标会越界,切片不会
#记住左闭右开的原则

# 定义一个对象
strmgs='Never give up'

# 1——8之间的数据
print(strmgs[1:8])
# 第3个字符到最后
print(strmgs[2:])
# 第1个字符到第3个    温馨提示:记住左闭右开的原则
print(strmgs[:3])
# 步长是什么?比如定义2,就是从当前开始到2个下标获取一个字符,在通俗点就是隔一个获取下一个
print(strmgs[::2])
# 负方向是倒序输出,如果步长选为-1,则反方向输出
print(strmgs[::-1])
# 同理,如果步长是-2,则反方向隔两个下标获取一个字符
print(strmgs[::-2])

# 共有方法有三种 + * in
# +:两个对象相加操作,会合并两个对象
# *:对象自身按指定次数进行 + 操作
# in:判断指定元素是否存在于对象中,输出的是bool值

strA='I love'
strB='Python'
print(strA+strB)
print(strA*3)
print('I' in strA)

'''输出
<class 'str'>
Test的一个字符串r
r o d m a

1
r-o-d-m-a- -
rodma
Test的内存地址1863907131504
Test的内存地址1863907131504
rodma
-1
0
True
<class 'str'>
I love python
True
False
False
I LOVE pYTHON
I Love Python
i love python
I LOVE PYTHON
ever gi
ver give up
Nev
Nvrgv p
pu evig reveN
p vgrvN
I lovePython
I loveI loveI love
True
'''
二、列表
列表(List)是Python中最常用的有序集合类型,使用方括号[]定义。其核心优势在于可变性,允许在运行时动态添加或删除元素。
列表在通过下标取值、切片操作以及越界处理方面的行为与字符串完全一致,主要区别在于列表操作的对象是集合内的具体元素而非字符。
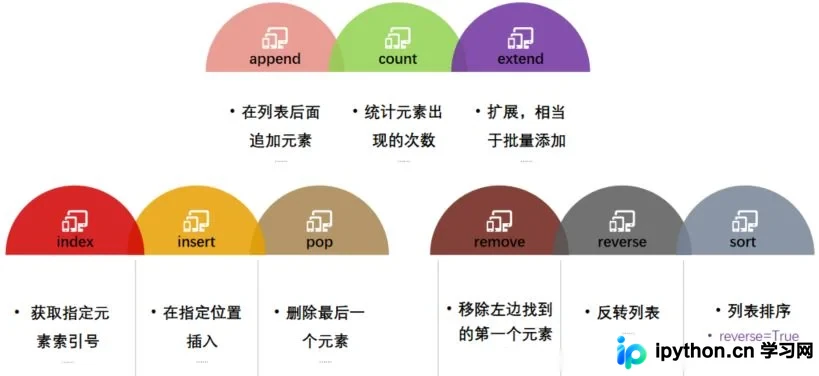
以下是列表操作的练习代码示例。
li=[] # 空列表
li=[1,2,3,4,'python',True]
print(type(li))
# #len函数可以获取到列表对象中的数据个数
print(len(li))

# append();在列表后面追加元素
# count(): 统计元素出现的次数
# extend(): 扩展,相当于批量添加
# index(): 获取指定元素索引号
# insert(): 在指定位置插入
# pop(): 删除后面一个元素
# remove():移除左边找到的第一个元素
# reverse(): 反转列表
# sort():列表排序 reverse=True为倒序

listA=['abcd',785,12.23,'qiuzhi',True]
# print('--------------增加-----------------------')
print('追加之前',listA)
listA.append(['fff','ddd']) #追加操作
listA.append(8888)
print('追加之后',listA)
listA.insert(1,'这是我刚插入的数据') #插入操作 需要执行一个位置插入
print(listA)
rsData=list(range(10)) #强制转换为list对象
print(type(rsData))
listA.extend(rsData) #拓展  等于批量添加
listA.extend([11,22,33,44])
print(listA)
# print('-----------------修改------------------------')
# print('修改之前',listA)
# listA[0]=333.6
# print('修改之后',listA)
listB=list(range(10,50))
print(type(listB))
print('------------删除list数据项------------------')
print(listB)
# del listB[0] #删除列表中第一个元素
# del listB[1:3] #批量删除多项数据 slice
# listB.remove(20) #移除指定的元素  参数是具体的数据值
listB.pop(1) #移除制定的项  参数是索引值
print(listB)
#beg -- 开始索引,默认为0。
#end -- 结束索引,默认为字符串的长度。
print(listB.index(19))  #返回的是一个索引下标


# 查找,跟元祖有点不一样,这是左开右闭

print(type(listA))
print(listA) #输出完整的列表
print(listA[0]) #输出第一个元素
print(listA[1:3]) #从第二个开始到第三个元素
print(listA[2:]) #从第三个元素开始到最后所有的元素
print(listA[::-1]) #负数从右像左开始输出

print(listA*3) #输出多次列表中的数据【复制】

a=[21,45,66,78]
b=[1,2]

def add100(x):
    i= 0
    for item in x:
        x[i]=item+100
        i+=1
        pass
    return x
    pass
print(add100(b))
def add100(x):
    x+=100
    return x
list2=list(map(add100,a))
print(list2)
a=[21,45,66,78]
print(list(map(lambda x:x+100,a)))

def Old(x):
    if x>50:
        return x
    pass
print(list(filter(Old,a)))
'''输出
<class 'list'>
6
追加之前 ['abcd', 785, 12.23, 'qiuzhi', True]
追加之后 ['abcd', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888]
['abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888]
<class 'list'>
['abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44]
<class 'list'>
------------删除list数据项------------------
[10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49]
[10, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49]
8
<class 'list'>
['abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44]
abcd
['这是我刚插入的数据', 785]
[785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44]
[44, 33, 22, 11, 9, 8, 7, 6, 5, 4, 3, 2, 1, 0, 8888, ['fff', 'ddd'], True, 'qiuzhi', 12.23, 785, '这是我刚插入的数据', 'abcd']
['abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44, 'abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44, 'abcd', '这是我刚插入的数据', 785, 12.23, 'qiuzhi', True, ['fff', 'ddd'], 8888, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44]
[101, 102]
[121, 145, 166, 178]
[121, 145, 166, 178]
[66, 78]

'''
三、元组
- 元组(Tuple)在结构上与列表相似,但关键区别在于元组一旦创建便不可修改。元组使用圆括号()定义,同样支持下标访问。
- 创建元组非常简单,只需在括号内添加元素并用逗号分隔即可。即使只包含一个元素,也需保留末尾的逗号以区别于普通括号表达式。
- 元组提供了以下内置方法:
count:用于统计指定元素在元组中出现的次数;index:用于查找指定元素首次出现的下标索引。
以下是元组操作的练习代码示例。
#空元组
tupleA=()
print(type(tupleA))
#元组也可以用for语句查询

tupleA=(1,2,3,'cd','a')
for item in tupleA:
    print(item,end=' ')

# 元组也可以使用切片,左闭右开
print(tupleA[-2:-1:])#倒着取下标 为-2 到 -1 区间的

#假设元组中放入队列
tupleA=(1,2,3,'cd','a',[11,22,33])
print(tupleA)
#可以对队列的值进行修改(原本元组是不可以修改的)
print(type(tupleA[5]))
tupleA[5][0]=5500
print(tupleA)
tupleA[5].append('chen')
print(tupleA)
'''输出
<class 'tuple'>
1 2 3 cd a ('cd',)
(1, 2, 3, 'cd', 'a', [11, 22, 33])
<class 'list'>
(1, 2, 3, 'cd', 'a', [5500, 22, 33])
(1, 2, 3, 'cd', 'a', [5500, 22, 33, 'chen'])
'''
四、字典
- 字典(Dictionary)是Python中重要的高级数据类型,能够存储任意类型的对象,以键值对(Key-Value)形式组织数据。
- 字典通过大括号{}包裹键值对创建,格式如
{'key':'value'}所示。 - 安全访问字典值的推荐方式是使用get方法。当不确定键是否存在时,get方法不会抛出异常,而是返回None或指定的默认值,从而避免程序崩溃。
使用字典时需注意以下限制:
补充说明:字典的键(Key)不能重复,值(Value)可以重复。
字典的键(Key)必须是不可变类型,如整数、字符串或元组;而值(Value)可以是任意类型。此外,字典中的键必须唯一,不能重复,但值可以重复。
字典提供了丰富的常用方法,包括增删改查及排序等功能。
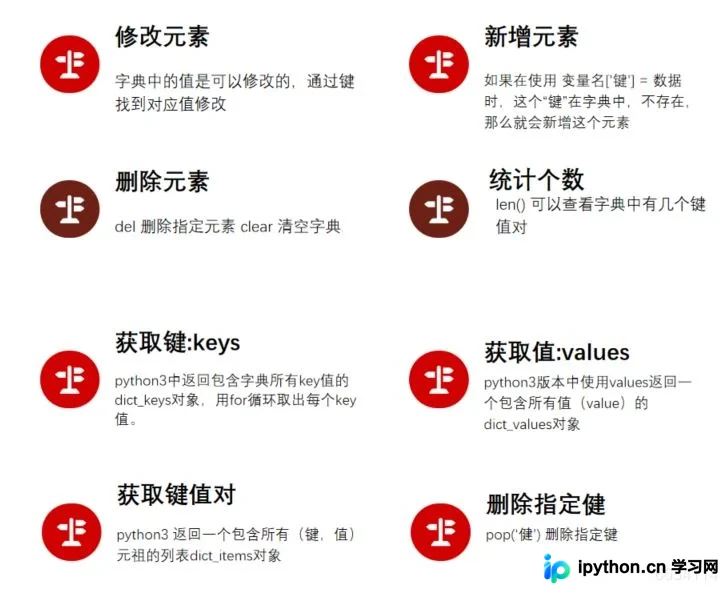
以下是字典操作的练习代码示例。
# 空字典
dictA={}
print(type(dictA))
# 如何添加字典数据? key:value
dictA['name']='陈运智'
dictA['age']=30
print(dictA)
# 批量添加
dictA={"pro":'艺术','shcool':'北京电影学院','age':30,'pos':'xueshen'}
print(dictA)
# 通过键位修改值
dictA['pro']='学生'
print(dictA)
# 添加更多数据
dictA.update({'name':'陈运智'})
print(dictA)
# 获取所有键和值
print(dictA.keys(),dictA.values())
print(dictA.items())
for key,value in dictA.items():
   print('%s==%s'%(key,value))
# 指定键删除
del dictA['name']
print(dictA)
# 按照key和value排序
print(sorted(dictA.keys()))
#print(sorted(dictA.values()))

#拷贝, copy,deepcopy 会拷贝复杂类型,如 list、dict
import copy
dictB=copy.copy(dictA)#浅拷贝
dictc=copy.deepcopy(dictA)#深拷贝

print(id(dictc))
print(id(dictA))
print(id(dictB))

dictB['age']='20'
dictc['age']='20'
print(dictB)
print(dictc)
print(dictA)
print(type(dictB))
print(type(dictc))
以上就是Python中四大核心高级数据类型(字符串、元组、列表、字典)的详细内容。如需了解更多Python数据类型相关知识,请持续关注本站后续文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















