


Python批量生成Word文档:基于Excel数据与DocxTemplate模板实战

本文详解如何利用Python结合docxtpl和xlrd库,实现根据Excel数据批量生成Word文档。通过读取学生成绩Excel文件,利用DocxTemplate引擎对预设模板进行正则替换,并处理字体格式,最终自动生成并保存多个个性化Word文件,适用于批量通知单、证书等场景。
一、需求说明
核心目标是根据现有模板批量生成docx文档。具体流程为:读取Excel文件中的结构化数据,随后利用Python脚本自动化生成对应的docx文档。
二、实验准备
首先需要准备Excel数据源:
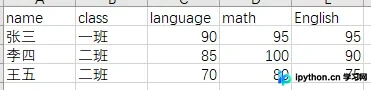
此处使用一份包含学生语文、数学、英语成绩的统计表,文件命名为score.xls。
接着准备Word模板:
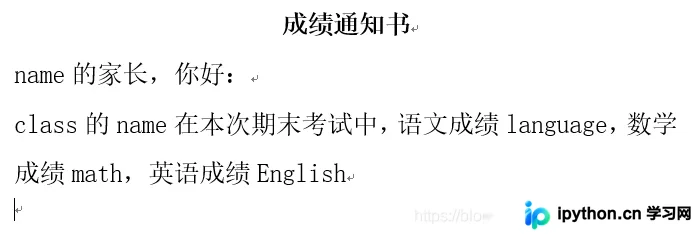
该模板为一份拟发给家长的成绩通知书,文件名为template.doc。
在运行Python脚本前,需通过pip安装第三方库docxtpl和xlrd,执行命令如下:
pip install docxtpl
pip install xlrd
随后,将xls数据文件、doc模板文件以及Python脚本文件放置于同一目录下。
三、代码实现
首先打开xls文件并读取数据:
workbook = xlrd.open_workbook(sheet_path)从工作簿中提取第一个表格:
sheet = workbook.sheet_by_index(0)遍历表格的每一行,将每行数据提取并存储为字典,最终存入列表:
tables = []
for num in range(1, sheet.nrows):
    stu = {}
    stu['name'] = sheet.cell_value(num, 0)
    stu['class'] = sheet.cell_value(num, 1)
    stu['language'] = sheet.cell_value(num, 2)
    stu['math'] = sheet.cell_value(num, 3)
    stu['English'] = sheet.cell_value(num, 4)
    tables.append(stu)
接下来将列表中的数据写入docx文档。实际上,此过程可与数据读取同步进行,即每读取一行数据便立即生成一个文档。
首先在指定路径初始化一个docx文档对象:
document = Document(word_path)随后逐行执行正则表达式替换操作:
paragraphs = document.paragraphs
    text = re.sub('name', stu['name'], paragraphs[1].text)
    paragraphs[1].text = text
    text = re.sub('name', stu['name'], paragraphs[2].text)
    text = re.sub('class', stu['class'], text)
    text = re.sub('language', str(stu['language']), text)
    text = re.sub('math', str(stu['math']), text)
    text = re.sub('English', str(stu['English']), text)
    paragraphs[2].text = text
若无需关注格式,上述步骤已完成。但直接替换会导致被替换文字变为系统默认正文格式,因此需进一步调整格式以符合预期:
遍历需要修改格式的段落,并设置字体大小和字体样式:
for run in paragraph.runs:
            run.font.size = Pt(16)
            run.font.name = "宋体"
            r = run._element.rPr.rFonts
            r.set(qn("w:eastAsia"), "宋体")
最后保存生成的文件:
document.save(path + "\\" + r"{}的成绩通知单.docx".format(stu['name']))完整代码示例如下:
from docxtpl import DocxTemplate
import pandas as pd
import os
import xlrd
path = os.getcwd()
# 读表格
sheet_path = path + "\score.xls"
workbook = xlrd.open_workbook(sheet_path)
sheet = workbook.sheet_by_index(0)
tables = []
for num in range(1, sheet.nrows):
    stu = {}
    stu['name'] = sheet.cell_value(num, 0)
    stu['class'] = sheet.cell_value(num, 1)
    stu['language'] = sheet.cell_value(num, 2)
    stu['math'] = sheet.cell_value(num, 3)
    stu['English'] = sheet.cell_value(num, 4)
    tables.append(stu)
print(tables)

# 写文档
from docx import Document
import re
from docx.oxml.ns import qn
from docx.shared import Cm,Pt
for stu in tables:
    word_path = path + "\\template.doc"
    document = Document(word_path)
    paragraphs = document.paragraphs
    text = re.sub('name', stu['name'], paragraphs[1].text)
    paragraphs[1].text = text
    text = re.sub('name', stu['name'], paragraphs[2].text)
    text = re.sub('class', stu['class'], text)
    text = re.sub('language', str(stu['language']), text)
    text = re.sub('math', str(stu['math']), text)
    text = re.sub('English', str(stu['English']), text)
    paragraphs[2].text = text
    for paragraph in paragraphs[1:]:
        for run in paragraph.runs:
            run.font.size = Pt(16)
            run.font.name = "宋体"
            r = run._element.rPr.rFonts
            r.set(qn("w:eastAsia"), "宋体")
    document.save(path + "\\" + r"{}的成绩通知单.docx".format(stu['name']))
四、实验结果
运行目录下的文件结构:
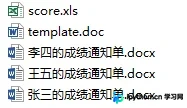
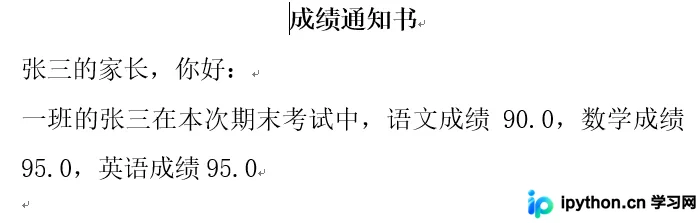
生成的文件样例展示:
到此这篇关于Python批量生成docx文档的文章就介绍到这了,更多相关Python批量生成docx文档内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















