


Python基于Tensorflow构建BP神经网络实现鸢尾花分类

本文详细介绍如何使用Python和Tensorflow 2.0搭建BP神经网络进行鸢尾花分类。通过加载sklearn数据集,定义输入输出矩阵,利用均方误差作为损失函数,并采用梯度下降算法优化权重w和偏置b。代码涵盖数据预处理、模型训练及测试环节,最终实现高准确率的分类预测。
大家好,欢迎来到深度学习的第一篇博客。作为初学者,文中难免有疏漏之处,恳请读者指正,非常感谢。
开发环境配置
本教程基于Python 3.8版本,并搭配Tensorflow 2.0框架进行开发。
问题背景分析
鸢尾花主要包含三个品种:狗尾草鸢尾(标记为0)、杂色鸢尾(标记为1)以及弗吉尼亚鸢尾(标记为2)。研究表明,通过测量花萼长度、花萼宽度、花瓣长度和花瓣宽度这四个特征,可以有效区分不同种类的鸢尾花。因此,只要收集足够多的包含上述特征及对应类别的数据,并选择合适的神经网络架构进行训练,即可实现准确的鸢尾花分类。
神经网络架构设计
模型的输入数据由花萼长、花萼宽、花瓣长、花瓣宽组成,构成一个n行4列的矩阵。输出层则预测每个品种的概率,形成一个n行3列的矩阵。我们选用BP(反向传播)神经网络,设输入数据为X,输出数据为Y,权重矩阵为W,偏置向量为B,其基本运算关系为:
y = x * w + b
鉴于输入x是n行4列矩阵,输出y是n行3列矩阵,权重w必须设计为4行3列的矩阵。每个输出神经元对应一个偏置b,因此b是一个1行3列的矩阵。神经网络结构如下图所示。
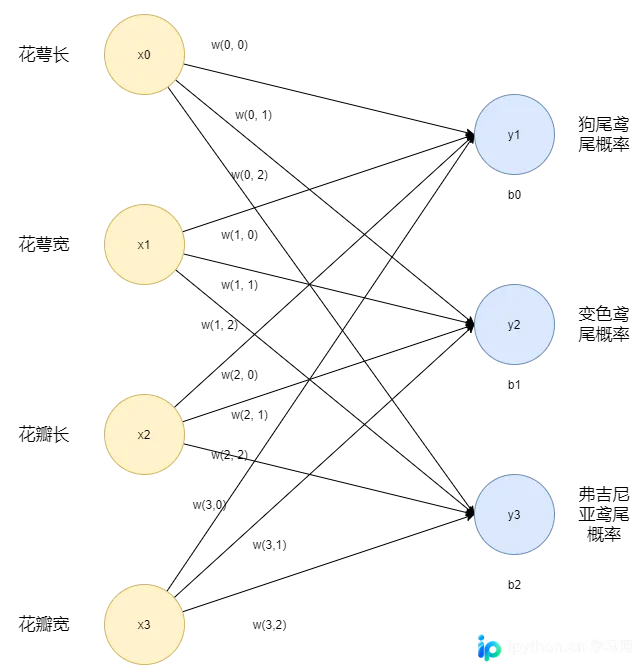
因此,核心任务在于寻找最优的w和b参数,从而实现对鸢尾花种类的精准判断。接下来将详细阐述这两个参数的训练过程。
参数训练策略
损失函数定义
损失函数用于衡量预测值(y*)与真实值(y)之间的差异。在本例中,我们选用均方误差(MSE)公式作为损失函数。
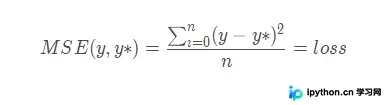
损失函数的值越小,意味着预测值与真实值越接近,对应的w和b参数也就越理想。若依靠人工逐一尝试参数,效率极低且不可行。因此,我们引入梯度下降算法来寻找损失函数的最小值。梯度即函数对各个变量求偏导后组成的向量,梯度下降的方向正是函数值减小的方向。
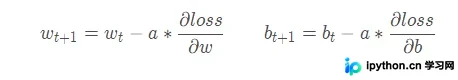
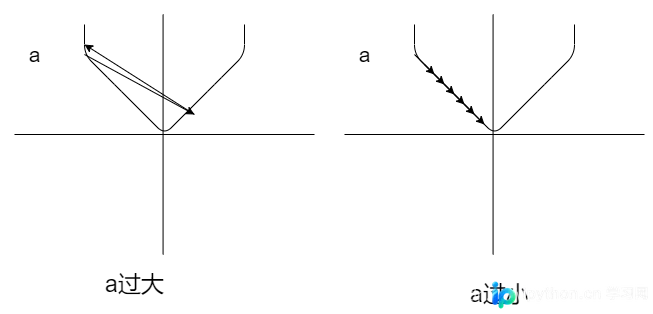
公式中的a代表学习率,即梯度下降的步长。若学习率a设置过大,可能会越过最优解;若a过小,则收敛速度缓慢,需要更多迭代步数才能找到最优值。因此,选择合适的学习率至关重要。
参数优化机制
通过反向传播算法来更新模型参数。反向传播的核心是从输出层向输入层逐层计算损失函数对每一层神经元参数的偏导数,并据此迭代更新所有参数。例如:
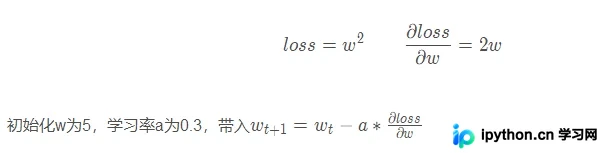
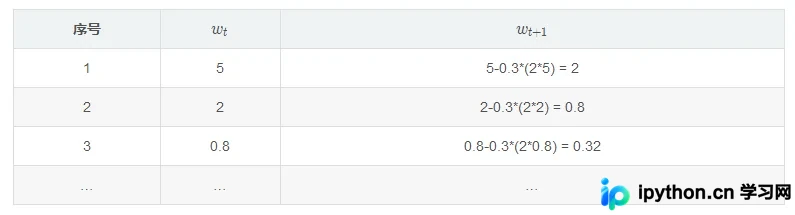
通过迭代过程可以看到,w的值会逐渐趋向于使loss最小化的0附近。以上即为模型训练的关键步骤总结。
代码实现
数据集准备
我们调用sklearn库中内置的鸢尾花数据集,该数据集共包含150组样本。为确保数据的随机性,我们对数据进行打乱处理,并将前120组数据划分为训练集,后30组数据划分为测试集。
# 导入数据,分别为输入特征和标签
x_data = datasets.load_iris().data ## 存花萼、花瓣特征数据
y_data = datasets.load_iris().target # 存对应种类
# 随机打乱数据(因为原始数据是顺序的,顺序不打乱会影响准确率)
# seed: 随机数种子,是一个整数,当设置之后,每次生成的随机数都一样(为方便教学,以保每位同学结果一致)
np.random.seed(116)  # 使用相同的seed,保证输入特征和标签一一对应
np.random.shuffle(x_data)
np.random.seed(116)
np.random.shuffle(y_data)
tf.random.set_seed(116)
# 将打乱后的数据集分割为训练集和测试集,训练集为前120行,测试集为后30行
x_train = x_data[:-30]
y_train = y_data[:-30]
x_test = x_data[-30:]
y_test = y_data[-30:]
# 转换x的数据类型,否则后面矩阵相乘时会因数据类型不一致报错
x_train = tf.cast(x_train, tf.float32)
x_test = tf.cast(x_test, tf.float32)
# from_tensor_slices函数使输入特征和标签值一一对应。(把数据集分批次,每个批次batch组数据)
train_db = tf.data.Dataset.from_tensor_slices((x_train, y_train)).batch(32)
test_db = tf.data.Dataset.from_tensor_slices((x_test, y_test)).batch(32)
模型参数定义
# 生成神经网络的参数,4个输入特征故,输入层为4个输入节点;因为3分类,故输出层为3个神经元
# 用tf.Variable()标记参数可训练
w1 = tf.Variable(tf.random.truncated_normal([4, 3], stddev=0.1)) # 四行三列,方差为0.1
b1 = tf.Variable(tf.random.truncated_normal([3], stddev=0.1)) # 一行三列,方差为0.1
模型训练过程
a = 0.1  # 学习率为0.1
epoch = 500  # 循环500轮
# 训练部分
for epoch in range(epoch):  # 数据集级别的循环,每个epoch循环一次数据集
    for step, (x_train, y_train) in enumerate(train_db):  # batch级别的循环 ,每个step循环一个batch
        with tf.GradientTape() as tape:  # with结构记录梯度信息
            y = tf.matmul(x_train, w1) + b1  # 神经网络乘加运算
            y = tf.nn.softmax(y)  # 使输出y符合概率分布
            y_ = tf.one_hot(y_train, depth=3)  # 将标签值转换为独热码格式,方便计算loss
            loss = tf.reduce_mean(tf.square(y_ - y))  # 采用均方误差损失函数mse = mean(sum(y-y*)^2)
        # 计算loss对w, b的梯度
        grads = tape.gradient(loss, [w1, b1])
        # 实现梯度更新 w1 = w1 - lr * w1_grad    b = b - lr * b_grad
        w1.assign_sub(a * grads[0])  # 参数w1自更新
        b1.assign_sub(a * grads[1])  # 参数b自更新
模型测试与评估
# 测试部分
total_correct, total_number = 0, 0
for x_test, y_test in test_db:
    # 前向传播求概率
    y = tf.matmul(x_test, w1) + b1
    y = tf.nn.softmax(y)
    predict = tf.argmax(y, axis=1)  # 返回y中最大值的索引,即预测的分类
    # 将predict转换为y_test的数据类型
    predict = tf.cast(predict, dtype=y_test.dtype)
    # 若分类正确,则correct=1,否则为0,将bool型的结果转换为int型
    correct = tf.cast(tf.equal(predict, y_test), dtype=tf.int32)
    # 将每个batch的correct数加起来
    correct = tf.reduce_sum(correct)
    # 将所有batch中的correct数加起来
    total_correct += int(correct)
    # total_number为测试的总样本数,也就是x_test的行数,shape[0]返回变量的行数
    total_number += x_test.shape[0]
# 总的准确率等于total_correct/total_number
acc = total_correct / total_number
print("测试准确率 = %.2f %%" % (acc * 100.0))
my_test = np.array([[5.9, 3.0, 5.1, 1.8]])
print("输入 5.9  3.0  5.1  1.8")
my_test = tf.convert_to_tensor(my_test)
my_test = tf.cast(my_test, tf.float32)
y = tf.matmul(my_test, w1) + b1
y = tf.nn.softmax(y)
species = {0: "狗尾鸢尾", 1: "杂色鸢尾", 2: "弗吉尼亚鸢尾"}
predict = np.array(tf.argmax(y, axis=1))[0]  # 返回y中最大值的索引,即预测的分类
print("该鸢尾花为:" + species.get(predict))
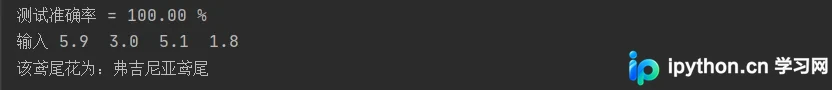
测试结果展示:
总结
本文完整介绍了鸢尾花分类的实现过程。作为深度学习的经典案例,建议读者重点掌握其原理与代码逻辑。欢迎志同道合的学习者在评论区交流想法,我将及时回复并与大家共同讨论。
以上是关于Python使用Tensorflow训练BP神经网络实现鸢尾花分类的详细内容,更多相关技术文章请关注本站其他栏目。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















