


TensorFlow反向传播求导实战与原理解析

本文详细解析TensorFlow中反向传播求导的实现机制,结合具体代码示例展示权重更新过程。通过前向计算与反向链式法则推导偏导数,深入讲解梯度下降优化器在模型训练中的应用,帮助开发者理解底层数学原理与框架行为的对应关系。
首先通过代码示例直观展示实现效果。
X=tf.constant([-1,-2],dtype=tf.float32)
w=tf.Variable([2.,3.])
truth=[3.,3.]
Y=w*X
# cost=tf.reduce_sum(tf.reduce_sum(Y*truth)/(tf.sqrt(tf.reduce_sum(tf.square(Y)))*tf.sqrt(tf.reduce_sum(tf.square(truth)))))
cost=Y[1]*Y
optimizer = tf.train.GradientDescentOptimizer(1).minimize(cost)
with tf.Session() as sess:
    sess.run(tf.global_variables_initializer())
    print(sess.run(Y))
    print(sess.run(w))
    print(sess.run(cost))

    print(sess.run(Y))
    sess.run(optimizer)

    print(sess.run(w))
运行结果如下所示。
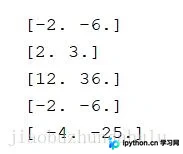
权重矩阵W由初始值[2, 3]更新为[-4, -25]。
具体计算过程分析如下:
目标函数f定义为y0乘以w,即w0*x0*w*x,展开后涉及w1*x1*w0*x0与w1*x1*w1*x1等项的组合。
对w0求偏导,结果为w1*x0*x1加0等于6,因此更新后的w0等于原w0减去6,即-4。
对w1求偏导,结果为w0*x0*x1加上2*w1*x1*x1等于28,因此更新后的w1等于原w1减去28,即-25。
补充说明:本节重点探讨TensorFlow框架下的反向传播机制。
一、背景概述
反向自动求导是TensorFlow的核心实现方案。该过程首先执行前向阶段,从输入端到输出端计算各节点的值;随后执行反向阶段,从输出端回溯至输入端,计算所有节点的偏导数。
二、具体实现细节
1. 案例演示
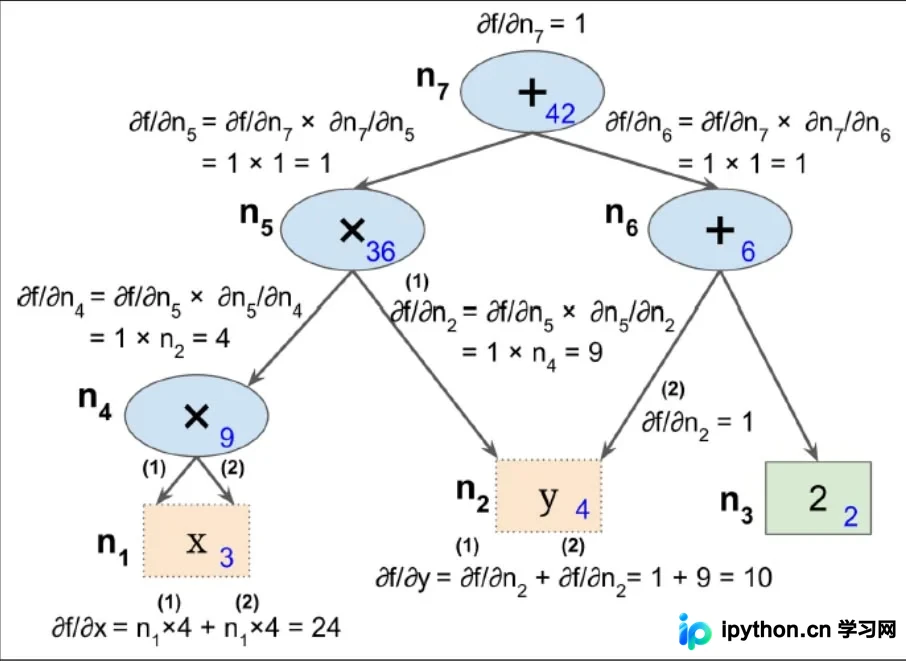
图中展示的是反向传播的第二阶段。在第一阶段中,系统从x=3和y=4开始,逐步计算所有中间节点的值。
目标函数定义为f(x/y) = x^2 * y + y + 2。
求解思路是沿图结构向下逐步计算f(x, y)的偏导数,利用每一个连续节点,直至到达变量节点。此过程严重依赖链式求导法则。
2. 详细推导步骤:
由于n7是输出节点,故f等于n7,因此f对n7的偏导数df/dn7等于1。
继续推导至n5节点,f对n5的偏导数df/dn5等于f对n7的偏导数乘以n7对n5的偏导数。已知df/dn7=1,且因n7=n5+n6,故n7对n5的偏导数为1,因此df/dn5等于1乘以1,结果为1。
继续推导至节点n4,f对n4的偏导数df/dn4等于f对n5的偏导数乘以n5对n4的偏导数。因n5=n4*n2,求得n5对n4的偏导数为n2(即4),故df/dn4等于1乘以4。
沿图结构一路向下计算所有节点,最终可得出f对x的偏导数为24,f对y的偏导数为10。
基于上述类似的方法与逻辑,可进一步计算f对权重w的偏导数。
以上为个人经验总结,希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















