


Python栅格数据分区统计与批量提取实战:基于rasterstats库

本文介绍如何利用Python中的rasterstats库对栅格数据进行分区统计及批量提取。通过geopandas和rasterio读取矢量与栅格数据,演示如何计算特定区域内的平均值等统计指标,并将多个栅格数据中的数值提取为时间序列进行可视化分析。该方法适用于气象、地理信息等领域的大批量数据处理。
栅格数据分区统计与提取概述
在处理地理空间数据时,常需针对特定区域提取栅格数据的统计指标,如计算某省多年降雨数据的分区平均值,或从多个栅格文件中提取指定区域的数值以构建时间序列。为直观展示这一过程,可参考示意图,例如提取某市范围内的数据并生成序列,此操作可通过rasterstats库实现,该库同样支持其他类型的分区统计任务。
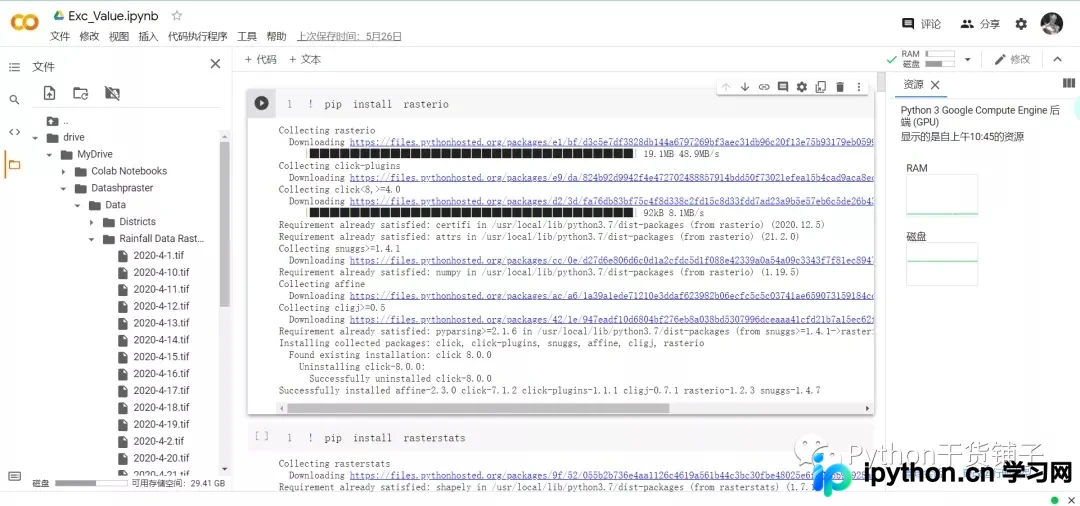
本实验涉及的数据格式包括栅格文件(*.tif)和矢量文件(.shp),后续的分区统计与数值提取均基于这两类数据。为简化环境配置,推荐使用Google Colab平台运行脚本,因其能便捷安装依赖库,解决了Windows环境下常见的安装难题。此外,Colab支持直接链接Google云盘存储的数据,便于在Notebook中直接调用。
环境配置与数据准备
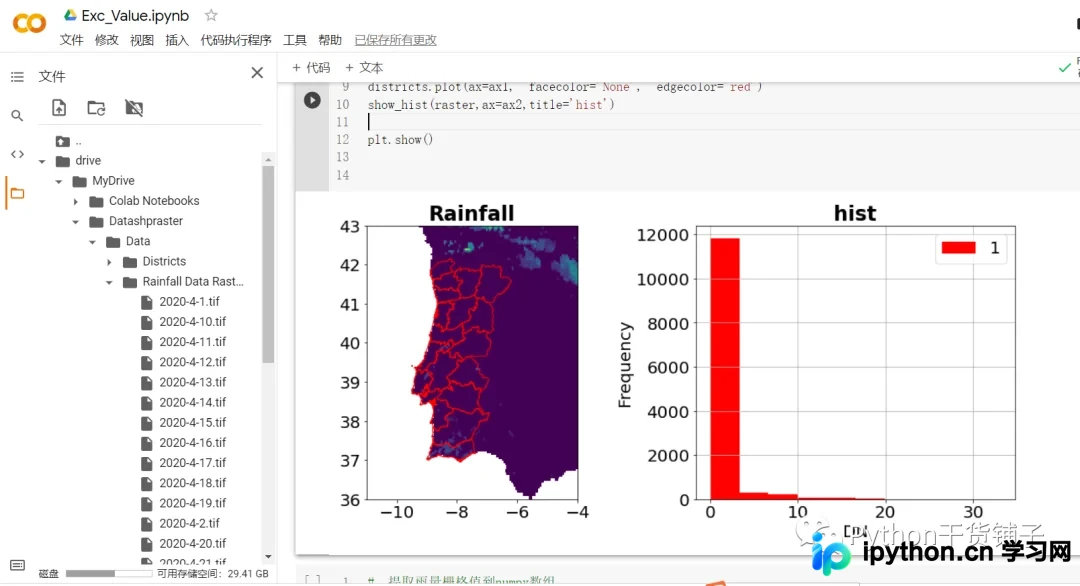
接下来进行具体测试,所用数据为左侧展示的栅格与矢量数据集。首先需要导入必要的Python模块。
import geopandas as gpd
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import rasterio
import rasterstats
from rasterio.plot import show
# show()方法用来展示栅格图形
from rasterio.plot import show_hist
# 用来展示直方图
import cartopy.crs as ccrs
import cartopy.feature as cfeature
from cartopy.mpl.ticker import LongitudeFormatter, LatitudeFormatter
利用geopandas库读取矢量数据,同时使用rasterio库读取栅格数据。
# 使用geopandas读取矢量数据
districts = gpd.read_file('/content/drive/MyDrive/Datashpraster/Data/Districts/districts.shp')

# 使用rasterio读取栅格数据,栅格数据和矢量数据的坐标投影需要一致
raster = rasterio.open('/content/drive/MyDrive/Datashpraster/Data/Rainfall Data Rasters/2020-4-1.tif')
# 把矢量数据和栅格数据绘制到一个axis上,这个axis不是坐标轴,而是图形
plt.rcParams['font.family'] = 'Times New Roman'
plt.rcParams['font.size'] = 20

fig, (ax1,ax2) = plt.subplots(1,2,figsize=(15,6))

show(raster, ax=ax1,title='Rainfall')
# 读取进来的矢量数据可以直接调用gpd的plot()方法绘制
districts.plot(ax=ax1, facecolor='None', edgecolor='red')
show_hist(raster,ax=ax2,title='hist')

plt.show()
首先绘制初步结果以检查数据加载情况。
单栅格数据分区统计实现
具体步骤为读取栅格数据文件。
# 提取雨量栅格值到numpy数组
# 遵循GDAL规则从第一波段读取
rainfall_data = raster.read(1)
rainfall_data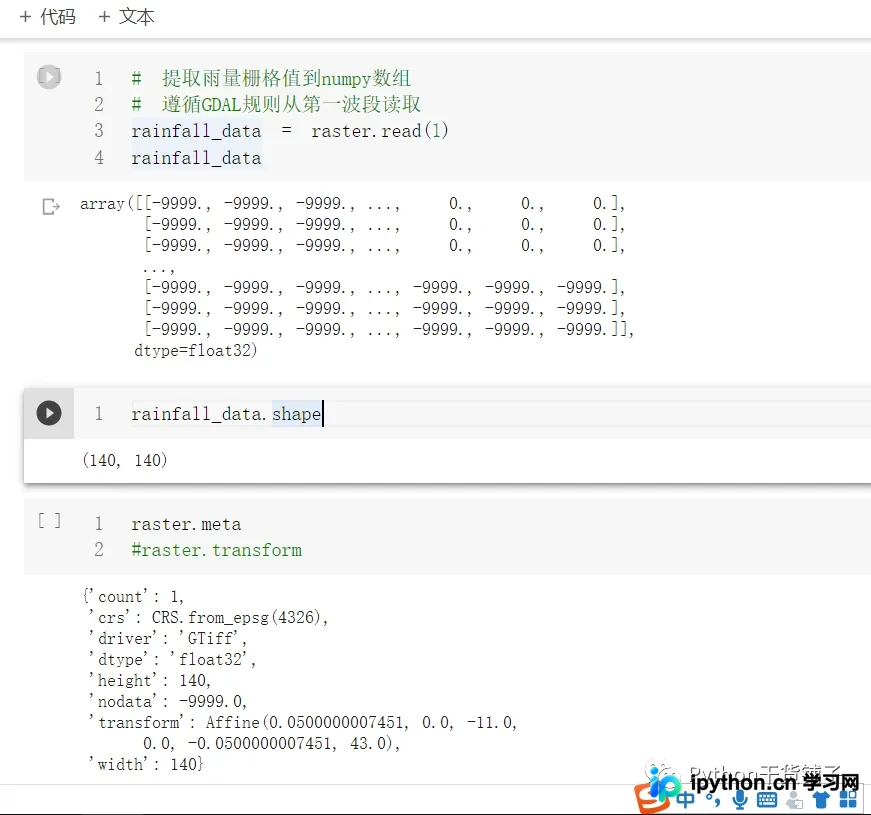
随后执行分区统计计算。
# 设置坐标变换信息
affine = raster.transform

# 准备开始进行空间分区计算
# 第一个参数是矢量分区,第二个是栅格,第三个是坐标变换信息,第四个是统计均值
avg_rallrain = rasterstats.zonal_stats(districts,rainfall_data,affine=affine,stats=['mean'],geojson_out=True)
# avg_rallrain

# 除了统计平均值之外,还有最大最小值那些
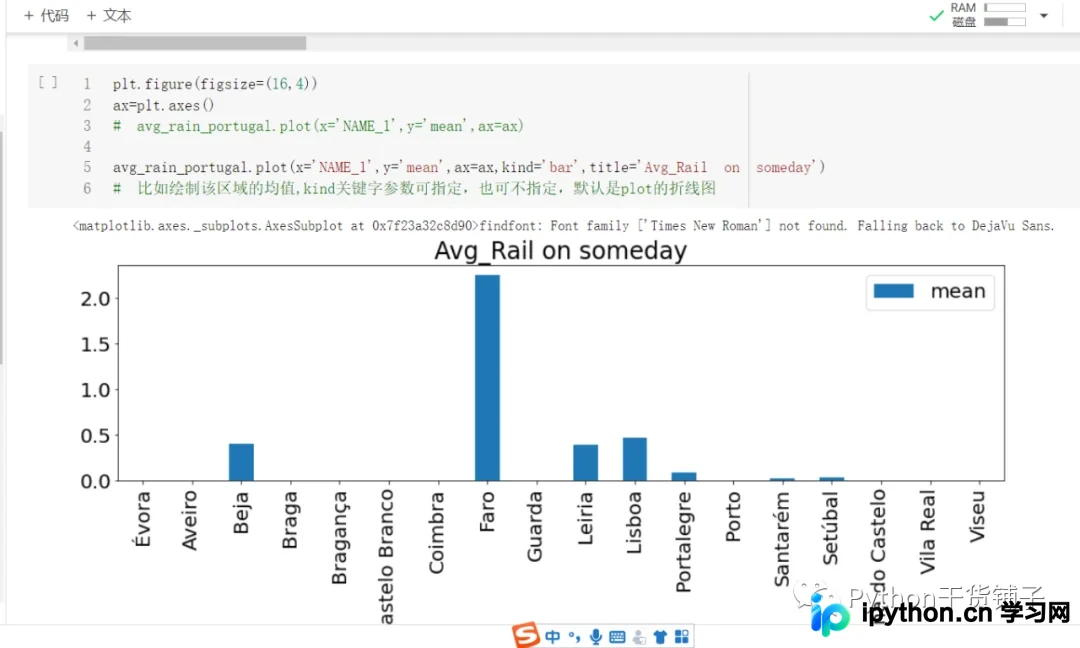
最后绘制统计结果,生成简单的可视化图形。
多栅格数据批量提取与序列分析
第二部分涉及更具实际应用价值的操作:从多个分散的栅格数据中提取数值,构建连续的时间序列。
这些需要处理的文件为多个.tif格式的栅格数据。
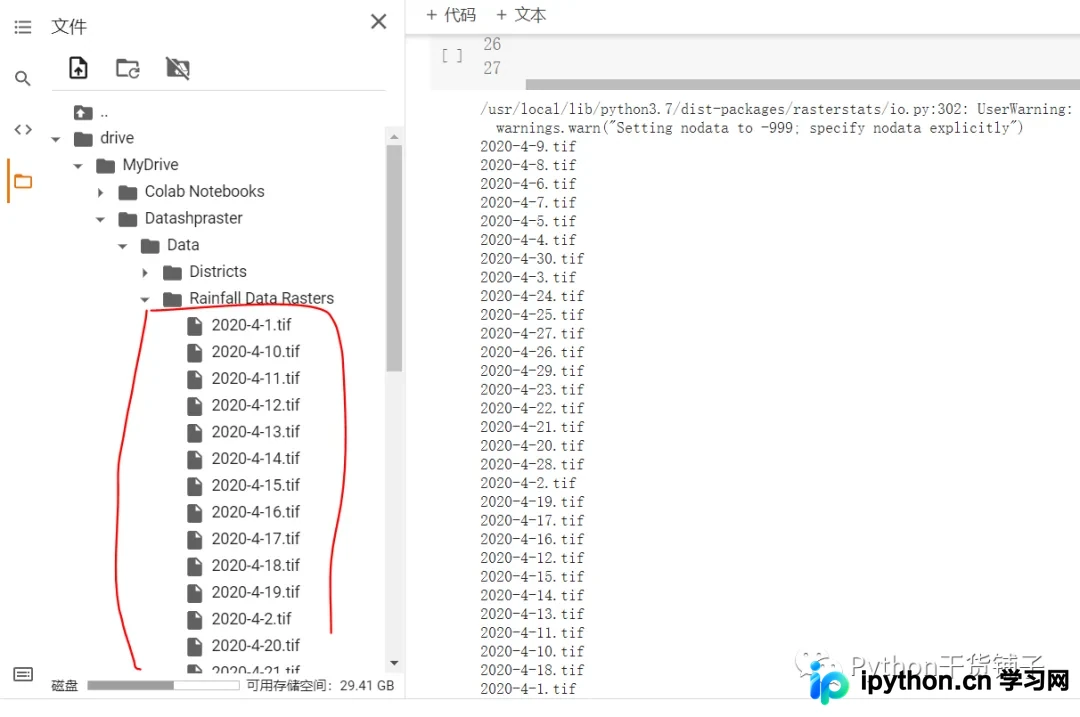
通过循环遍历这些栅格数据集。
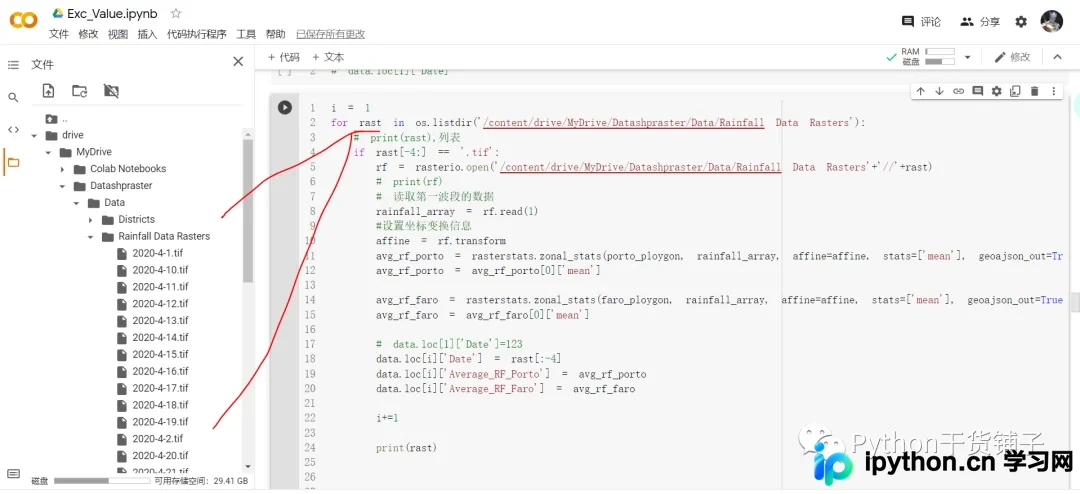
获取提取后的结果,即形成所需的时间序列数据,随后进行绘图展示。
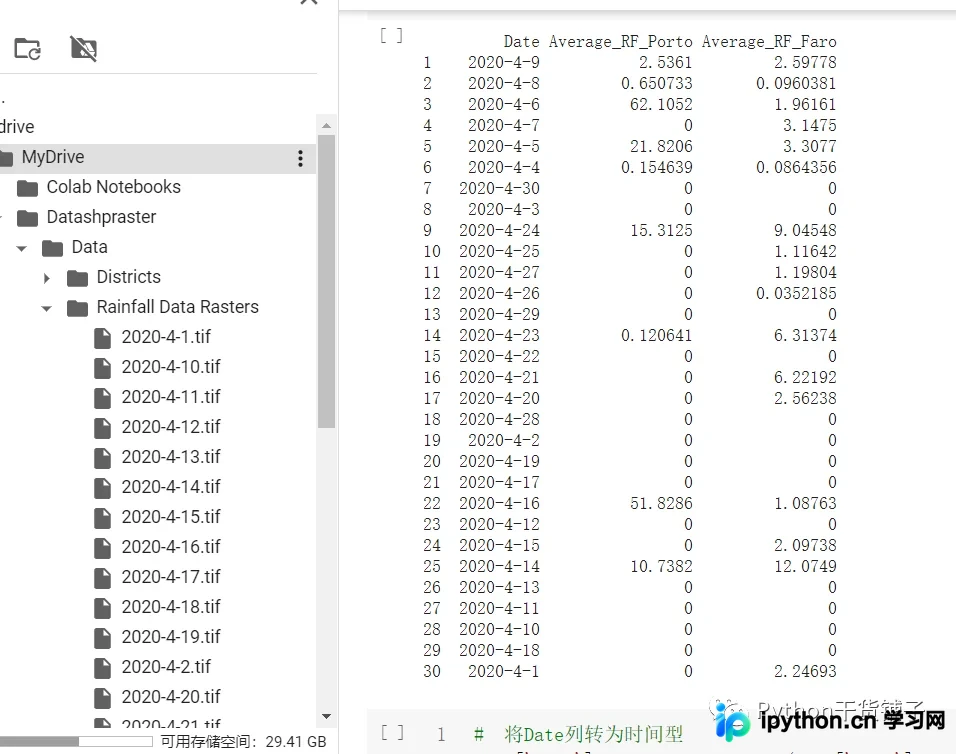
对提取的数据格式进行转换,以便后续处理。
# 将Date列转为时间型
data['Date'] = pd.to_datetime(data['Date'], infer_datetime_format=True)

# print(data)

data['Date'] = data['Date'].dt.date
print(data)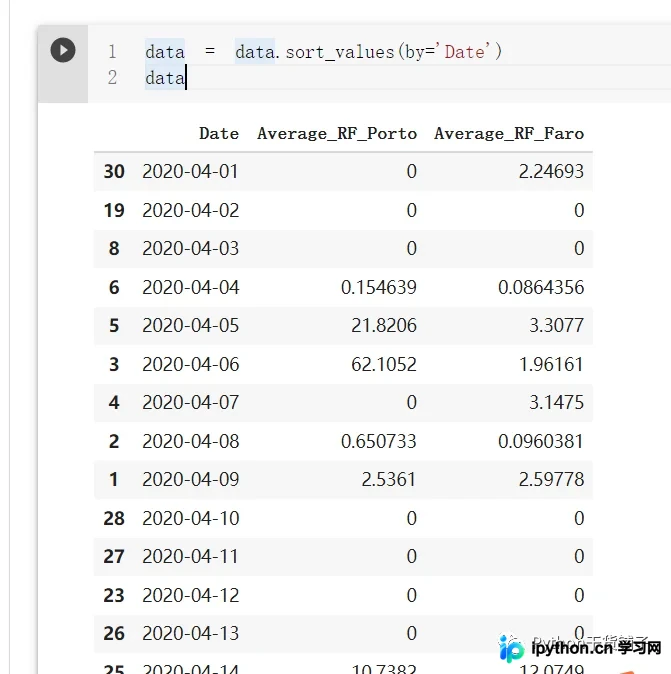
最终的绘图结果呈现为简单的统计图形。
# 准备绘制图形
fig,(ax1,ax2)= plt.subplots(2,1,figsize=(18,6))
plt.rcParams['font.size'] = 15

data.plot(x='Date', y='Average_RF_Porto', ax=ax1, kind='bar', title='Avg_Rail_Porto')
data.plot(x='Date', y='Average_RF_Faro', ax=ax2, kind='bar', title='Avg_Rail_Faro',color='red')

#自动调整图形的分布
plt.tight_layout()
plt.show()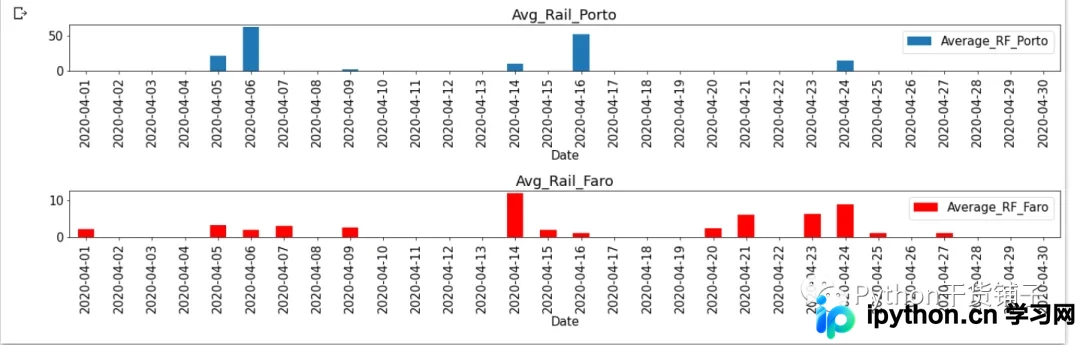
最终结果表现为一个序列图,其核心目的是从栅格中提取指定研究区的数值,并据此绘图分析。
尽管生成的图形可能不够复杂,但该方法在大批量提取栅格值时非常实用。由于在Google Colab中操作涉及较多步骤,文中可能省略了部分中间过程,但关键逻辑均已涵盖。此方法可迁移至其他场景,建议查阅第三方库官方文档(如了解read(1)的具体含义)以获取更多帮助。
以上即为利用Python进行栅格数据分区统计与批量提取的完整流程,更多相关技术细节可参考本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















