


Python脚本实现哔哩哔哩舞蹈区视频批量下载

本文详细介绍如何使用Python脚本批量下载哔哩哔哩舞蹈区视频。内容涵盖通过API获取视频列表、利用BV号转换算法提取唯一ID、获取播放所需的CID及SESSDATA凭证,以及最终使用urllib库完成视频文件的本地保存。
一、抓取列表
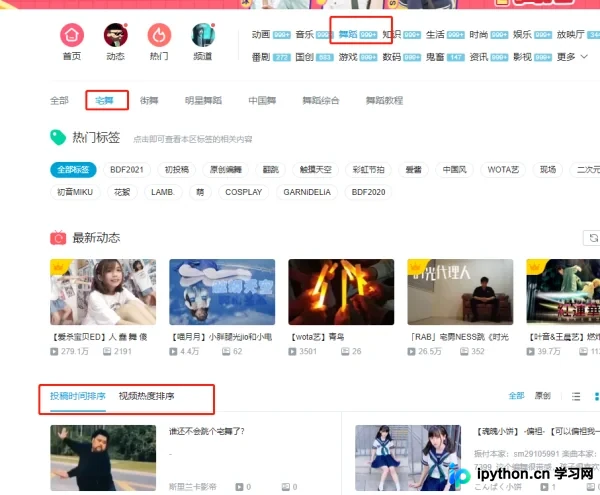
首先访问哔哩哔哩舞蹈区,并在分类中选择“宅舞”列表。
接着打开浏览器开发者工具(F12),定位到一条 https://api.bilibili.com/x/web-interface/newlist?rid=20&type=0&pn=1&ps=20&jsonp=jsonp&callback=jsonCallback_bili_57905715749828263 的API请求URL。该URL中的rid参数代表B站的小分类ID,pn参数代表当前页码。
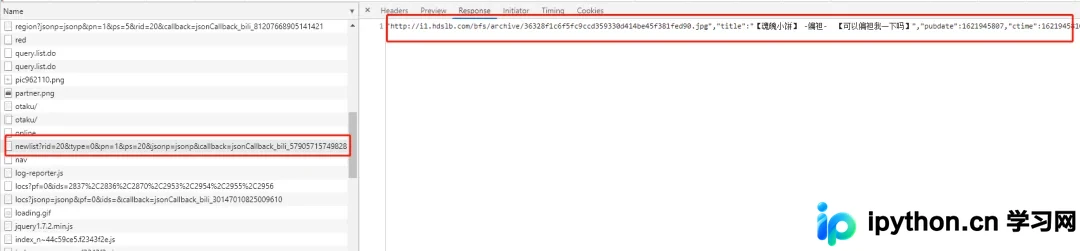
尝试在浏览器直接访问该地址时,系统返回404错误,但在开发者工具的网络面板中观察到的返回值却包含视频列表数据。经过调试,移除URL中的callback参数后,成功获取到预期的JSON数据结果。
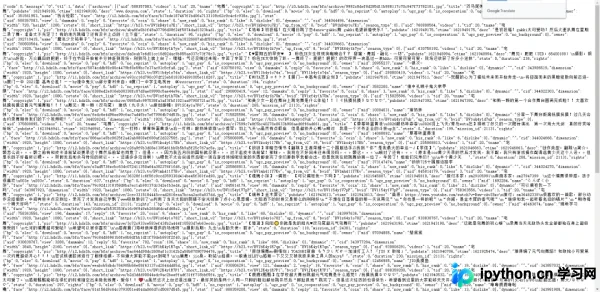
已知bid是哔哩哔哩视频的唯一标识符(BV号)。要获取bid,需从上述API返回的数据中提取aid(AV号),随后通过特定算法将aid转换为bid。
Str = 'fZodR9XQDSUm21yCkr6zBqiveYah8bt4xsWpHnJE7jL5VG3guMTKNPAwcF'  # 准备的一串指定字符串
Dict = {}

# 将字符串的每一个字符放入字典一一对应 , 如 f对应0 Z对应1 一次类推。
for i in range(58):
    Dict[Str[i]] = i

s = [11, 10, 3, 8, 4, 6, 2, 9, 5, 7]  # 必要的解密列表
xor = 177451812
add = 100618342136696320  # 这串数字最后要被减去或加上

def algorithm_enc(av):
    ret = av
    av = int(av)
    av = (av ^ xor) + add
    # 将BV号的格式(BV + 10个字符) 转化成列表方便后面的操作
    r = list('BV          ')
    for i in range(10):
        r[s[i]] = Str[av // 58 ** i % 58]
    return ''.join(r)


def find_bid(p):
    bids = []
    r = requests.get(
            'https://api.bilibili.com/x/web-interface/newlist?&rid=20&type=0&pn={}&ps=50&jsonp=jsonp'.format(p))

    data = json.loads(r.text)
    archives = data['data']['archives']

    for item in archives:
        aid = item['aid']
        bid = algorithm_enc(aid)
        bids.append(bid)

    return bids
二、获取视频的CID
若需下载1080P高清视频,仅拥有bid是不够的,还必须获取登录状态下的Cookie中的SESSDATA值以及视频的cid。
首先登录B站,将Cookie中的SESSDATA字段复制到请求头中。随后,使用地址为 https://api.bilibili.com/x/player/pagelist?bvid= 的API接口,通过传入bid即可返回对应的cid信息。
def get_cid(bid):
    url = 'https://api.bilibili.com/x/player/pagelist?bvid=' + bid

    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.212 Safari/537.36',
        'Cookie': 'SESSDATA=182cd036%2C1636985829%2C3b393%2A51',
        'Host': 'api.bilibili.com'
    }

    html = requests.get(url, headers=headers).json()

    infos = []

    data = html['data']
    cid_list = data
    for item in cid_list:
        cid = item['cid']
        title = item['part']
        infos.append({'bid': bid, 'cid': cid, 'title': title})
    return infos
三、下载视频
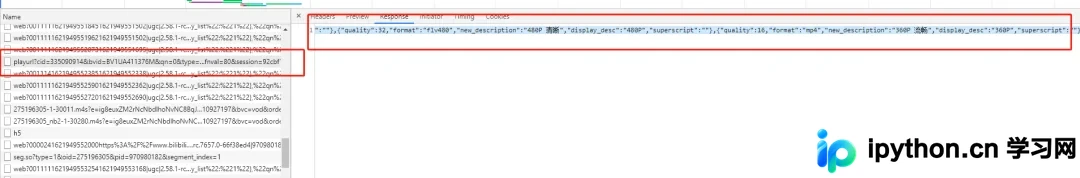
视频下载所需的 https://api.bilibili.com/x/player/playurl 接口地址,通常可在视频播放结束后的推荐列表或播放配置接口中找到。
最后,利用Python标准库中的urllib.request.urlretrieve函数,将获取到的视频流保存至本地文件。
def get_video_list(aid, cid, quality):
    url_api = 'https://api.bilibili.com/x/player/playurl?cid={}&bvid={}&qn={}'.format(cid, aid, quality)
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.212 Safari/537.36',
        'Cookie': 'SESSDATA=182cd036%2C1636985829%2C3b393%2A51',
        'Host': 'api.bilibili.com'
    }
    html = requests.get(url_api, headers=headers).json()
    video_list = []

    for i in html['data']['durl']:
        video_list.append(i['url'])
    return video_list

def schedule_cmd(blocknum, blocksize, totalsize):
    percent = 100.0 * blocknum * blocksize/ totalsize
    s = ('#' * round(percent)).ljust(100, '-')
    sys.stdout.write('%.2f%%' % percent + '[' + s + ']' + '\r')
    sys.stdout.flush()

def download(video_list, title, bid):
    for i in video_list:
        opener = urllib.request.build_opener()
        opener.addheaders = [
            ('User-Agent', 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.212 Safari/537.36'),
            ('Accept', '*/*'),
            ('Accept-Language', 'en-US,en;q=0.5'),
            ('Accept-Encoding', 'gzip, deflate, br'),
            ('Range', 'bytes=0-'),
            ('Referer', 'https://www.bilibili.com/video/'+bid),
            ('Origin', 'https://www.bilibili.com'),
            ('Connection', 'keep-alive'),

        ]

        filename=os.path.join('D:\\video', r'{}_{}.mp4'.format(bid,title))

        try:
            urllib.request.install_opener(opener)
            urllib.request.urlretrieve(url=i, filename=filename, reporthook=schedule_cmd)
        except:
            print(bid + "下载异常,文件:" + filename)
至此,关于编写Python脚本以下载哔哩哔哩舞蹈区所有视频的教程介绍完毕。如需了解更多Python下载哔哩哔哩视频的相关内容,可搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















