


Python读取xlsx文件:xlrd与pandas库实战指南

发布时间:2026-10-14 |
1人浏览过
本文详细介绍如何在Python中读取xlsx格式文件。通过安装并调用xlrd库和pandas库,演示了如何打开工作簿、获取行列数、提取特定单元格及遍历数据。重点展示了使用pandas进行列选择(usecols)和行数限制(nrows)的具体代码实现,帮助开发者快速掌握Excel文件的数据提取技巧。
此前已分享过Python处理Excel文件的多种方法汇总,包括对xlsx格式的操作。本文将延续这一主题,深入讲解利用Python读取xlsx文件的具体实现细节与代码示例。
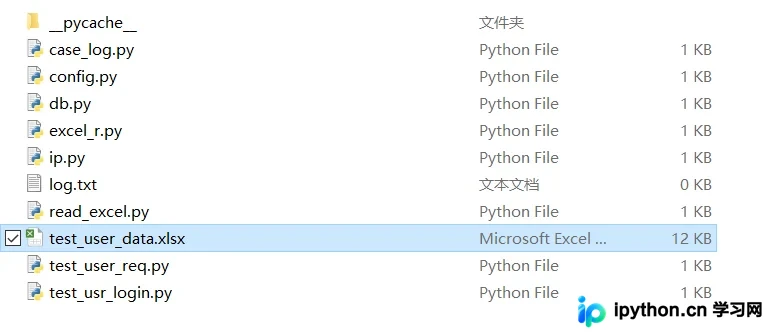
一、准备工作
二、使用xlrd库读取
首先需安装xlrd库,可通过命令 pip install xlrd 完成安装。
import xlrd
#打开excel
wb = xlrd.open_workbook('test_user_data.xlsx')
#按工作簿定位工作表
sh = wb.sheet_by_name('TestUserLogin')
print(sh.nrows)#有效数据行数
print(sh.ncols)#有效数据列数
print(sh.cell(0,0).value)#输出第一行第一列的值
print(sh.row_values(0))#输出第一行的所有值
#将数据和标题组合成字典
print(dict(zip(sh.row_values(0),sh.row_values(1))))
#遍历excel,打印所有数据
for i in range(sh.nrows):
    print(sh.row_values(i))
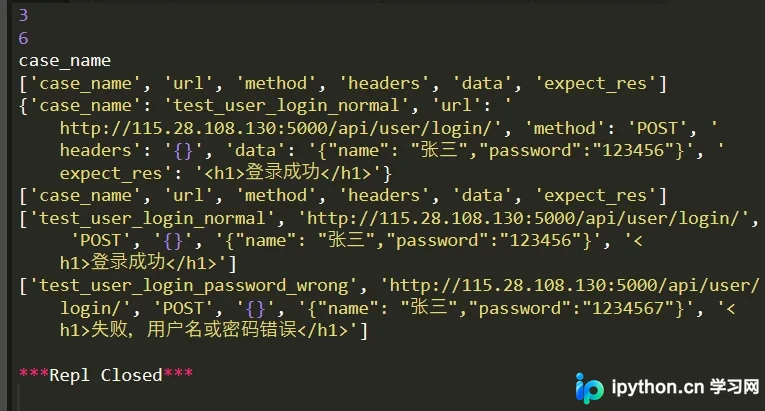
执行上述代码后,终端将输出相应的读取结果。
三、使用pandas库读取
1. 安装pandas库,执行命令:pip install pandas
2. 核心读取代码如下所示。
import pandas as pd

df = pd.read_excel('test_user_data.xlsx')
data=df.values
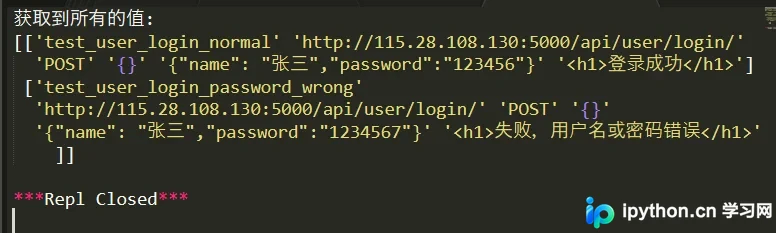
print("获取到所有的值:\n{}".format(data))
运行代码后,控制台将显示如下结果。
3. 行列数据的精细操作
读取指定列的数据
import pandas as pd
#读取第一列、第二列、第四列
df = pd.read_excel('test_user_data.xlsx',sheet_name='TestUserLogin',usecols=[0,1,3])
data = df.values
print(data)
读取指定行数的数据
import pandas as pd
#读取第一行
df = pd.read_excel('test_user_data.xlsx',sheet_name='TestUserLogin',nrows=1)
data = df.values
print(data)
以上内容涵盖了Python操作及读取xlsx格式文件的主要方法,更多关于Python处理xlsx文件的技巧,欢迎查阅本站其他相关文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















