


解决AI智能体搭建常见报错:API连接超时与上下文溢出处理

刚把智能体的逻辑理顺,准备跑个测试,结果屏幕上一片红字:要么是“Connection Timed Out”,要么是“Context Length Exceeded”。这种时刻最搞心态,明明代码逻辑没动,怎么突然就“罢工”了?别急,这通常不是你的算法错了,而是基础设施和资源配置在“闹情绪”。
最先要看的不是代码深处,而是最外层的网络连接和大模型服务的状态。很多时候,超时就是一层窗户纸,捅破了就好;而上下文溢出则是个无底洞,得学会给它装个“盖子”。
1. 排查API连接超时:先通再优
当请求发出去却收不回响应,第一反应往往是“服务器挂了”。但在智能体搭建初期,更多时候是本地环境或中间链路的问题。
首先检查你的API Key是否有效,以及账户余额是否充足。这听起来很基础,但确实是最高频的“乌龙”事件。接着,确认你调用的Endpoint(接口地址)是否正确,特别是区分好全球服和国内加速节点的URL差异。
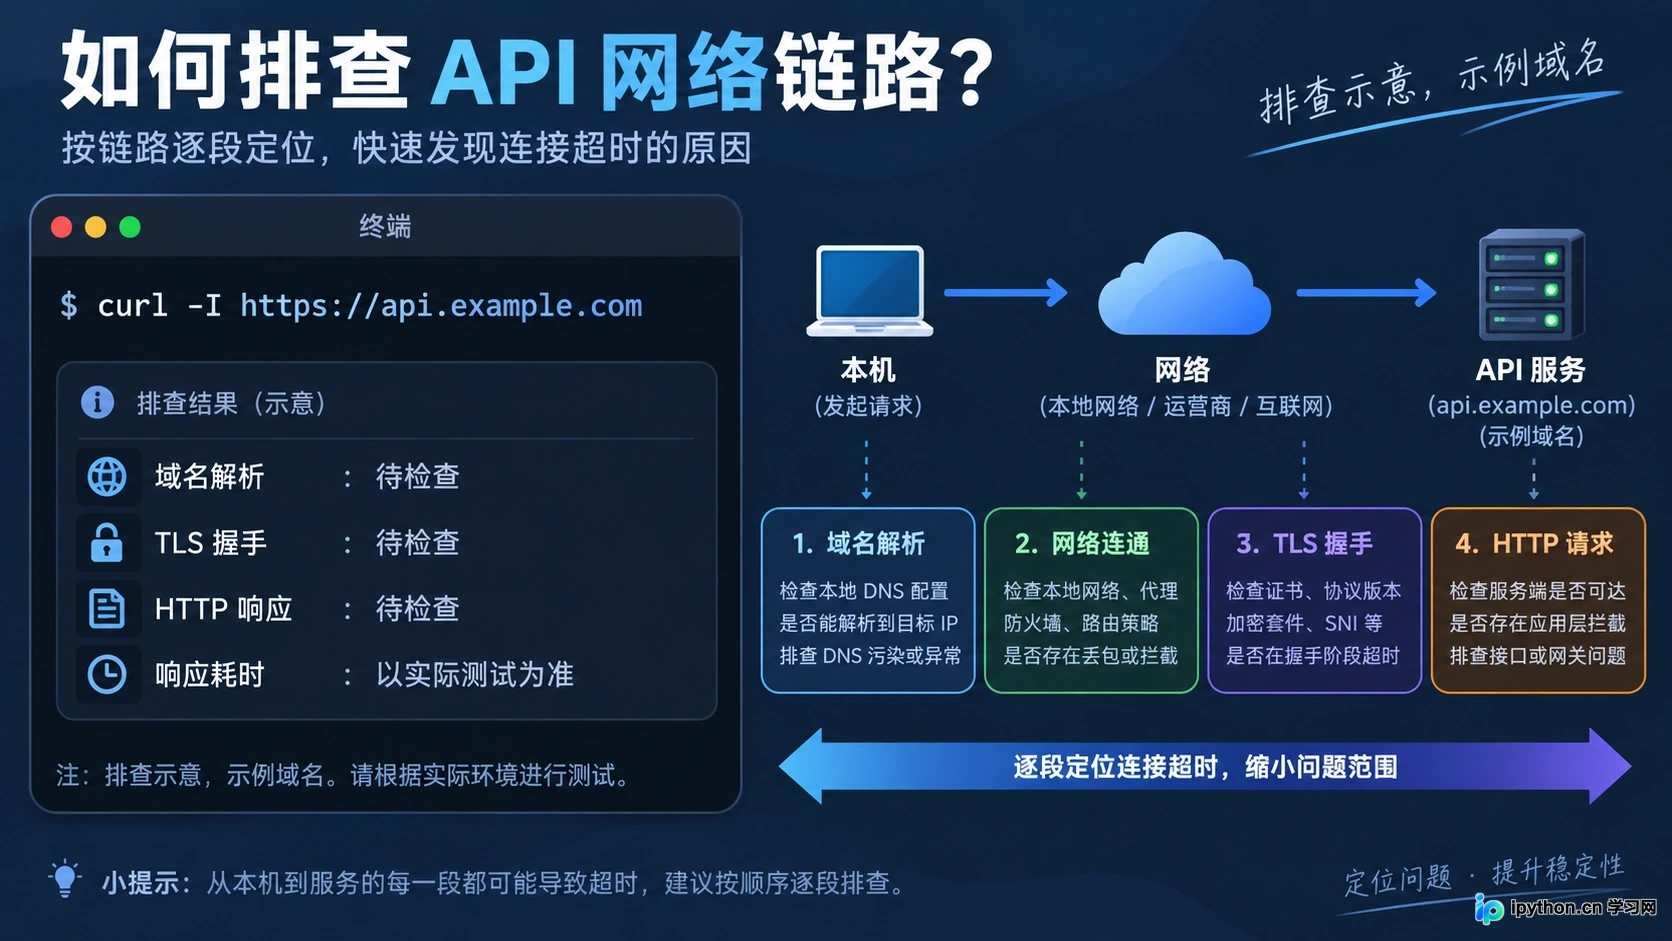
使用终端工具测试API连通性与延迟
如果账号没问题,看看网络延迟。在终端里ping一下API域名,或者用curl简单发个GET请求。如果延迟超过500ms甚至丢包,那可能是本地DNS解析慢,或者是公司防火墙拦截了非标准端口的HTTPS流量。这时候,尝试切换网络环境,或者在代码里增加一个简单的代理配置,往往能立竿见影。
对于偶尔出现的抖动,硬扛不如“软磨”。在代码层面引入指数退避(Exponential Backoff)重试机制。不要一失败就立刻重连,那样容易触发服务商的频率限制(Rate Limit)。设置初始等待1秒,每次失败后等待时间翻倍,最多重试3次。这样既能容错,又不会给服务器造成DDoS般的压力。
2. 应对上下文溢出:给记忆做减法
解决了连通性,接下来是更头疼的“记性太好”。大模型的上下文窗口(Context Window)是有限的,一旦对话轮数多了,或者塞入了长篇文档,就会报“Token limit exceeded”错误。
很多新手喜欢把整个聊天记录原封不动地传给下一轮对话,这在Demo阶段还行,一到真实场景必崩。处理这个问题的核心思路是:只保留必要的信息。
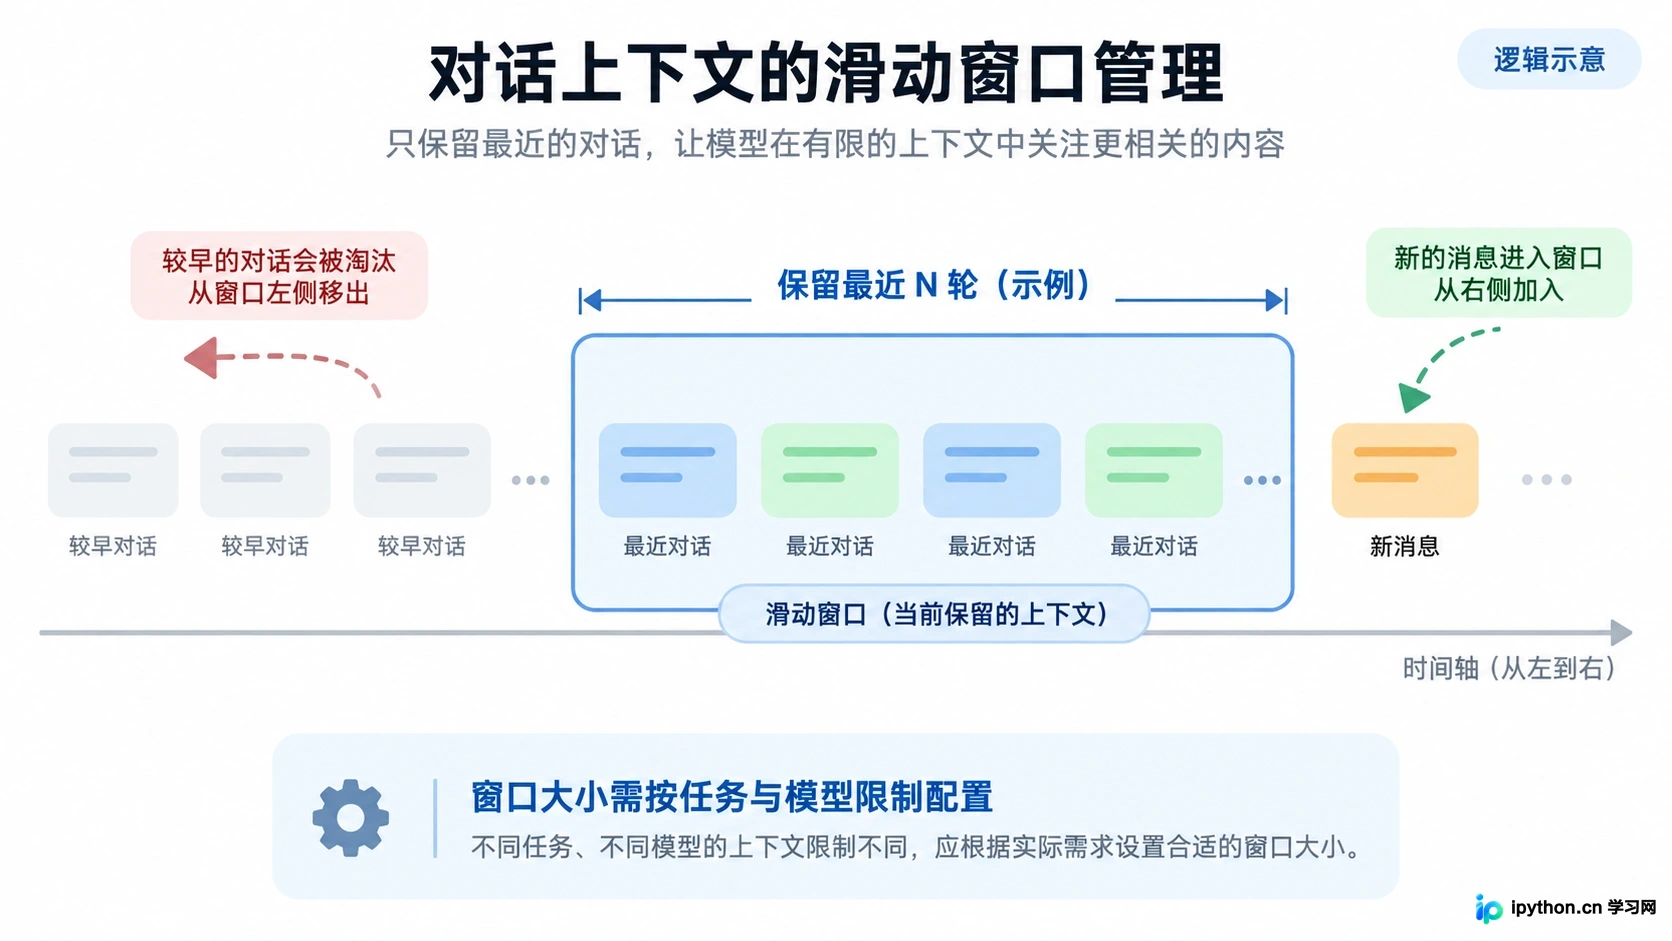
滑动窗口保留最近对话并丢弃旧记录的逻辑示意
最实用的技巧是“滑动窗口”。比如设定只保留最近的5轮对话,更早的记录直接丢弃。虽然这会丢失部分历史,但对于大多数任务型智能体来说,近期的指令权重远高于三天前的闲聊。在代码里,维护一个固定长度的列表,每次新消息加入时,弹出最旧的消息即可。
如果业务要求必须保留长期记忆,那就得用上“摘要压缩”。在对话达到一定长度时,调用一次大模型,让它总结之前的对话要点,然后用这段简短的摘要替换掉原始的长文本。这样既保留了关键语境,又大幅节省了Token。
3. 优化输入结构:剔除无效噪音
有时候,溢出不是因为话多,而是因为“废话”多。检查你的System Prompt(系统提示词)和注入的知识库片段。
很多开发者喜欢在System Prompt里写几千字的背景介绍,其实模型只需要知道它的角色、核心任务和输出格式约束。把那些煽情的、冗余的背景描述删掉,只留干货。对于RAG(检索增强生成)场景,确保检索回来的文档片段是经过清洗的,去掉HTML标签、无关的广告语和重复的页眉页脚。
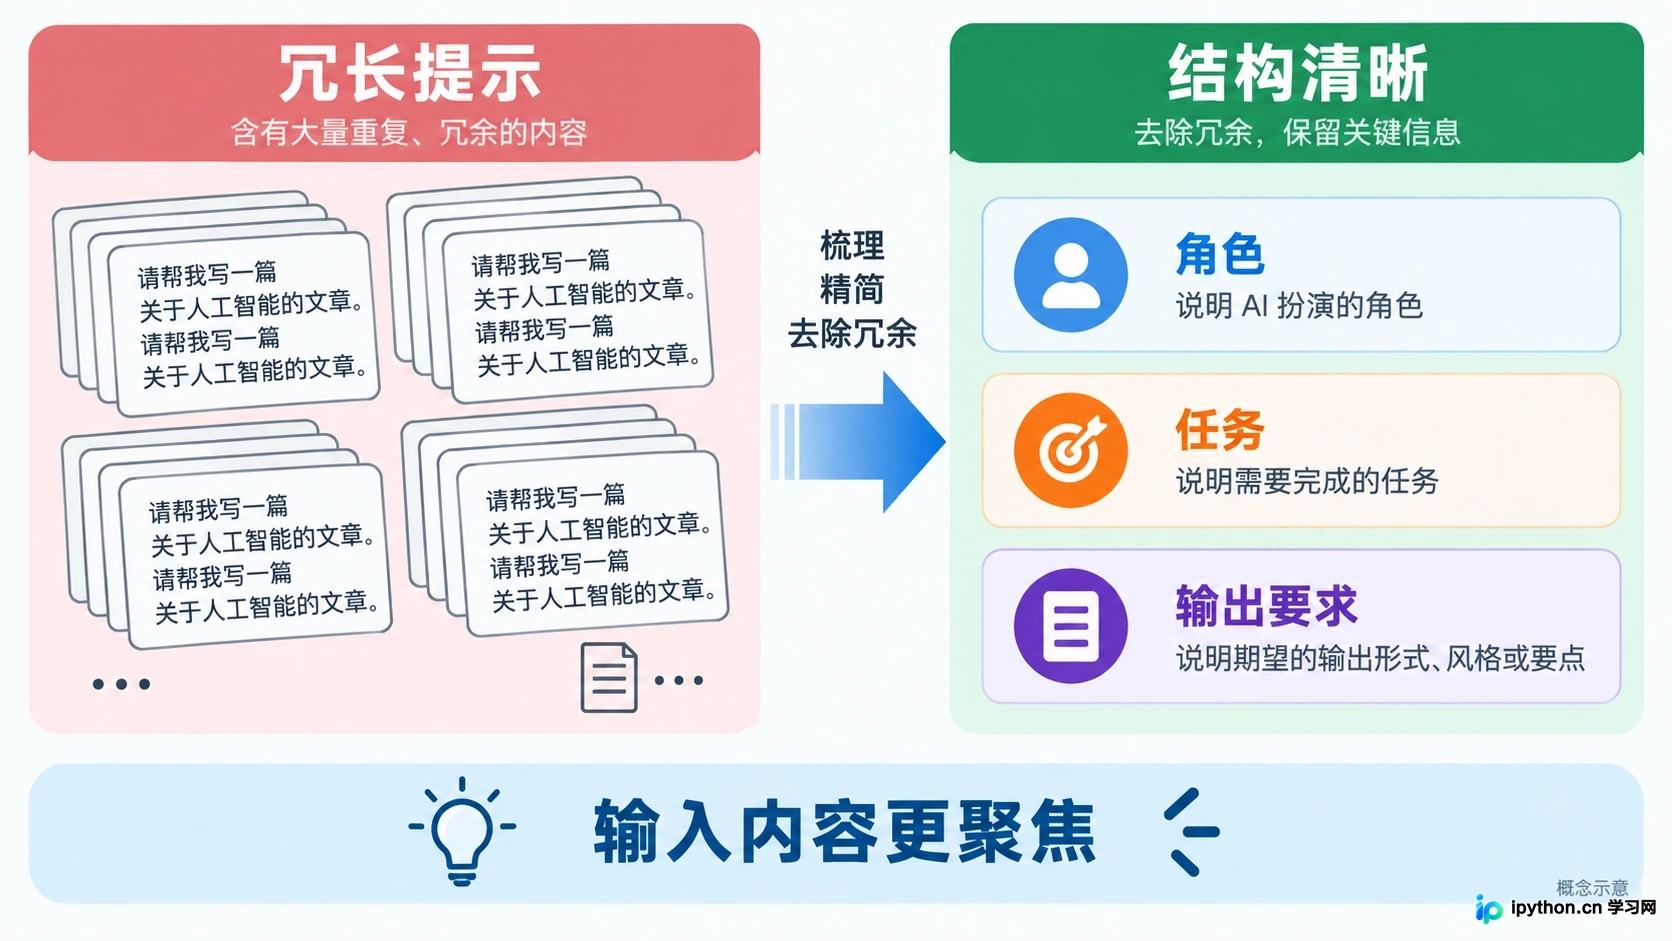
精简系统提示词前后的Token消耗对比
另外,注意编码格式。某些特殊字符或不可见的控制符可能会占用额外的Token,甚至在解析时报错。在发送请求前,对输入文本做一次简单的UTF-8清洗,能避免很多莫名其妙的截断问题。
4. 建立监控与降级策略
最后,别指望一次性完美解决。在生产环境中,一定要加上日志监控。记录每次请求的Token消耗量、响应时间和错误码。
当检测到连续超时或溢出时,智能体应该具备“降级”能力。比如,当上下文快满时,自动触发摘要流程;当API连续失败时,切换到备用模型或返回友好的“稍后再试”提示,而不是直接把堆栈信息甩给用户。
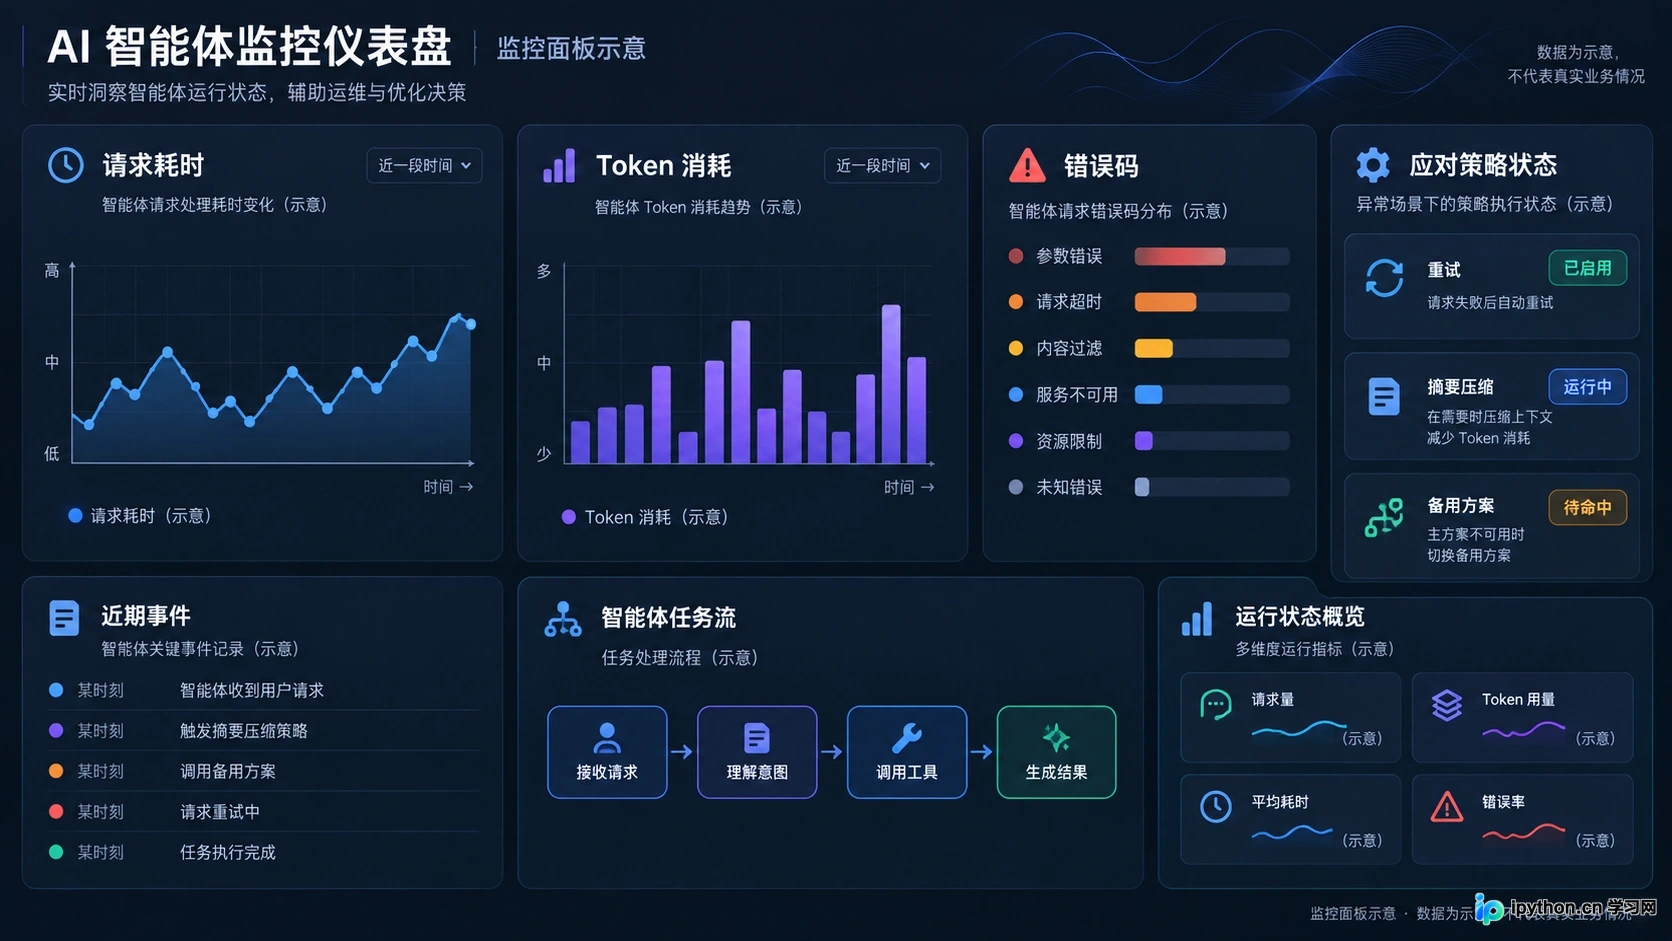
监控请求耗时与Token消耗的简易仪表盘
搭建智能体就像调教一个新员工,既要给它足够的资源(网络和Token),又要教它规矩(重试和截断)。处理好这两个最常见的报错,你的智能体就能从“经常宕机”变得“稳定可靠”,接下来的功能迭代才会顺畅。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















