


Python趣味爬虫之爬取爱奇艺热门电影

发布时间:2026-10-14 |
5人浏览过
本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。
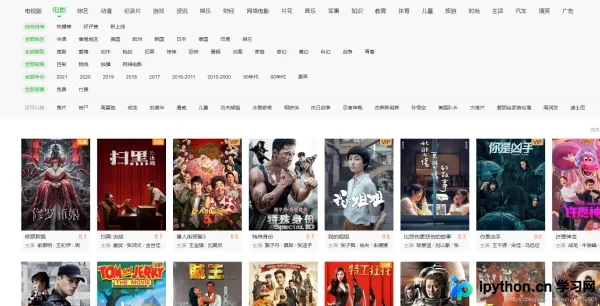
一、确定抓取目标
首先对目标网页进行分析,经确认该页面结构简单,无需处理分页逻辑即可获取全部数据。
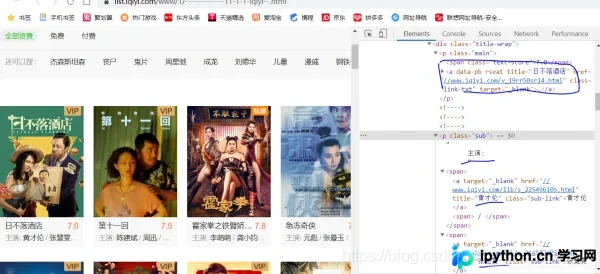
二、使用F12开发者工具查看网页源码
明确获取目标后,需分析数据提取路径。通过检查元素定位包含电影链接的href属性及对应的电影名称文本。
三、编写代码实现数据获取
'''
操作步骤
1,获取到url内容

2,css选择其选择内容

3,保存自己需要数据

'''
#导入爬虫需要的包
import requests
from bs4 import BeautifulSoup
#requests与BeautifulSoup用来解析网页的
import time
#设置访问网页时间,防止自己IP访问多了被限制拒绝访问
import re
class Position():

    def __init__(self,position_name,position_require,):#构建对象属性
        self.position_name=position_name
        self.position_require=position_require

    def __str__(self):
        return '%s%s/n'%(self.position_name,self.position_require)#重载方法将输入变量改成字符串形式

class Aiqiyi():
    def iqiyi(self,url):
        head= {
            'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.67 Safari/537.36 Edg/87.0.664.47"
        }  #模拟的服务器头
        html = requests.get(url,headers=head)
        #headers=hard 让脚本以浏览器的方式去访问,有一些网址禁止以python的反爬机制,这就是其中一个
        soup = BeautifulSoup(html.content, 'lxml', from_encoding='utf-8')  # BeautifulSoup打看网页
        soupl = soup.select(".qy-list-wrap")  # 查找标签,用css选择器,选择自己需要数据 进行选择页面第一次内容(标签要找到唯一的,找id好,如果没有考虑其他标签如class)
        results = []  # 创建一个列表用来存储数据
        for e in soupl:
            biao = e.select('.qy-mod-li')  # 进行二次筛选
            for h in biao:
                p=Position(h.select_one('.qy-mod-link-wrap').get_text(strip=True),
                       h.select_one('.title-wrap').get_text(strip=True))#调用类转换(继续三次筛选选择自己需要内容)
                results.append(p)
        return results  # 返回内容

    def address(self,url):
        #保存网址
        head = {
            'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.67 Safari/537.36 Edg/87.0.664.47"
        }  # 模拟的服务器头
        html = requests.get(url, headers=head)
        soup = BeautifulSoup(html.content, 'lxml', from_encoding='utf-8')  # BeautifulSoup打看网页
        alist = soup.find('div', class_='qy-list-wrap').find_all("a")  # 查找div块模块下的  a标签
        ls=[]
        for i in alist:
            ls.append(i.get('href'))

        return ls


if __name__ == '__main__':
    time.sleep(2)
    #设置2秒访问一次
    a=Aiqiyi()
    url = "https://list.iqiyi.com/www/1/-------------11-1-1-iqiyi--.html"
    with open(file='e:/练习.txt ', mode='a+') as f:  # e:/练习.txt 为我电脑新建的文件,a+为给内容进行添加,但不进行覆盖原内容。
         for item in a.iqiyi(url):
             line = f'{item.position_name}\t{item.position_require}\n'
             f.write(line)  # 采用方法
             print("下载完成")
    with open(file='e:/地址.txt ', mode='a+') as f:  # e:/练习.txt 为我电脑新建的文件,a+为给内容进行添加,但不进行覆盖原内容。
        for item in a.address(url):
            line=f'https{item}\n'
            f.write(line)  # 采用方法
            print("下载完成")
四、运行效果验证
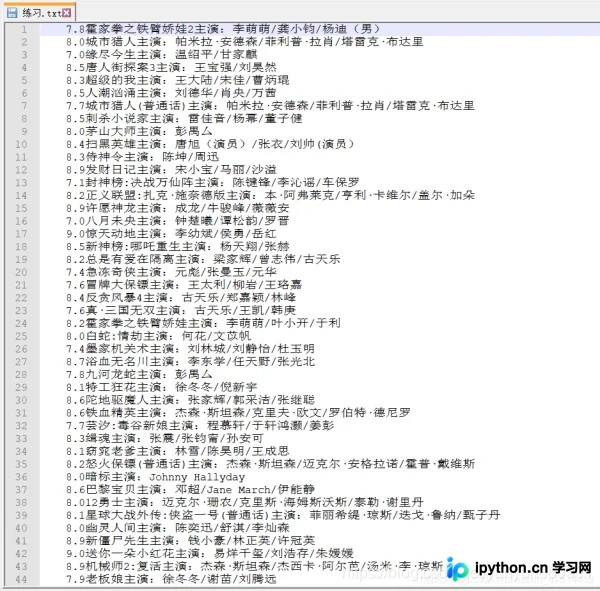
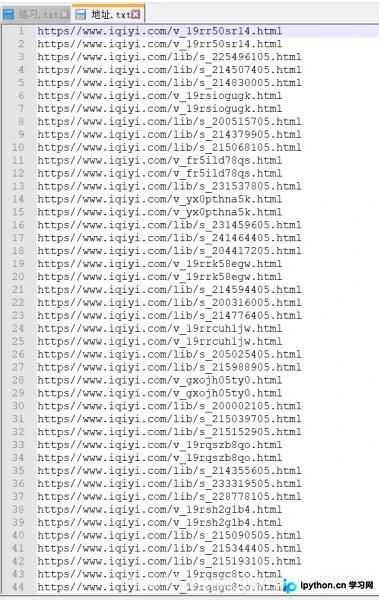
至此,关于Python趣味爬虫之爬取爱奇艺热门电影的介绍已完成。如需了解更多Python爬取电影相关内容,建议搜索本站历史文章或继续阅读后续教程,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















