


Python抓取豆瓣影评数据实战:从PC端解析到移动端API调用

发布时间:2026-10-13 |
5人浏览过
本文详细介绍使用Python抓取豆瓣影评数据的两种方法。首先通过PC端网页分析URL参数,利用Requests和BeautifulSoup解析HTML并递归获取评论;随后介绍更高效的移动端模拟策略,通过修改User-Agent直接调用豆瓣移动端API接口获取JSON数据,简化解析流程并提高抓取效率。
抓取豆瓣影评评分
正常的抓取
分析请求的url
https://movie.douban.com/subject/26322642/comments?start=20&limit=20&sort=new_score&status=P&percent_type=
其中关键的参数包括start和limit。尝试修改limit参数并未产生预期效果,因此可视为使用默认值。此外,start参数用于指定从第几条数据开始查询。
- 通过观察页面中的URL查询部分,可以发现其指向下一个页面的链接。
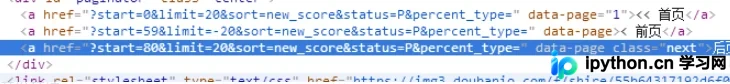
因此,采用以下代码逻辑来判断是否存在下一页数据。
if next_url:
    visit_URL('https://movie.douban.com/subject/24753477/comments'+next_url)
- 使用requests库发送HTTP请求,并配合beautifulsoup库进行网页内容的解析。
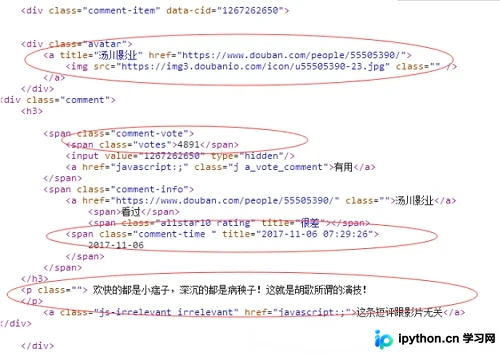
将解析后的数据写入txt文件保存。
import requests
from bs4 import BeautifulSoup
first_url = 'https://movie.douban.com/subject/26322642/comments?status=P'
# 请求头部
headers = {
  'Host':'movie.douban.com',
  'Referer':'https://movie.douban.com/subject/24753477/?tag=%E7%83%AD%E9%97%A8&from=gaia_video',
  'Upgrade-Insecure-Requests':'1',
  'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36',
}
def visit_URL(url):
  res = requests.get(url=url,headers=headers)
  soup = BeautifulSoup(res.content,'html5lib')
  div_comment = soup.find_all('div',class_='comment-item') # 找到所有的评论模块
  for com in div_comment:
    username = com.find('div',class_='avatar').a['title']
    comment_time = com.find('span',class_='comment-time')['title']
    votes = com.find('span',class_='votes').get_text()
    comment = com.p.get_text()
    with open('1.txt','a',encoding='utf8') as file:
      file.write('评论人:'+username+'\n')
      file.write('评论时间:'+comment_time+'\n')
      file.write('支持人数:'+votes+'\n')
      file.write('评论内容:'+comment+'\n')
  # 检查是否有下一页
  next_url = soup.find('a',class_='next')
  if next_url:
    temp = next_url['href'].strip().split('&') # 获取下一个url
    next_url = ''.join(temp)
    print(next_url)
  # print(next_url)
  if next_url:
    visit_URL('https://movie.douban.com/subject/24753477/comments'+next_url)
if __name__ == '__main__':
  visit_URL(first_url)
尝试模仿移动端访问策略。
通常情况下,模拟移动端访问所获得的页面结构比PC端更为简洁,从而更易于解析。在此次模拟移动端的实践中,发现可以直接访问API接口以获取JSON格式的数据,这大大简化了处理流程。

要实现移动端模拟,只需将user-agent字段修改为移动端的请求头信息即可。
useragents = [
  "Mozilla/5.0 (iPhone; CPU iPhone OS 9_2 like Mac OS X) AppleWebKit/601.1 (KHTML, like Gecko) CriOS/47.0.2526.70 Mobile/13C71 Safari/601.1.46",
  "Mozilla/5.0 (Linux; U; Android 4.4.4; Nexus 5 Build/KTU84P) AppleWebkit/534.30 (KHTML, like Gecko) Version/4.0 Mobile Safari/534.30",
  "Mozilla/5.0 (compatible; MSIE 9.0; Windows Phone OS 7.5; Trident/5.0; IEMobile/9.0)"
获取这些特定头部信息的工具,推荐使用火狐浏览器的插件user-agent switcher。
获取数据后的后续操作主要是对JSON格式数据进行解析。
import random
import requests
import json
import time
first_url = 'https://m.douban.com/rexxar/api/v2/tv/26322642/interests?count=20&order_by=hot&start=0&ck=dNhr&for_mobile=1'
url = 'https://m.douban.com/rexxar/api/v2/tv/26322642/interests'
# 移动端头部信息
useragents = [
  "Mozilla/5.0 (iPhone; CPU iPhone OS 9_2 like Mac OS X) AppleWebKit/601.1 (KHTML, like Gecko) CriOS/47.0.2526.70 Mobile/13C71 Safari/601.1.46",
  "Mozilla/5.0 (Linux; U; Android 4.4.4; Nexus 5 Build/KTU84P) AppleWebkit/534.30 (KHTML, like Gecko) Version/4.0 Mobile Safari/534.30",
  "Mozilla/5.0 (compatible; MSIE 9.0; Windows Phone OS 7.5; Trident/5.0; IEMobile/9.0)"
]
def visit_URL(i):
  print(">>>>>",i)
  # 请求头部
  headers = {
    'Host':'m.douban.com',
    'Upgrade-Insecure-Requests':'1',
    'User-Agent':random.choice(useragents)
  }
  params = {
    'count':'50',
    'order_by':'hot',
    'start':str(i),
    'for_mobile':'1',
    'ck':'dNhr'
  }
  res = requests.get(url=url,headers=headers,params=params)
  res_json = res.json()
  interests = res_json['interests']
  print(len(interests))
  for item in interests:
    with open('huge.txt','a',encoding='utf-8') as file:
      if item['user']:
        if item['user']['name']:
          file.write('评论用户:'+item['user']['name']+'\n')
      else:
        file.write('评论用户:none\n')
      if item['create_time']:
        file.write('评论时间:'+item['create_time']+'\n')
      else:
        file.write('评论时间:none\n')
      if item['comment']:
        file.write('评论内容:'+item['comment']+'\n')
      else:
        file.write('评论内容:none\n')
      if item['rating']:
        if item['rating']['value']:
          file.write('对电影的评分:'+str(item['rating']['value'])+'\n\n')
      else:
        file.write('对电影的评分:none\n')
if __name__ == '__main__':
  for i in range(0,66891,20):
    # time.sleep(2)
    visit_URL(i)
总结
以上就是本文的全部内容,希望这些内容能为您的学习或工作提供参考价值。感谢支持。如需了解更多相关信息,请查阅相关链接。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















