


Python提取PDF指定内容并生成新文件

本文通过两个真实需求,演示如何使用Python提取PDF中指定内容并生成新文件。需求一提取包含特定文字“战略”的页面并合并,需求二提取包含图片的页面并单独保存。文章详细梳理了PyPDF2、pdfplumber和fitz模块的逻辑,提供了完整的代码实现,并提示图片识别方法的局限性。
在之前的Python办公自动化专题中,我们已经介绍了如何有选择地提取某些页面进行合并。
然而,在实际应用中,我们往往无法预先知道需要提取的具体页号,而是希望将包含指定内容的页面提取出来,合并生成一个新的PDF文件。本文将通过两个真实的需求案例来进行详细讲解。
01需求描述
假设我们有一份包含286页的上市公司公开年报PDF文件,其大致内容如下:
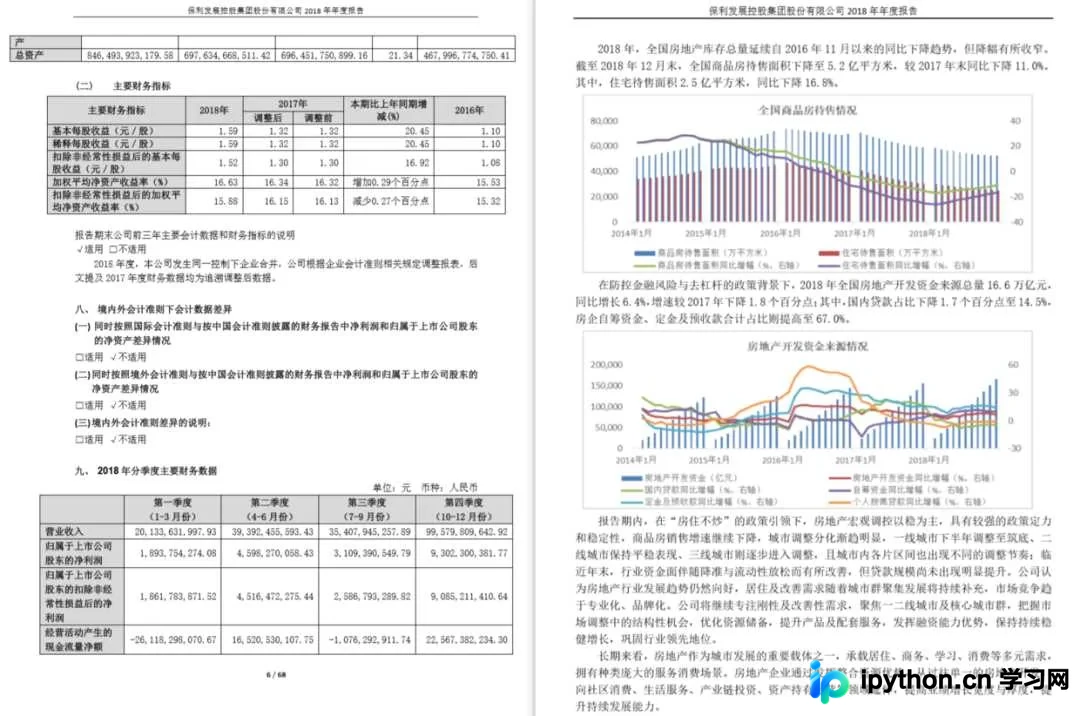
现在,我们需要利用Python完成以下两个具体需求:
“需求一:提取所有包含“战略”二字的页面,并将它们合并生成一个新的PDF文件。
需求二:提取所有包含图片的页面,并将这些页面分别保存为独立的PDF文件。
”
02前置知识和逻辑梳理
2.1 PyPDF2 模块实现合并
使用PyPDF2导入模块的代码通常如下所示:
from PyPDF2 import PdfFileReader, PdfFileWriter
这里我们导入了两个核心方法:
PdfFileReader可以理解为读取器,负责读取PDF文件。PdfFileWriter可以理解为写入器,负责将处理后的内容写入新的PDF文件。
利用PyPDF2实现合并的基本逻辑如下:
- 首先,读取器会将所有PDF页面读取到内存中。
- 接着,读取器将读取到的内容逐页传递给写入器。
- 最后,写入器将所有接收到的页面统一输出到一个新的PDF文件中。
需要注意一个隐含知识点:读取器只能将读取的内容一页一页地交给写入器,无法直接批量操作。
2.2 获取与添加页面
之前我们的推文中提到过这两个代码,下面列出作为复习:
.getPage用于获取特定页。.addPage用于添加特定页到写入器中。
2.3 图片和文字的处理
要实现本文的需求,还需要完成一个重要的判断步骤:确定页面中是否包含特定的文字或图片。
判断是否包含特定文字相对简单,只需在遍历每一页时提取其中的文本,然后进行字符串层面的判断即可。代码思路如下:
- 利用
pdfplumber打开PDF文件。 - 获取指定的页,或者遍历每一页。
- 利用
.extract_text()方法提取当前页的文字。 - 判断“战略”是否存在于提取的文字中。
判断是否包含图片的思路与上述类似,但方法不同。对于图片,我们考虑使用正则表达式进行识别,配合fitz和re模块,具体实现见下文代码。
03代码实现
3.1 需求一的实现
首先来完成需求一的任务,我们需要导入用到的库:读取和写入PDF文件的PyPDF2以及提取文本的pdfplumber。
from PyPDF2 import PdfFileReader, PdfFileWriter
import pdfplumber
指定文件所在的路径,同时初始化写入器,并将文件交给读取器:
path = r'C:\xxxxxx'
pdf_writer = PdfFileWriter()
pdf_reader = PdfFileReader(path + r'\公司年报.PDF')以上下文管理器的形式通过pdfplumber打开文件,同时使用.getNumPages获取读取器的最大页数,以便遍历每一页来提取文字:
with pdfplumber.open(path + r'\公司年报.PDF') as pdf:
    for i in range(pdf_reader.getNumPages()):
        page = pdf.pages[i]
print(page.extract_text())我们提取文字的目的是为了进行判断,将符合条件的页码作为读取器.getPage的参数,最后使用.addPage将页面交给写入器:
with pdfplumber.open(path + r'\公司年报.PDF') as pdf:
    for i in range(pdf_reader.getNumPages()):
        page = pdf.pages[i]
        print(page.extract_text())
        if '战略' in page.extract_text():
            pdf_writer.addPage(pdf_reader.getPage(i))
            print(i + 1, page.extract_text())
完成识别后,让写入器输出为所需的文件名:
with open(path + r'\new_公司年报.pdf', 'wb') as out:
    pdf_writer.write(out)
至此,我们就完成了包含特定文字内容页面的提取,并整合成一个PDF。所有提取的页面均包含“战略”二字:
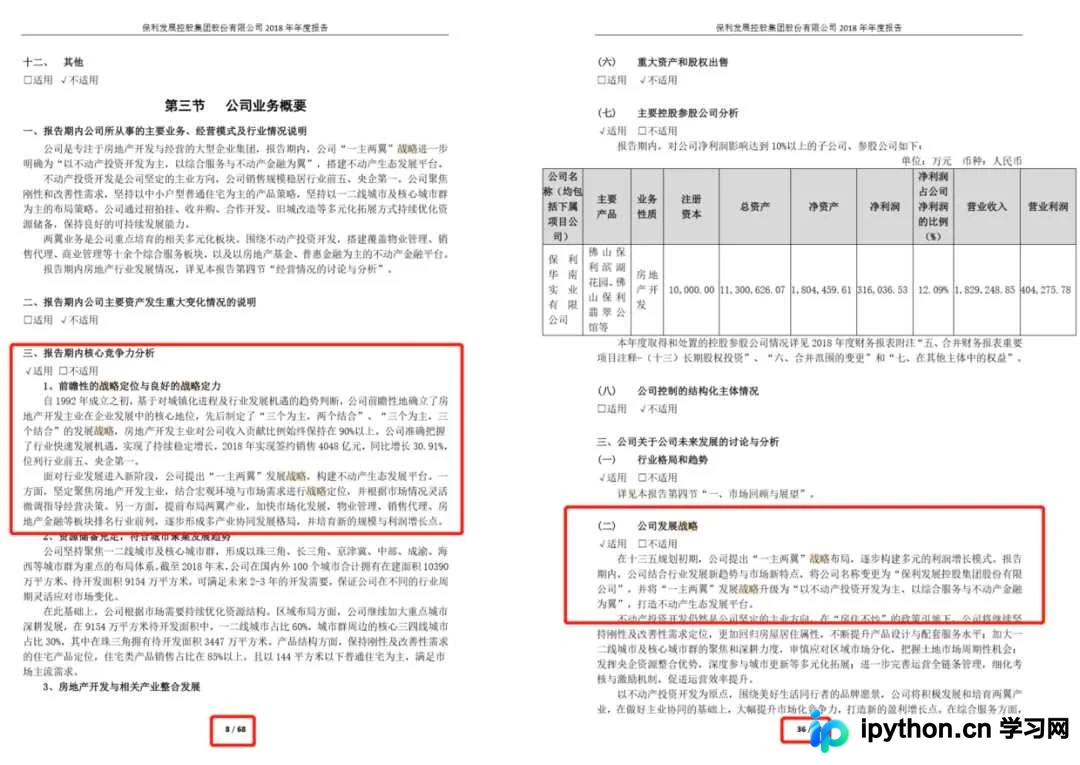
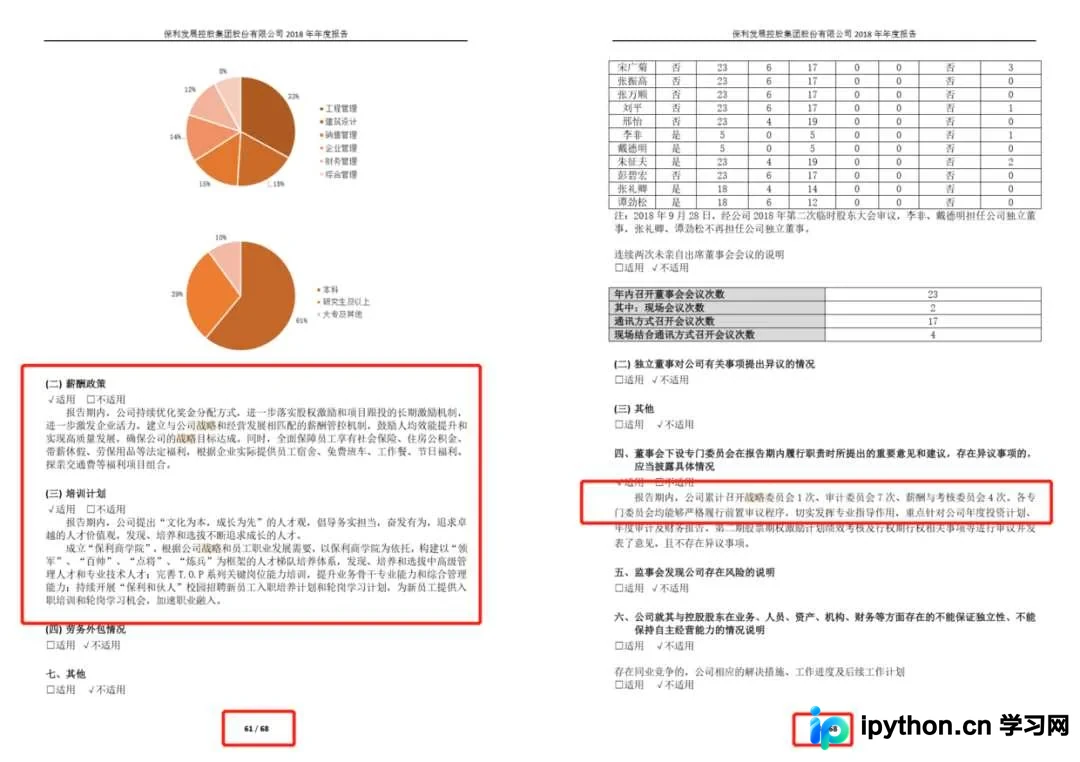
需求一完整代码如下,感兴趣的读者可以自行研究:
from PyPDF2 import PdfFileReader, PdfFileWriter
import pdfplumber

path = r'C:\xxx'
pdf_writer = PdfFileWriter()
pdf_reader = PdfFileReader(path + r'\公司年报.PDF')

with pdfplumber.open(path + r'\公司年报.PDF') as pdf:
    for i in range(pdf_reader.getNumPages()):
        page = pdf.pages[i]
        print(page.extract_text())
        if '战略' in page.extract_text():
            pdf_writer.addPage(pdf_reader.getPage(i))
            print(i + 1, page.extract_text())

with open(path + r'\new_公司年报1.pdf', 'wb') as out:
    pdf_writer.write(out)
3.2 需求二的实现
接下来完成需求二的任务。首先导入需要的库:
from PyPDF2 import PdfFileReader, PdfFileWriter
import fitz
import re
import os
指定文件所在的路径:
path = r'C:\xxxxxx'正则识别图片的部分不再细讲,之前的推文已经介绍过,我们直接看代码:
page_lst = []
checkImg = r"/Subtype(?= */Image)"
pdf = fitz.open(path + r'\公司年报.PDF')
lenXREF = pdf._getXrefLength()

for i in range(lenXREF):
    text = pdf._getXrefString(i)
    isImage = re.search(checkImg, text)
    if isImage:
        page_lst.append(i)

print(page_lst)
获取到所有包含图片的页面后,再结合读取器和写入器的配合就能完成新PDF的产生。需要注意的是,本需求要求所有图片单独输出,因此获取到页面后,直接交给写入器输出成文件:
pdf_reader = PdfFileReader(path + r'\公司年报.PDF')
for page in page_lst:
    pdf_writer = PdfFileWriter()
    pdf_writer.addPage(pdf_reader.getPage(page))
    with open(path + r'\公司年报_{}.pdf'.format(page + 1), 'wb') as out:
        pdf_writer.write(out)
至此也完成了第二个需求。需要说明的是,目前并没有非常完美提取PDF图片的方法,本案例介绍的方法识别图片也并不稳定。读者可以利用自己的数据多做尝试。完整代码如下:
from PyPDF2 import PdfFileReader, PdfFileWriter
import fitz
import re
import os

path = r'C:\xxx'

page_lst = []
checkImg = r"/Subtype(?= */Image)"
pdf = fitz.open(path + r'\公司年报.PDF')
lenXREF = pdf._getXrefLength()
for i in range(lenXREF):
    text = pdf._getXrefString(i)
    isImage = re.search(checkImg, text)
    if isImage:
        page_lst.append(i)

print(page_lst)

pdf_reader = PdfFileReader(path + r'\公司年报.PDF')
for page in page_lst:
    pdf_writer = PdfFileWriter()
    pdf_writer.addPage(pdf_reader.getPage(page))
    with open(path + r'\公司年报_{}.pdf'.format(page + 1), 'wb') as out:
        pdf_writer.write(out)
实现这两个单个需求后,就可以将相关代码封装并结合os等模块实现批量操作,从而解放双手。
到此这篇关于Python提取PDF指定内容并生成新文件的文章就介绍到这了,更多相关Python提取PDF指定内容内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















