


Python实现Kruskal最小生成树:从图论基础到并查集应用

本文深入解析Kruskal最小生成树算法的Python实现。从树的定义与性质出发,阐述如何通过并查集维护节点连通性,利用贪心策略按边权排序构建最小生成树。文章结合代码示例,详细讲解算法原理、适用场景及具体编码步骤,帮助开发者掌握这一经典图论算法。
一、前言
对于初学者而言,直接面对复杂的算法原理和晦涩的概念往往令人望而生畏。这种困惑是正常的,因为突然涌入的大量信息缺乏背景支撑,让人难以理解其来源与用途。这也是许多人对算法学习充满热情却最终放弃的主要原因。
因此,我们暂不深入探讨生成树的定义、构造方法或有向/无向图的区别,而是从最基础的内容入手,完整梳理该算法的逻辑脉络。
二、树是什么
首先,我们回顾最简单的数据结构——树。
树是一个抽象的数据结构,但在自然界中能找到对应实体。初学者常借助自然界的树木来理解这一概念,通常认为树的样子如下:
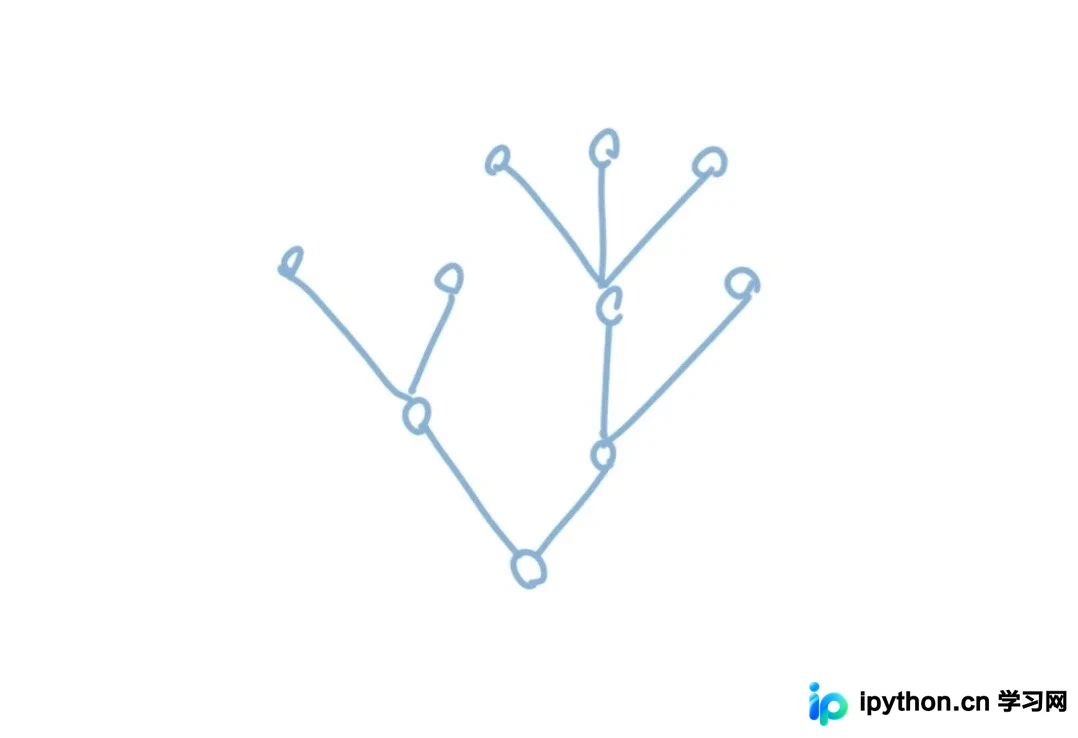
上述图像是自然界中树的直观抽象,易于理解。但在计算机科学中,树结构通常被倒置,即根节点在上,叶子节点在下。这种设计并非出于特殊道理,而是因为遍历树时通常从根节点开始,向叶子节点延伸。倒置后,这种从根到叶子的遍历逻辑更加清晰。我们将上述树倒置后得到如下形态:
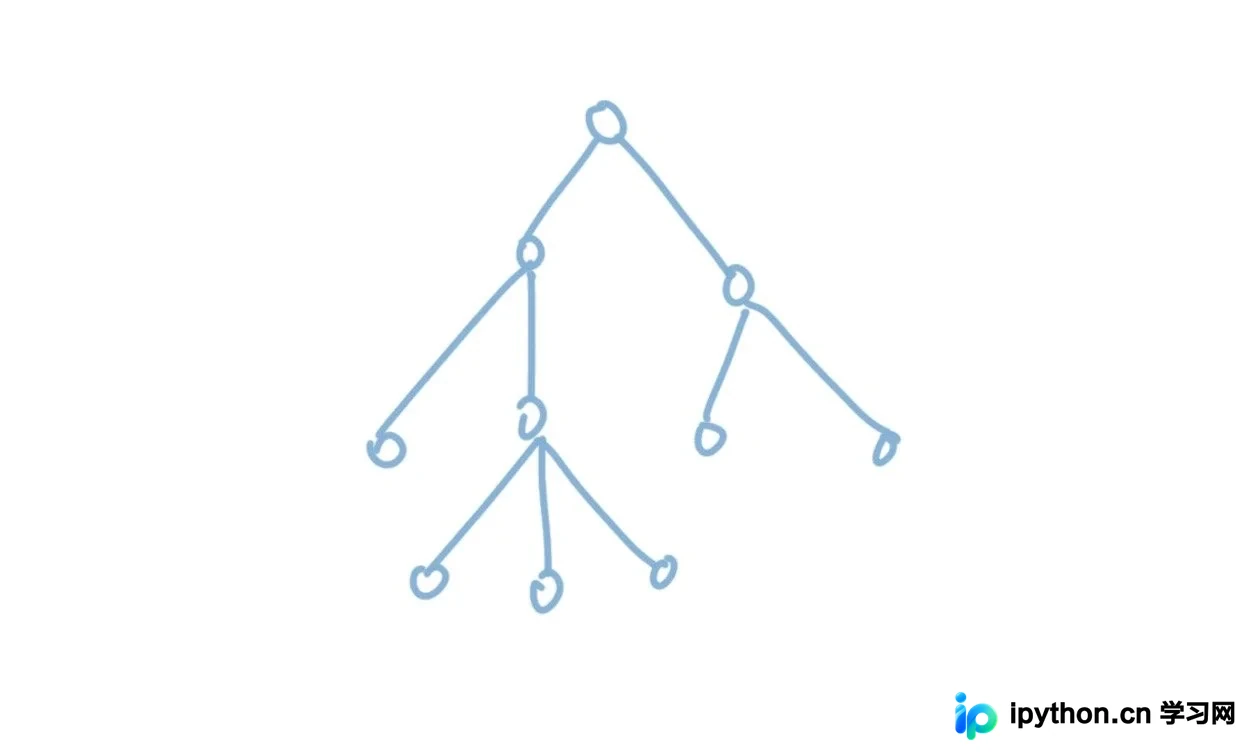
上述两种画法均正确。既然树可以正向或倒置放置,我们也可以将其“展开”放置,例如下面这张图,虽然画法不同,但本质上仍是一棵树:
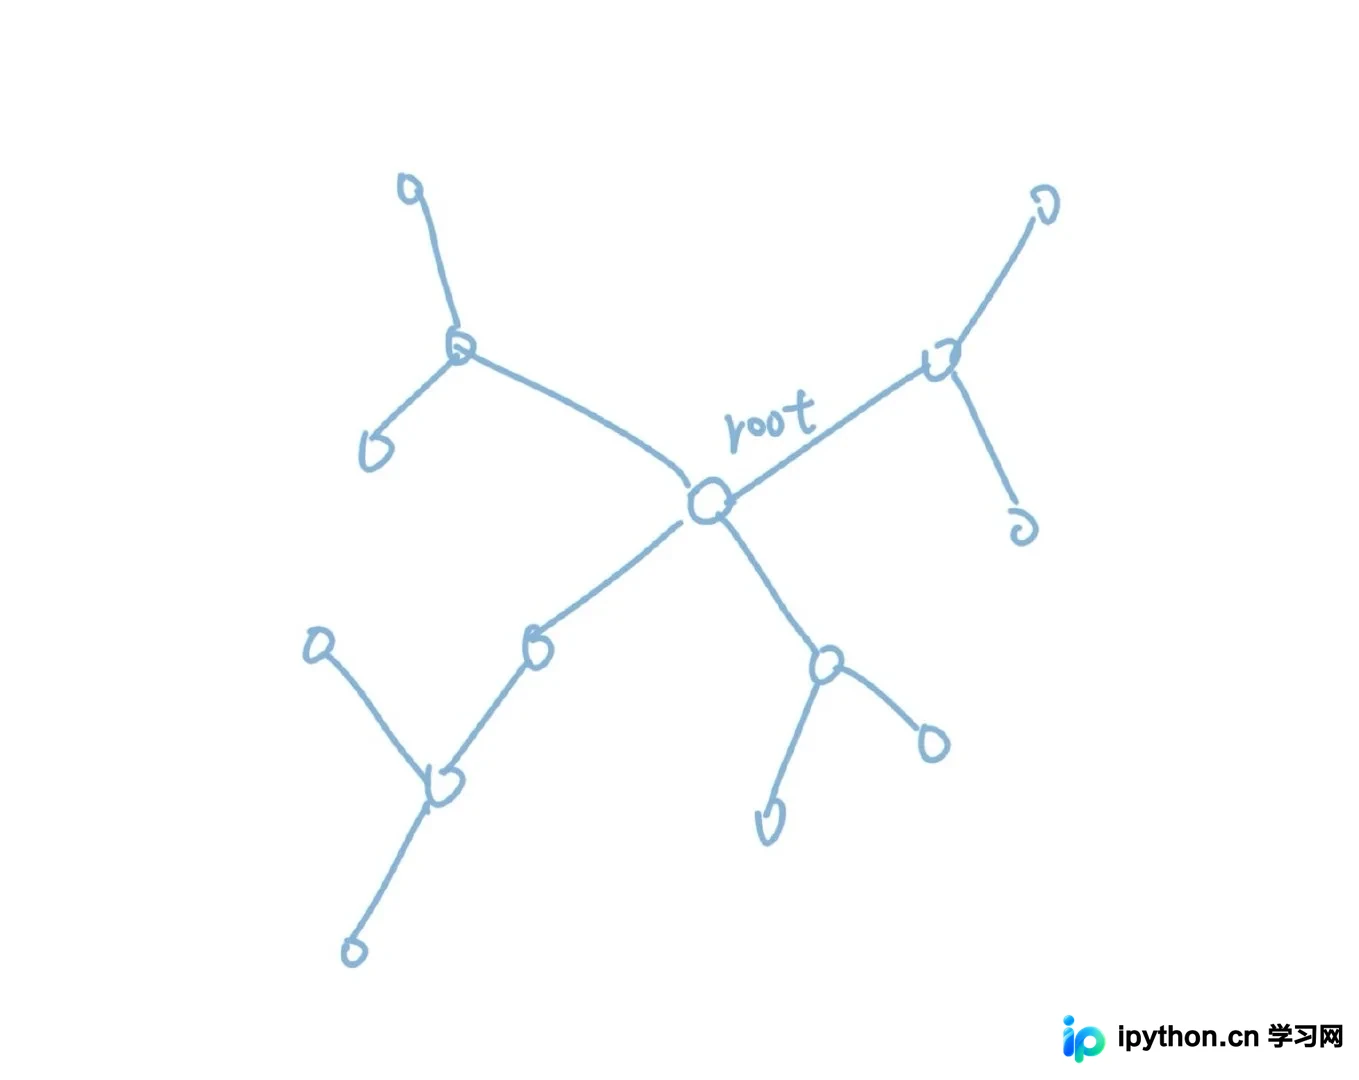
想象有一只无形的大手抓住树根将其“拎起”,树自然呈现为上述展开形态。
你会发现,无论这只手拎起哪个节点,结果都是一棵树。这意味着,如果根节点的位置不再重要,树在逻辑上等价于上述展开后的图形。
那么,这种图形究竟是什么?它具备哪些性质?是否所有图都能视为树?
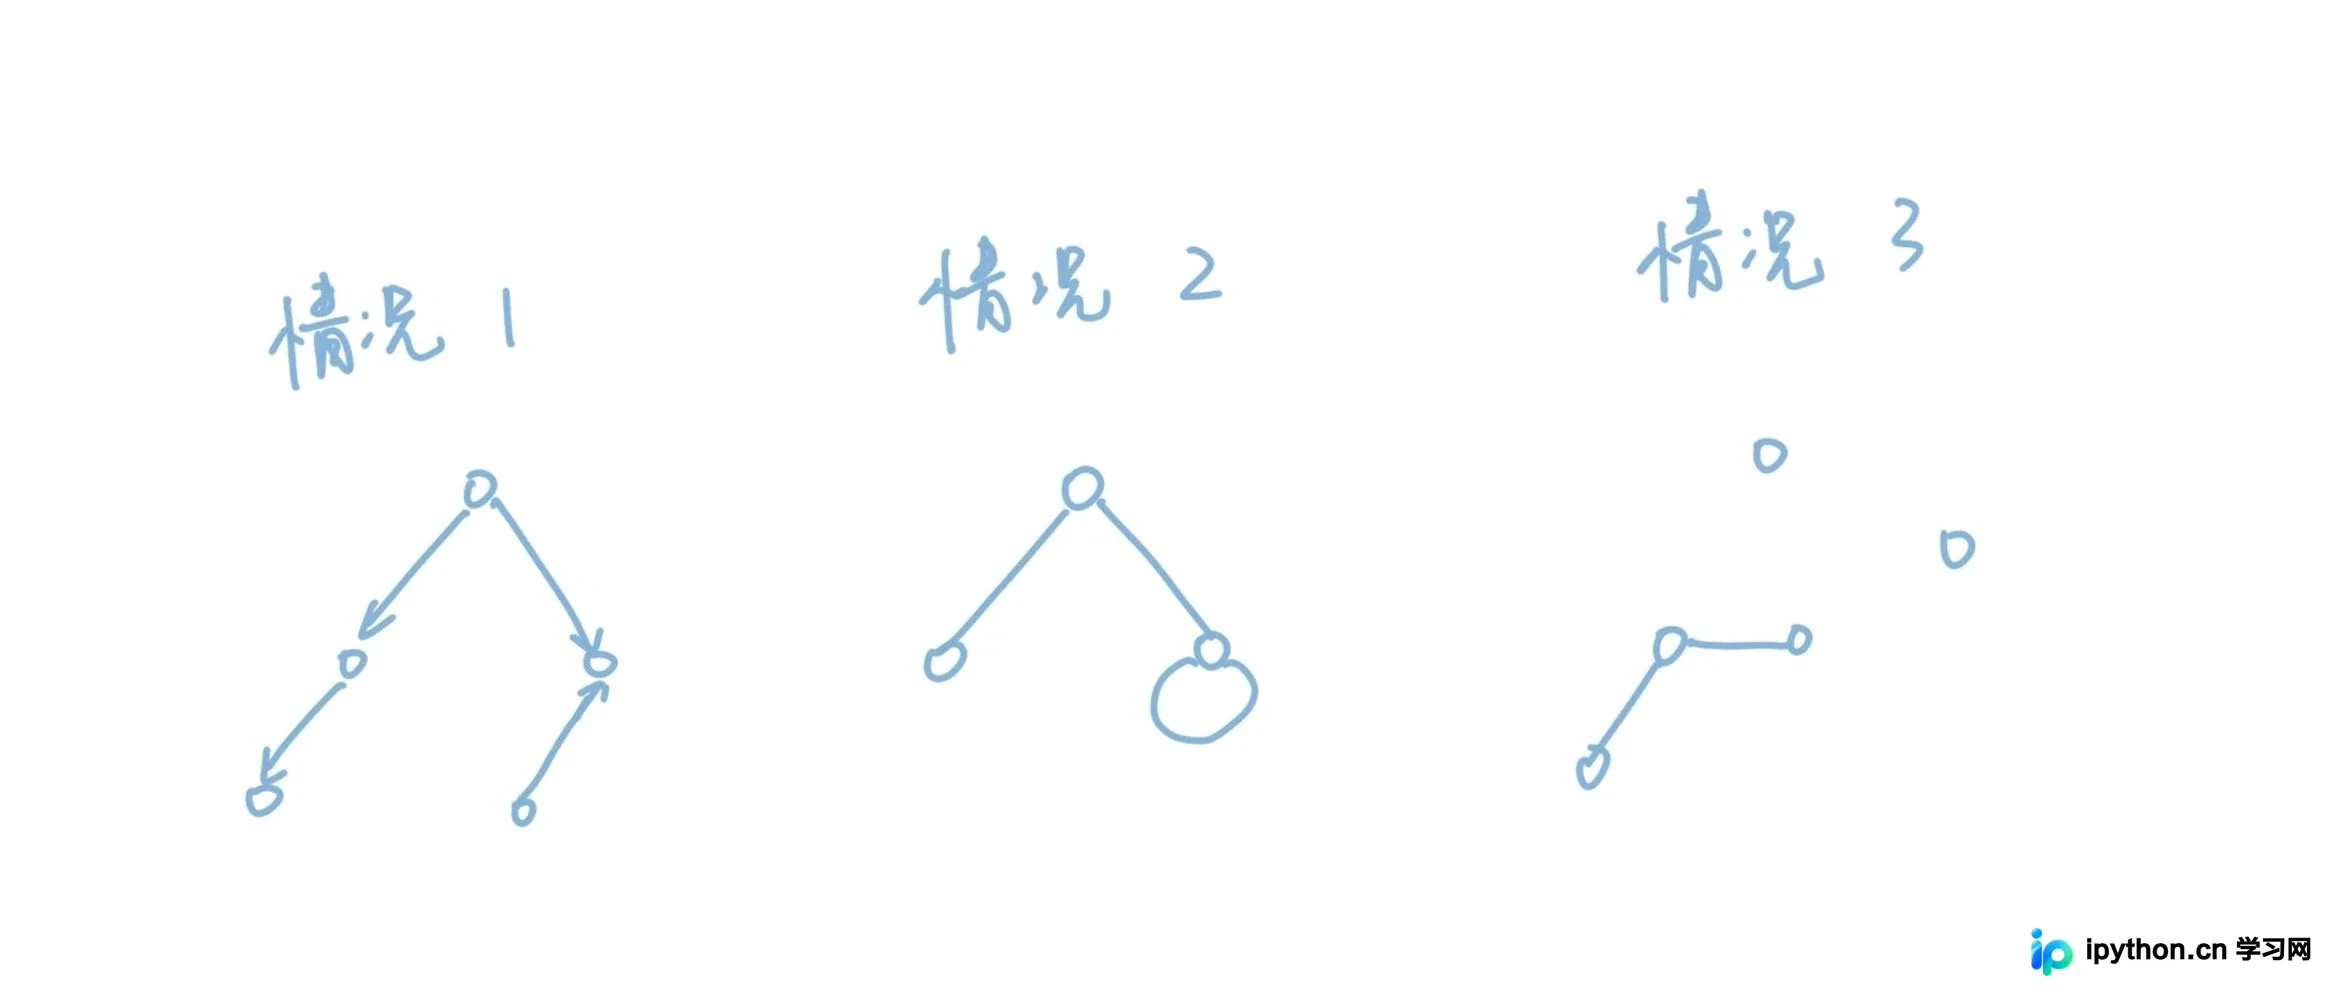
显然,上述三种情况均不符合树的定义。第一种情况中,边具有方向性,破坏了图的连通性。在认知中,树应当是全连通的,如同蚂蚁能在树上任意移动。若无法全连通,则不是树。第二种情况包含环路,而树不应有环。自然界中的树没有环,逻辑中的树同样不能有环,否则递归访问将陷入死循环。第三种情况存在孤立点,无法连通,因此也不是树。
综上所述,树的定义是:一个全连通(无向图)且不含环路的图。
三、从图到树
基于上述分析,我们得出一个重要结论:树的本质是图,只是满足特定性质。这也是许多树算法被归入图论范畴的原因。
从“全连通”和“无环”这两个性质出发,我们可以推导出另一个重要结论:对于包含n个节点的树,其边数固定为n-1。若边数超过n-1,则必然存在环路;若少于n-1,则必然存在不连通部分。需要注意的是,这是一个必要条件而非充分条件,即n个点n-1条边并不一定构成树,容易构造反例。
这一结论虽简单,但在解决由图转化为树的问题时非常有用。
假设我们有一个复杂图,希望生成一棵能连通所有节点的树,应如何处理?若缺乏上述性质,可能会无从下手;但有了该性质,思路便清晰起来。主要有两种方法:第一种是删减边,既然复杂图的边数超过n-1,可以尝试删除部分边,最终保留一棵树;第二种是增加边,即先移除所有边,然后逐一添加n-1条边,使其成为一棵树。
对比这两种方法,删减边的策略显然弱于增加边的方法。原因在于,每次删除边时,都需要评估是否会破坏树的连通性。例如:
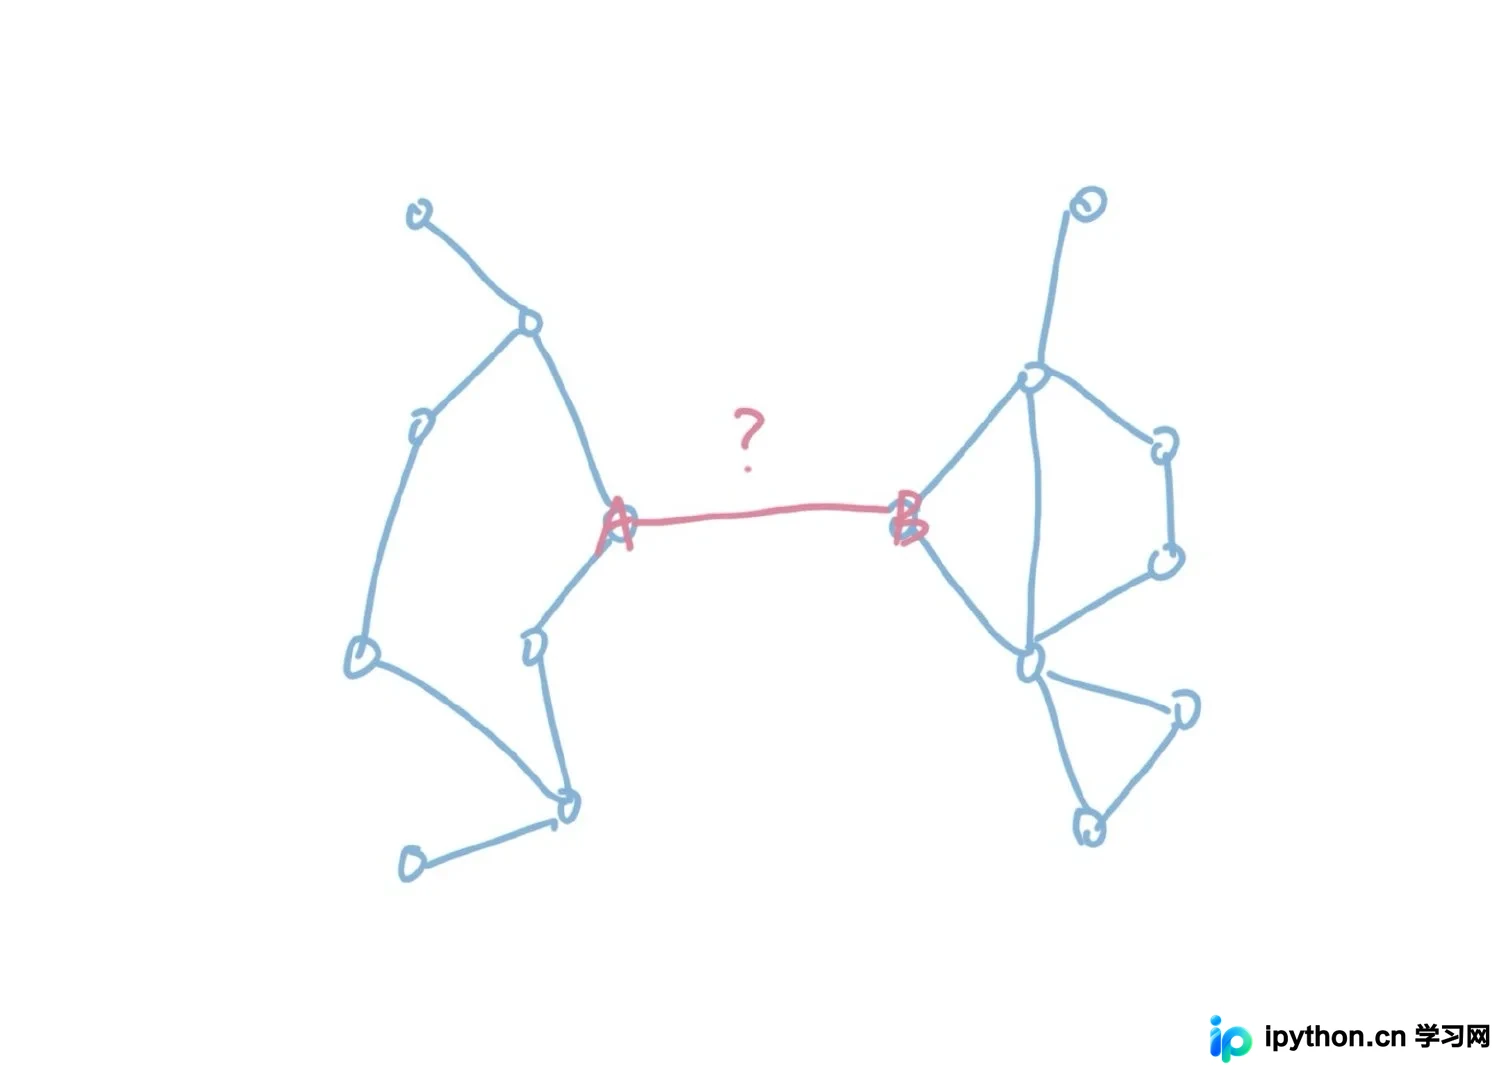
若删除AB这条边,必然破坏整体结构的连通性。判断连通性的最佳方法是先删除该边,然后尝试从A点出发看是否能到达B点。若能到达,则说明该边可删除。然而,对于大型图,每次删除都需遍历整张图,开销巨大。此外,每次删除都会改变图的结构,难以缓存结果。
因此,虽然删除边的方法并非不可行,但复杂度极高。目前流行的两种最小生成树算法均采用第二种方法,即增加边的方式实现。
至此,我们明确:最小生成树算法是从图中挑选n-1条边,将其转化为一棵树的过程。
四、解决生成问题
暂不考虑边带权重的情况,假设所有边等价,先探讨如何生成树,再优化以求最小。
若采用增加边的方法,面临的问题与前述类似:选择一条边时,如何判断其是否必要?这需要利用树的另一性质。
由于树无环,任意两点间的路径有且仅有一条。若存在两条路径,则必然形成环路。该证明简单,但难以凭直觉得出。基于此结论,我们可以回答:何种边有必要添加?即两点间不存在通路时。若两点间已有通路,则当前边不可添加,否则必成环。若无通路,则可添加。
因此,我们需要设计一个算法来维护树上点的连通性。
这引出一个新问题:在树结构中,连通性具有传递性。两点间连一条边,不仅意味着这两点连通,还意味着所有与这两点连通的点均连通。例如:
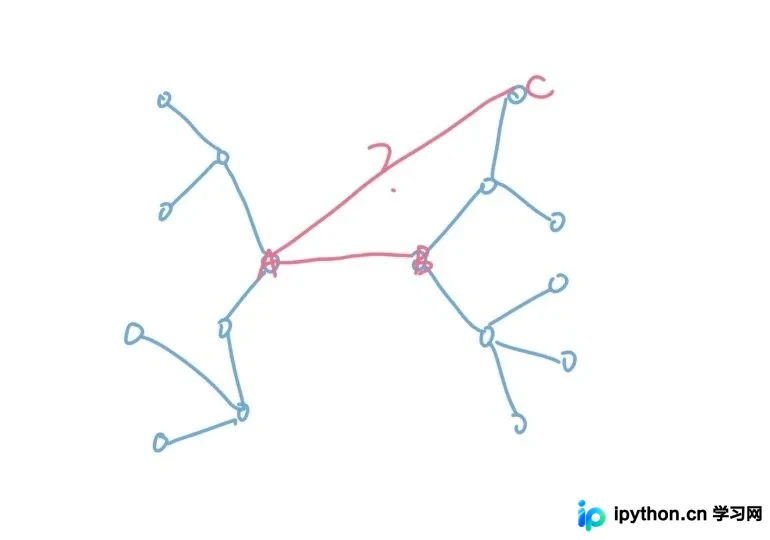
图中A和B连了一条边,这不仅表示A和B连通,还意味着左半部分集合与右半部分集合连通。因此,虽然A仅与B直接连通,但也与C连通。AC这条边同样不可加入。换言之,A和B连通,实质是A所在集合与B所在集合的合并过程。看到集合合并,是否感到熟悉?是的,上一篇文章介绍的并查集算法正是用于解决集合合并与查询问题。因此,显然可以用并查集来维护图中点集的连通性。
利用并查集算法,问题变得简单。初始时所有点互不连通,每个点单独构成一个集合。若当前边连接的两个点属于同一集合,说明它们之间已有通路,该边不可添加。否则,说明它们不连通,可添加该边,并合并这两个集合。
于是,我们解决了生成树的问题。
五、从生成树到最小生成树
接下来,我们为图中的每条边赋予权重,希望最终生成的树的所有权重之和最小。
例如,我们有如下图,希望生成的树上所有边的权重和最小:
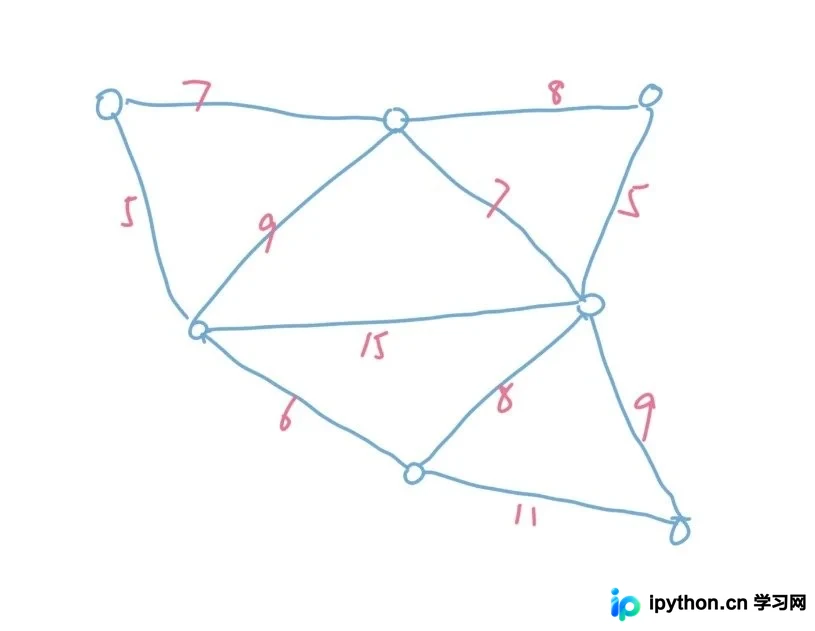
观察图中的边,长短不一。根据贪心算法,我们显然希望使用尽量短的边来连通树。因此,Kruskal算法的原理简单直接:对这些边按长度排序,依次从短到长遍历这些边,并通过并查集维护边是否可以添加,直到所有边遍历结束。
可以肯定,这样生成的树一定是正确的。尽管我们对边进行了排序,但每条边仍有可能被使用,排序不影响算法的可行性。但问题是,这样贪心得到的结果一定是最优的吗?
这里,我们沿用之前提到的等价判断方法。假设存在两条长度相同的边,我们的决策是否会影响最终结果?
两条完全相等的边可能出现三种情况,为简化图示,我们将一个集合视为一个点。第一种情况是这两条边连接四个不同的集合:
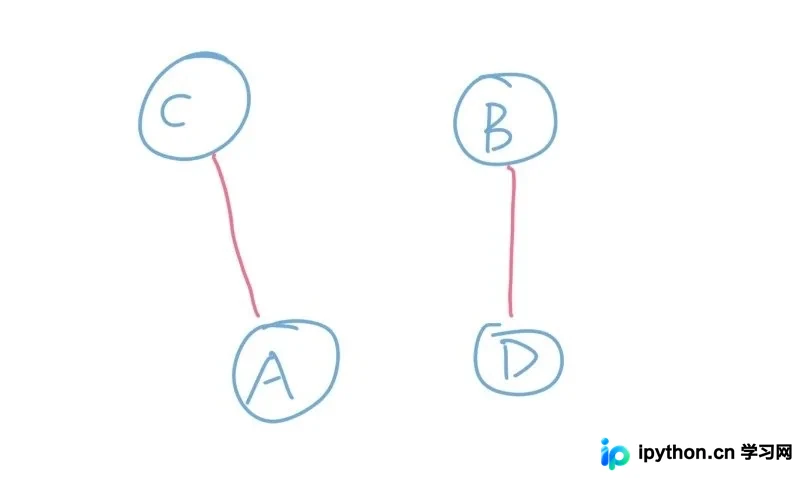
显然,这两条边之间不会引起冲突,因此可以都保留。这不会导致反例。
第二种情况是这两条边连接三个不同的集合:
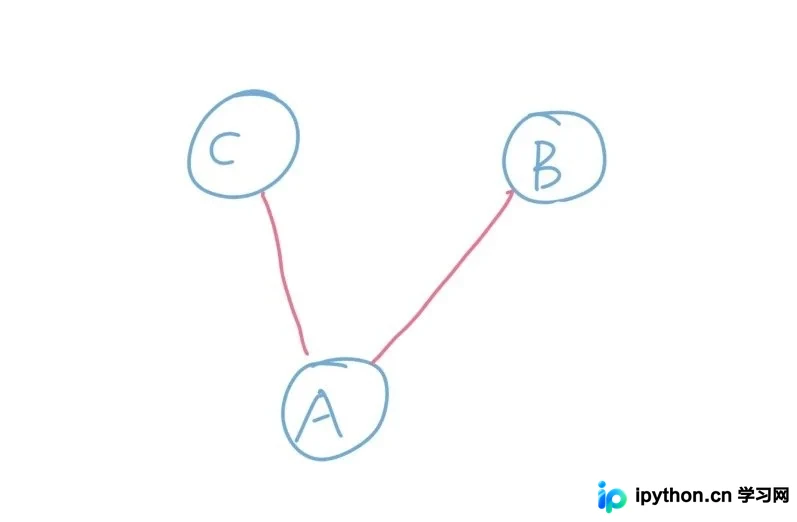
这种情况与上述相同,我们可以同时保留,不会影响连通性。因此也不会导致反例。
最后一种情况是这两条边连接两个集合,即如下所示:
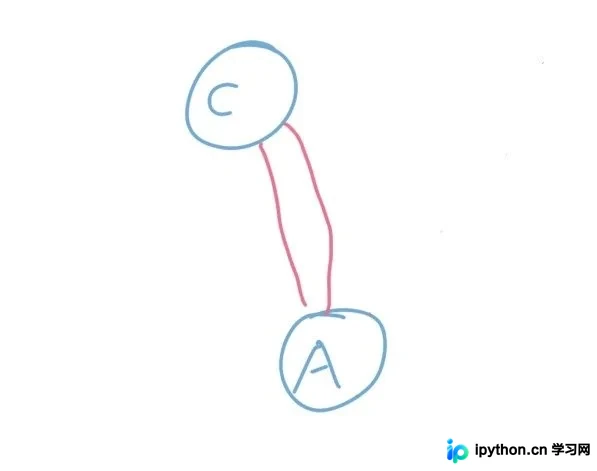
在这种情况下,这两条边互相冲突,我们只能选择其中一条。但显然,无论选择哪条,结果都是一样的,因为它们都连接了这两个连通块,带来的价值相同,不影响最终结果。
列举所有情况后,我们可以明确:在此问题中,贪心法是可行的,不会导致反例,因此可以放心使用。
六、实际问题与代码实现
理解算法原理后,我们来看看该算法的实际应用。该算法在现实中应用广泛,例如自来水公司需用水管连通所有小区,而水管有成本,因此公司希望水管总长度尽量短。又如山区村庄通电,需用尽量少的电缆将所有村庄连通。这类问题均可抽象为最小生成树问题。当然,现实问题可能更复杂,除成本和连通性外,还需考虑地形、人文、社会等因素。
最后,我们尝试用代码实现该算法。
class DisjointSet:

    def __init__(self, element_num=None):
        self._father = {}
        self._rank = {}
        # 初始化时每个元素单独成为一个集合
        if element_num is not None:
            for i in range(element_num):
                self.add(i)

    def add(self, x):
        # 添加新集合
        # 如果已经存在则跳过
        if x in self._father:
            return
        self._father[x] = x
        self._rank[x] = 0

    def _query(self, x):
        # 如果father[x] == x,说明x是树根
        if self._father[x] == x:
            return x
        self._father[x] = self._query(self._father[x])
        return self._father[x]

    def merge(self, x, y):
        if x not in self._father:
            self.add(x)
        if y not in self._father:
            self.add(y)
        # 查找到两个元素的树根
        x = self._query(x)
        y = self._query(y)
        # 如果相等,说明属于同一个集合
        if x == y:
            return
        # 否则将树深小的合并到树根大的上
        if self._rank[x] < self._rank[y]:
            self._father[x] = y
        else:
            self._father[y] = x
            # 如果树深相等,合并之后树深+1
            if self._rank[x] == self._rank[y]:
                self._rank[x] += 1

    # 判断是否属于同一个集合
    def same(self, x, y):
        return self._query(x) == self._query(y)

# 构造数据
edges = [[1, 2, 7], [2, 3, 8], [2, 4, 9], [1, 4, 5], [3, 5, 5], [2, 5, 7], [4, 5, 15], [4, 6, 6], [5, 6, 8], [6, 7, 11], [5, 7, 9]]

if __name__ == "__main__":
    disjoinset = DisjointSet(8)
    # 根据边长对边集排序
    edges = sorted(edges, key=lambda x: x[2])
    res = 0
    for u, v, w in edges:
        if disjoinset.same(u ,v):
            continue
        disjoinset.merge(u, v)
        res += w
    print(res)
主要利用并查集,我们额外编写的代码仅有几行,是否非常简单?
七、结尾
相信大家也感受到了Kruskal算法原理的简洁性。若顺着文章脉络阅读,定会有一种顺水推舟、一切自然的感觉。正因如此,它非常符合直觉,易于理解,一旦记住便不易遗忘。即使忘记,也很容易自行推导出来。这并非玩笑,有一次我在比赛中临时遇到此算法,虽许久未写,但凭仅存印象,在草稿纸上成功推导了一遍。
以上就是浅谈算法之最小生成树Kruskal的Python实现的详细内容,更多关于Python 最小生成树Kruskal 的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















