


Python实现DFA算法详解:从原理到代码

本文深入解析Python中DFA(确定有限状态自动机)算法的实现原理与应用。通过构建嵌套字典结构,文章展示了如何高效处理关键词匹配,包括处理包含关系和添加通配符支持。相比传统循环遍历,DFA在大数据量匹配场景下具有显著性能优势,适合敏感词过滤等实际应用。
一、概述
在计算机操作系统中,进程的状态及其切换机制可以作为理解DFA(确定有限状态自动机)算法的一种直观类比。如参考图示,图中椭圆代表不同的状态,连接椭圆的线条代表触发状态转换的事件。无论是进程的状态还是引发状态变化的事件,它们都是确定的,并且所有可能的情况都可以被穷举出来。
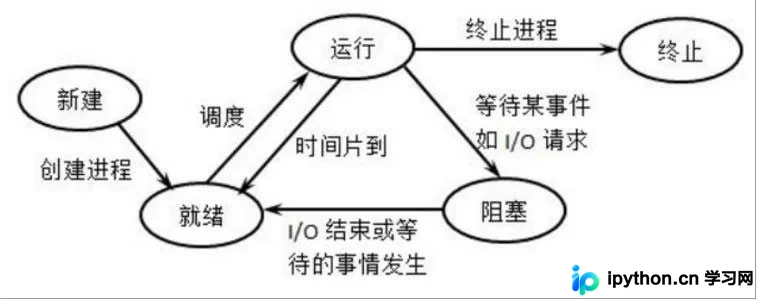
DFA算法在实际开发中有多种应用场景,本文首先聚焦于其在关键词匹配领域的应用。
二、匹配关键词
我们可以将文本中的每个字符或片段视为一个状态节点。以“匹配关键词”为例,该短语可以拆解为“匹”、“匹配”、“匹配关”、“匹配关键”和“匹配关键词”这五个逐步递进的文本片段,每个片段对应DFA中的一个状态。
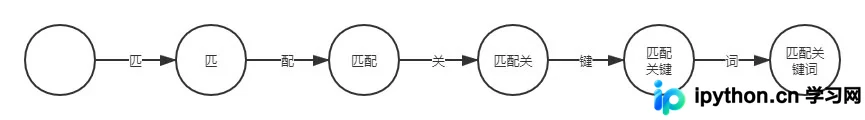
具体匹配过程如下:
- 初始状态下,系统处于空状态。当输入字符“匹”作为事件触发时,系统转换至状态“匹”;
- 随后若触发事件“配”,系统进一步转换至状态“匹配”;
- 依此类推,持续进行状态转换,直至到达最后一个状态“匹配关键词”,此时匹配完成。
进一步考虑包含多个关键词的情况,例如同时存在“匹配算法”、“匹配关键词”以及“信息抽取”。
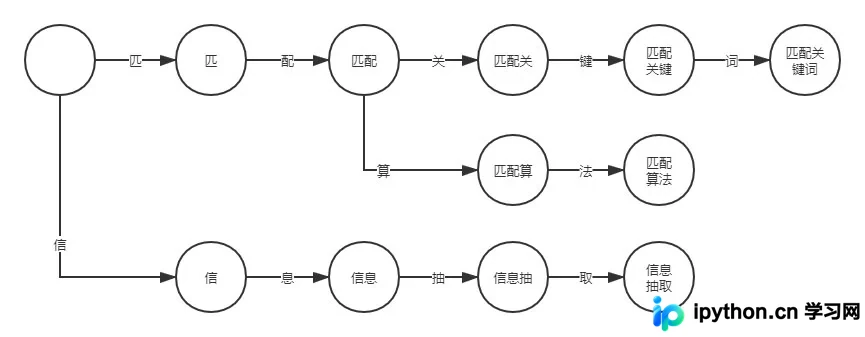
观察状态转换图可以发现,其结构类似于树形结构。正是由于这种树形结构的存在,DFA算法在关键词匹配效率上通常优于简单的关键词迭代方法(如for循环)。熟悉LeetCode的读者应当了解,树形结构遍历的时间复杂度通常低于线性遍历的时间复杂度。
以下是传统for循环匹配方式的示例:
keyword_list = []

for keyword in ["匹配算法", "匹配关键词", "信息抽取"]:
    if keyword in "DFA 算法匹配关键词":
        keyword_list.append(keyword)
使用for循环需要遍历整个关键词列表。随着关键词库的不断扩充,遍历所需的时间成本也会随之增加,导致性能下降。
相比之下,DFA算法在遇到“匹”字时,只会沿着特定的路径走向后续序列(如“匹配关键词”),而不会错误地走向“匹配算法”的路径。因此,DFA的遍历次数远少于for循环。具体的代码实现将在后文详述。
【问】:那么,如何构建上述状态转换图的结构呢?
【答】:在Python中,我们可以利用dict(字典)数据结构来实现这一结构。
state_event_dict = {
    "匹": {
        "配": {
            "算": {
                "法": {
                    "is_end": True
                },
                "is_end": False
            },
            "关": {
                "键": {
                    "词": {
                        "is_end": True
                    },
                    "is_end": False
                },
                "is_end": False
            },
            "is_end": False
        },
        "is_end": False
    },
    "信": {
        "息": {
            "抽": {
                "取": {
                    "is_end": True
                },
                "is_end": False
            },
            "is_end": False
        },
        "is_end": False
    }
}具体而言,使用嵌套字典来模拟树形结构,其中字典的key代表事件(即字符)。通过检查is_end字段,可以判断当前状态是否为结束状态。如果是最后一个状态,则停止状态转换,并提取匹配的关键词。
【问】:如果关键词之间存在包含关系,例如“匹配关键词”和“匹配”,该如何处理?
【答】:我们依然可以使用is_end字段来标记关键词的结尾。同时,为了支持继续匹配,可以添加一个新的字段,例如is_continue,以表明当前状态后仍可继续匹配。此外,也可以通过检查除is_end字段外是否还存在其他子节点来判断是否继续匹配。例如在下面的代码中,对于“配”这个状态,除了is_end字段外还包含“关”节点,因此匹配过程需要继续进行。
state_event_dict = {
    "匹": {
        "配": {
            "关": {
                "键": {
                    "词": {
                        "is_end": True
                    },
                    "is_end": False
                },
                "is_end": False
            },
            "is_end": True
        },
        "is_end": False
    }
}
接下来,我们将具体实现这一算法。
三、算法实现
本文使用Python 3.6版本进行实现,当然其他Python 3.X版本也能正常运行。
3.1、构建存储结构
def _generate_state_event_dict(keyword_list: list) -> dict:
    state_event_dict = {}

    # 遍历每一个关键词
    for keyword in keyword_list:
        current_dict = state_event_dict
        length = len(keyword)

        for index, char in enumerate(keyword):
            if char not in current_dict:
                next_dict = {"is_end": False}
                current_dict[char] = next_dict
                current_dict = next_dict
            else:
                next_dict = current_dict[char]
                current_dict = next_dict

            if index == length - 1:
                current_dict["is_end"] = True

    return state_event_dict
上述代码仍有不少可迭代优化的空间。例如,可以先对关键词列表按字典序进行排序,这样具有相同前缀的关键词会集中在一起,从而在构建存储结构时减少遍历次数。
3.2、匹配关键词
def match(state_event_dict: dict, content: str):
    match_list = []
    state_list = []
    temp_match_list = []

    for char_pos, char in enumerate(content):
        # 首先找到匹配项的起点
        if char in state_event_dict:
            state_list.append(state_event_dict)
            temp_match_list.append({
                "start": char_pos,
                "match": ""
            })

        # 可能会同时满足多个匹配项,因此遍历这些匹配项
        for index, state in enumerate(state_list):
            if char in state:
                state_list[index] = state[char]
                temp_match_list[index]["match"] += char

                # 如果抵达匹配项的结尾,表明匹配关键词完成
                if state[char]["is_end"]:
                    match_list.append(copy.deepcopy(temp_match_list[index]))

                    # 如果还能继续,则继续进行匹配
                    if len(state[char].keys()) == 1:
                        state_list.pop(index)
                        temp_match_list.pop(index)
            # 如果不满足匹配项的要求,则将其移除
            else:
                state_list.pop(index)
                temp_match_list.pop(index)

    return match_list
3.3、完整代码
import re
import copy


class DFA:

    def __init__(self, keyword_list: list):
        self.state_event_dict = self._generate_state_event_dict(keyword_list)

    def match(self, content: str):
        match_list = []
        state_list = []
        temp_match_list = []

        for char_pos, char in enumerate(content):
            if char in self.state_event_dict:
                state_list.append(self.state_event_dict)
                temp_match_list.append({
                    "start": char_pos,
                    "match": ""
                })

            for index, state in enumerate(state_list):
                if char in state:
                    state_list[index] = state[char]
                    temp_match_list[index]["match"] += char

                    if state[char]["is_end"]:
                        match_list.append(copy.deepcopy(temp_match_list[index]))

                        if len(state[char].keys()) == 1:
                            state_list.pop(index)
                            temp_match_list.pop(index)
                else:
                    state_list.pop(index)
                    temp_match_list.pop(index)

        return match_list

    @staticmethod
    def _generate_state_event_dict(keyword_list: list) -> dict:
        state_event_dict = {}

        for keyword in keyword_list:
            current_dict = state_event_dict
            length = len(keyword)

            for index, char in enumerate(keyword):
                if char not in current_dict:
                    next_dict = {"is_end": False}
                    current_dict[char] = next_dict
                    current_dict = next_dict
                else:
                    next_dict = current_dict[char]
                    current_dict = next_dict

                if index == length - 1:
                    current_dict["is_end"] = True

        return state_event_dict


if __name__ == "__main__":
    dfa = DFA(["匹配关键词", "匹配算法", "信息抽取", "匹配"])
    print(dfa.match("信息抽取之 DFA 算法匹配关键词,匹配算法"))
运行输出结果如下:
[
{
'start': 0,
'match': '信息抽取'
}, {
'start': 12,
'match': '匹配'
}, {
'start': 12,
'match': '匹配关键词'
}, {
'start': 18,
'match': '匹配'
}, {
'start': 18,
'match': '匹配算法'
}
]
四、其他用法
4.1、添加通配符
在敏感词识别场景中,常遇到同一类型的句式,例如“你这个傻X”,其中X可以是多种字符。如果逐一添加到关键词表中显然不现实。更好的做法是引入类似正则表达式的通配符机制。一个简单的实现是使用“*”来匹配任意内容。
添加通配符只需修改匹配关键词的过程:
def match(self, content: str):
    match_list = []
    state_list = []
    temp_match_list = []

    for char_pos, char in enumerate(content):
        if char in self.state_event_dict:
            state_list.append(self.state_event_dict)
            temp_match_list.append({
                "start": char_pos,
                "match": ""
            })

        for index, state in enumerate(state_list):
            is_find = False
            state_char = None

            # 如果是 * 则匹配所有内容
            if "*" in state:
                state_list[index] = state["*"]
                state_char = state["*"]
                is_find = True

            if char in state:
                state_list[index] = state[char]
                state_char = state[char]
                is_find = True

            if is_find:
                temp_match_list[index]["match"] += char

                if state_char["is_end"]:
                    match_list.append(copy.deepcopy(temp_match_list[index]))

                    if len(state_char.keys()) == 1:
                        state_list.pop(index)
                        temp_match_list.pop(index)
            else:
                state_list.pop(index)
                temp_match_list.pop(index)

    return match_list
main()函数调用示例。
if __name__ == "__main__":
    dfa = DFA(["匹配关键词", "匹配算法", "信息*取", "匹配"])
    print(dfa.match("信息抽取之 DFA 算法匹配关键词,匹配算法,信息抓取"))
运行输出结果如下:
[
{
'start': 0,
'match': '信息抽取'
}, {
'start': 12,
'match': '匹配'
}, {
'start': 12,
'match': '匹配关键词'
}, {
'start': 18,
'match': '匹配'
}, {
'start': 18,
'match': '匹配算法'
}, {
'start': 23,
'match': '信息抓取'
}
]
以上是对Python实现DFA算法的详细解析,更多关于Python DFA算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















