


Python实现8种常用抽样方法:从概率到非概率的完整指南

本文详细介绍Python中实现的8种常用抽样方法,涵盖概率抽样(随机、分层、聚类、系统、多级)与非概率抽样(简单、自愿、雪球)。通过具体代码示例与参数设置,解析如何在机器学习与统计推断中应用不同策略,确保样本代表性与模型质量。
本文将探讨几种常用的抽样技术,并展示如何在Python中实现这些方法。
抽样在统计学和机器学习中扮演着核心角色,因为处理全量数据往往不切实际或不可行。因此,通过抽样获取代表性子集成为必要手段。例如,在推断性统计中,我们常利用样本数据来估计总体特征。
前述讨论主要基于概率理论,但实际上还存在另一类非概率抽样方法。总体而言,抽样技术可归纳为以下两大类:
概率抽样:依据概率理论选取样本,确保每个个体被选中的概率已知且非零。
非概率抽样:依据非随机标准选取样本,并非每个个体都有被选中的机会。
概率抽样技术
1. 随机抽样 (Random Sampling)
这是最基础且直接的抽样方式,完全依赖随机性,不考虑任何附加因素。在此方法下,总体中的每一个样本被选中的概率均等。
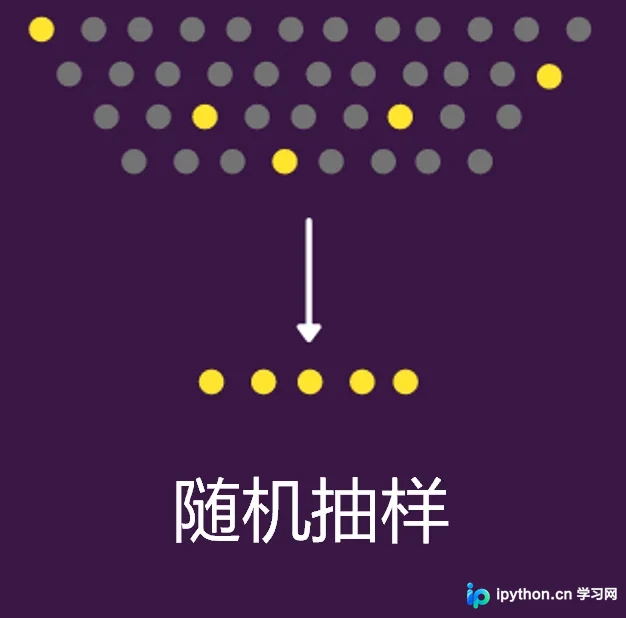
例如,若拥有10000条带有唯一序号的样本,需抽取1000条,则直接从1至10000的整数中随机选取1000个数字,对应序号的样本即被选中。
在Python中,我们可以调用random模块中的函数来生成随机数。以下示例展示了如何从100个个体中随机抽取5个。
import random
population = 100
data = range(population)
print(random.sample(data,5))
> 4, 19, 82, 45, 41
2. 分层抽样 (Stratified Sampling)
分层抽样本质上仍属于随机抽取,但引入了分组前提。该方法根据某些共同属性将待抽样总体划分为若干层,随后从每一层中独立进行随机抽样。
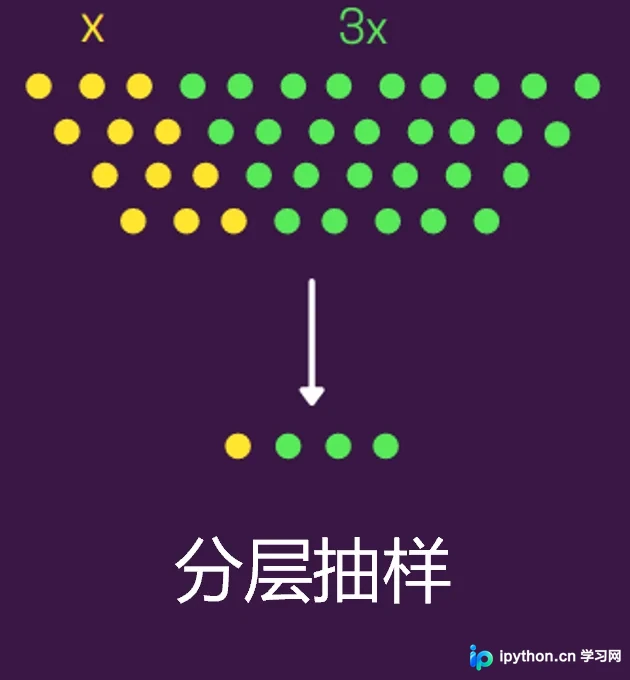
因此,分层抽样可视为更精细化的随机抽样,旨在保持与总体相同的比例结构。例如,在机器学习分类任务中,若类别0与类别1的比例为3:7,为维持这一比例,可采用分层抽样,对每个类别单独进行随机抽样。
在Python中,通过train_test_split函数设置stratify参数即可完成分层操作。
from sklearn.model_selection import train_test_split

stratified_sample, _ = train_test_split(population, test_size=0.9, stratify=population[['label']])
print (stratified_sample)
3. 聚类抽样 (Cluster Sampling)
聚类抽样,亦称整群抽样。其核心思想是将总体划分为多个子群体(簇),每个子群体具备与总体相似的特征。该方法并非对个体进行抽样,而是随机选择整个子群体作为样本。
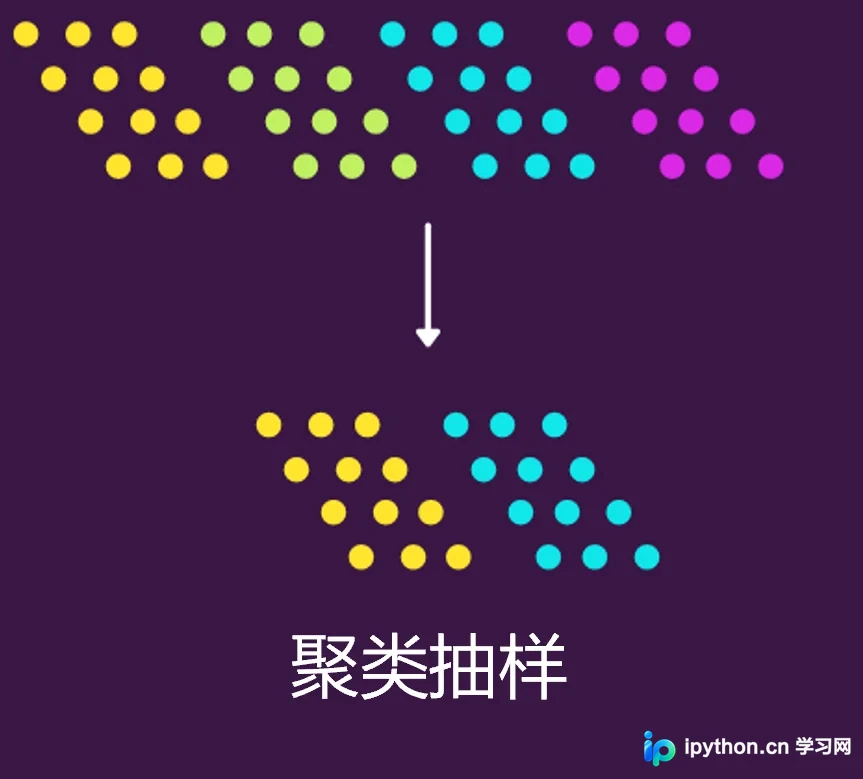
使用Python可以先为聚类群体分配聚类ID,随后随机抽取两个子群体,并提取对应的样本值,具体实现如下。
import numpy as np
clusters=5
pop_size = 100
sample_clusters=2
# 间隔为 20, 从 1 到 5 依次分配集群100个样本的聚类 ID,这一步已经假设聚类完成
cluster_ids = np.repeat([range(1,clusters+1)], pop_size/clusters)
# 随机选出两个聚类的 ID
cluster_to_select = random.sample(set(cluster_ids), sample_clusters)
# 提取聚类 ID 对应的样本
indexes = [i for i, x in enumerate(cluster_ids) if x in cluster_to_select]
# 提取样本序号对应的样本值
cluster_associated_elements = [el for idx, el in enumerate(range(1, 101)) if idx in indexes]
print (cluster_associated_elements)
4. 系统抽样 (Systematic Sampling)
系统抽样依据预定的规则间隔(通常是固定且周期性的间隔)从总体中抽取样本。例如,每隔9个元素抽取一个。一般而言,这种方法比普通随机抽样更为高效。
下图展示了按顺序每隔9个元素进行一次采样的过程,并重复执行。
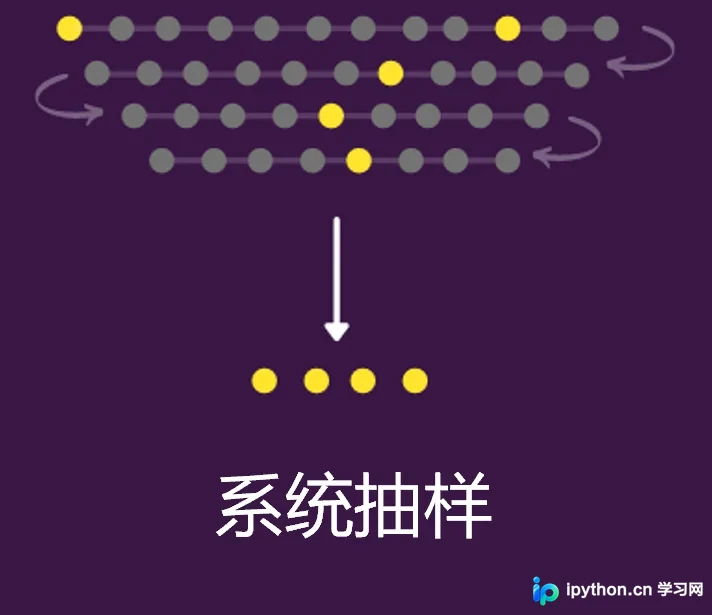
使用Python实现时,只需在循环结构中设置step参数即可。
population = 100
step = 5
sample = [element for element in range(1, population, step)]
print (sample)
5. 多级采样 (Multistage sampling)
在多阶段采样中,我们将多种抽样方法依次连接使用。例如,第一阶段可采用聚类抽样从总体中选择集群,第二阶段再对每个选定的集群进行随机抽样,从而形成最终样本集。
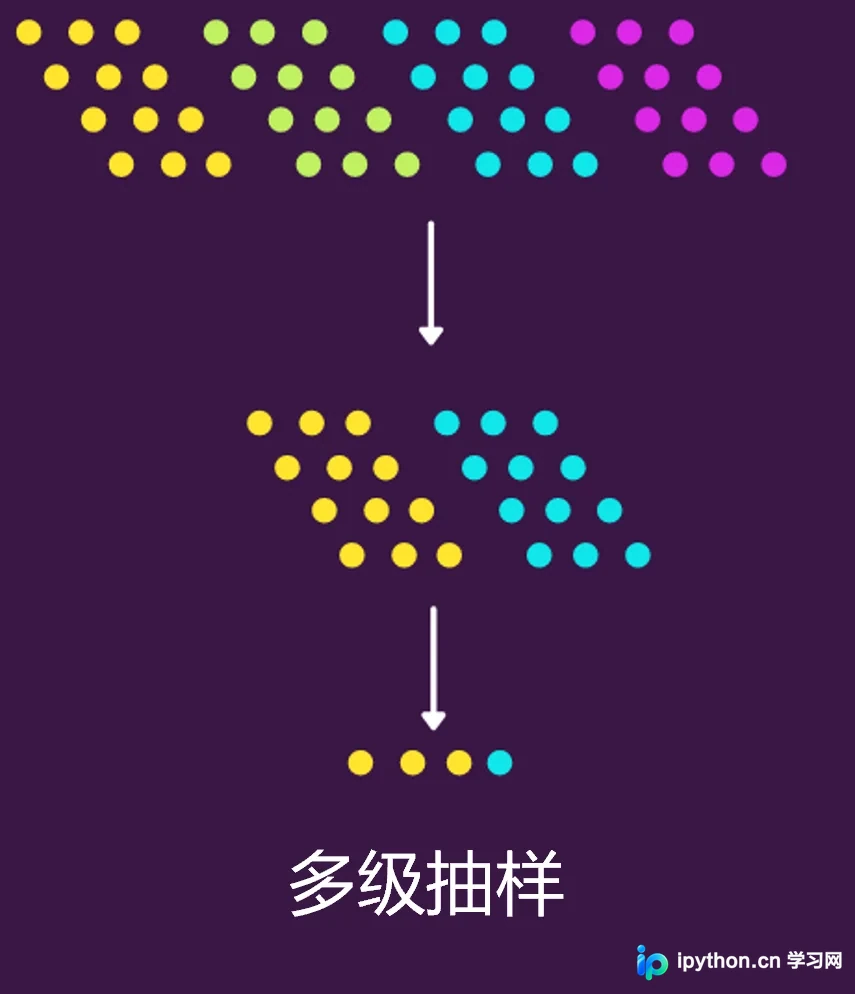
Python代码复用了前述聚类抽样的逻辑,仅在最后一步增加随机抽样操作。
import numpy as np
clusters=5
pop_size = 100
sample_clusters=2
sample_size=5
# 间隔为 20, 从 1 到 5 依次分配集群100个样本的聚类 ID,这一步已经假设聚类完成
cluster_ids = np.repeat([range(1,clusters+1)], pop_size/clusters)
# 随机选出两个聚类的 ID
cluster_to_select = random.sample(set(cluster_ids), sample_clusters)
# 提取聚类 ID 对应的样本
indexes = [i for i, x in enumerate(cluster_ids) if x in cluster_to_select]
# 提取样本序号对应的样本值
cluster_associated_elements = [el for idx, el in enumerate(range(1, 101)) if idx in indexes]
# 再从聚类样本里随机抽取样本
print (random.sample(cluster_associated_elements, sample_size))
非概率抽样技术
非概率抽样显然不涉及概率计算,通常基于特定条件进行选择。由于缺乏随机性,这类方法无法通过统计概率或编程自动化实现。此处介绍三种常见方法。
1. 简单采样 (convenience sampling)
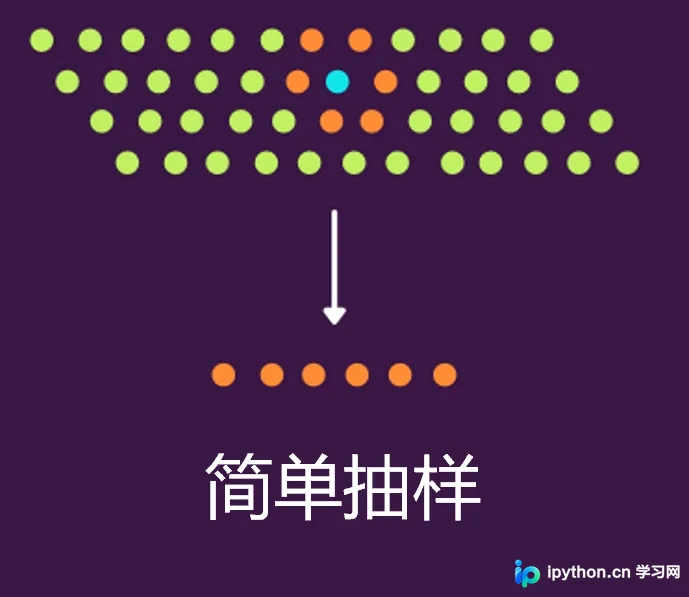
简单采样指研究人员仅选择最容易接触且最有机会参与研究的个体。如下图中,蓝点代表研究人员,橙色点代表靠近研究人员且易于接触的人群。
2. 自愿抽样 (Voluntary Sampling)
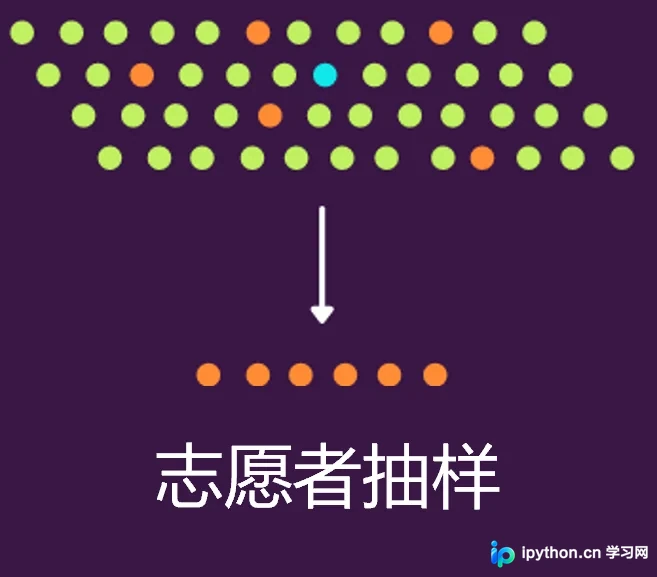
在自愿抽样中,感兴趣的人通常通过填写调查表格等方式自行参与。此时,研究人员无权选择特定个体,完全取决于群体的自愿报名。如下图中,蓝点代表研究人员,橙色点代表自愿同意参与研究的个体。
3. 雪球抽样 (Snowball Sampling)
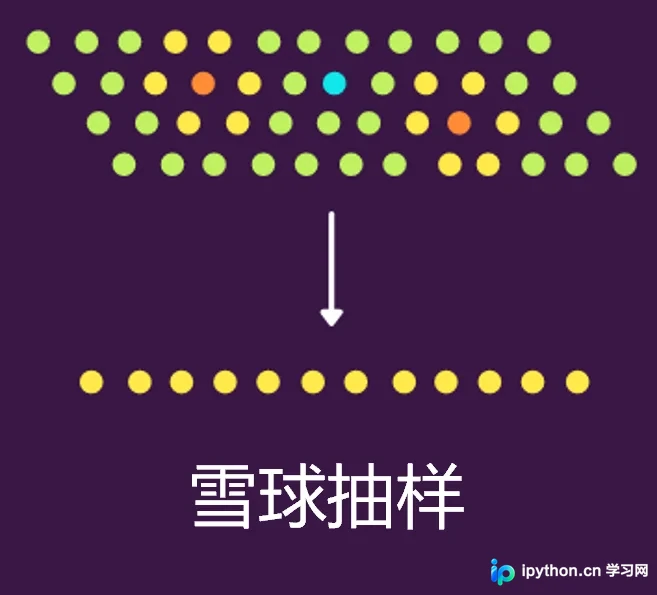
雪球抽样是指最终样本集合通过现有参与者的推荐获得。即研究人员要求已知联系人寻找其他愿意参与研究的人。如下图中,蓝点代表研究人员,橙色点代表已知联系人,黄色点代表橙色联系人周围的其他潜在联系人。
总结
以上介绍了8种常用抽样方法。在实际工作中,概率类抽样更为常见,因为缺乏随机性的方法难以通过统计学和编程实现自动化操作。
例如,在信贷风控样本设计中,需从样本窗口通过概率进行抽样。由于采样质量直接决定模型上限,因此在抽样时需综合考虑样本数量、显著性、样本穿越等诸多因素。此时,选择合适的抽样方法至关重要。
至此,关于Python实现8种常用抽样方法的文章介绍完毕。如需了解更多Python抽样相关内容,请搜索本站历史文章或浏览后续相关文章,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















