


Python使用PyPDF2合并PDF文件及解决多定义报错

本文介绍如何使用Python的PyPDF2库合并多个PDF文件。通过示例代码展示如何遍历目录并合并PDF,重点解决因复杂格式导致的PdfReadError多定义报错。通过修改strict参数为False,实现复杂PDF文件的顺利合并,提供完整可复用代码。
Python合并PDF基础教程
需要合并PDF文件?这篇文章将为您提供完整的解决方案。大家好,这里是滑稽研究所。本文将直接使用Python代码将多个PDF文件合并为一个,并预先准备了5个PDF文件用于验证代码效果。
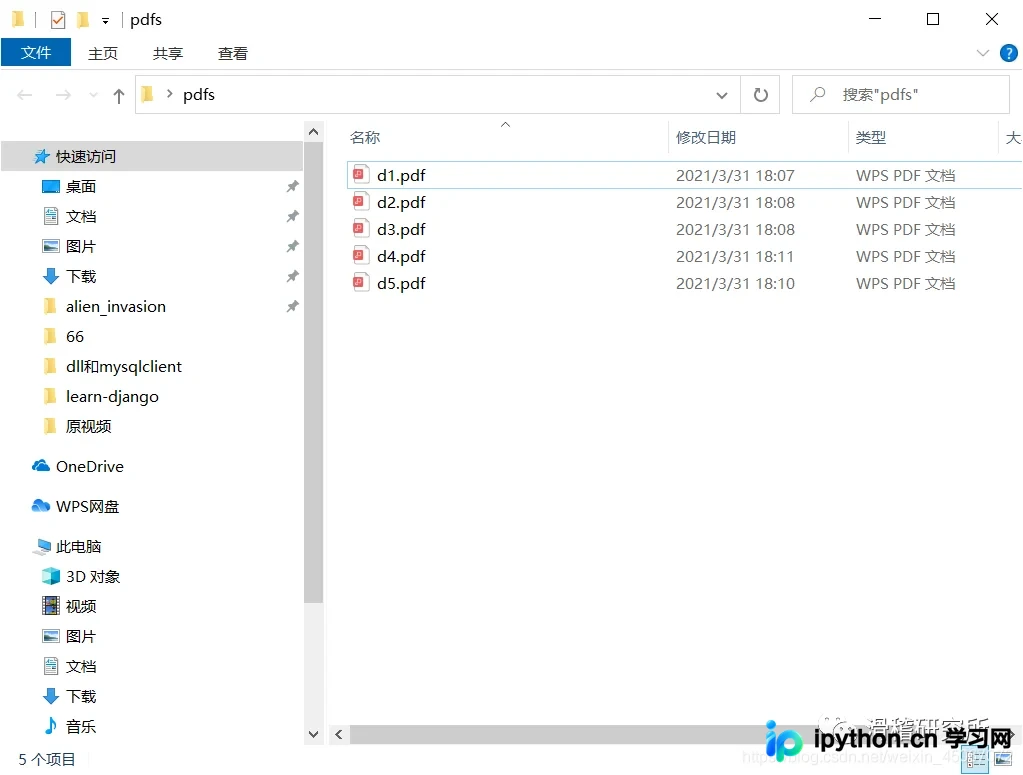 源代码:
import os
from PyPDF2 import PdfFileReader, PdfFileWriter

# 使用os模块的walk函数,搜索出指定目录下的全部PDF文件
# 获取同一目录下的所有PDF文件的绝对路径
def getFileName(filedir):

    file_list = [os.path.join(root, filespath) \
                 for root, dirs, files in os.walk(filedir) \
                 for filespath in files \
                 if str(filespath).endswith('pdf')
                 ]
    return file_list if file_list else []

# 合并同一目录下的所有PDF文件
def MergePDF(filepath, outfile):

    output = PdfFileWriter()
    outputPages = 0
    pdf_fileName = getFileName(filepath)

    if pdf_fileName:
        for pdf_file in pdf_fileName:
            print("路径:%s"%pdf_file)

            # 读取源PDF文件
            input = PdfFileReader(open(pdf_file, "rb"))

            # 获得源PDF文件中页面总数
            pageCount = input.getNumPages()
            outputPages += pageCount
            print("页数:%d"%pageCount)

            # 分别将page添加到输出output中
            for iPage in range(pageCount):
                output.addPage(input.getPage(iPage))

        print("合并后的总页数:%d."%outputPages)
        # 写入到目标PDF文件
        outputStream = open(os.path.join(filepath, outfile), "wb")
        output.write(outputStream)
        outputStream.close()
        print("PDF文件合并完成!")

    else:
        print("没有可以合并的PDF文件!")

# 主函数
def main():
    file_dir = input('请输入存有Pdf的文件夹').replace('/','//')# 存放PDF的原文件夹
    outfile = "pick_me.pdf" # 输出的PDF文件的名称
    MergePDF(file_dir, outfile)
    print('done')

main()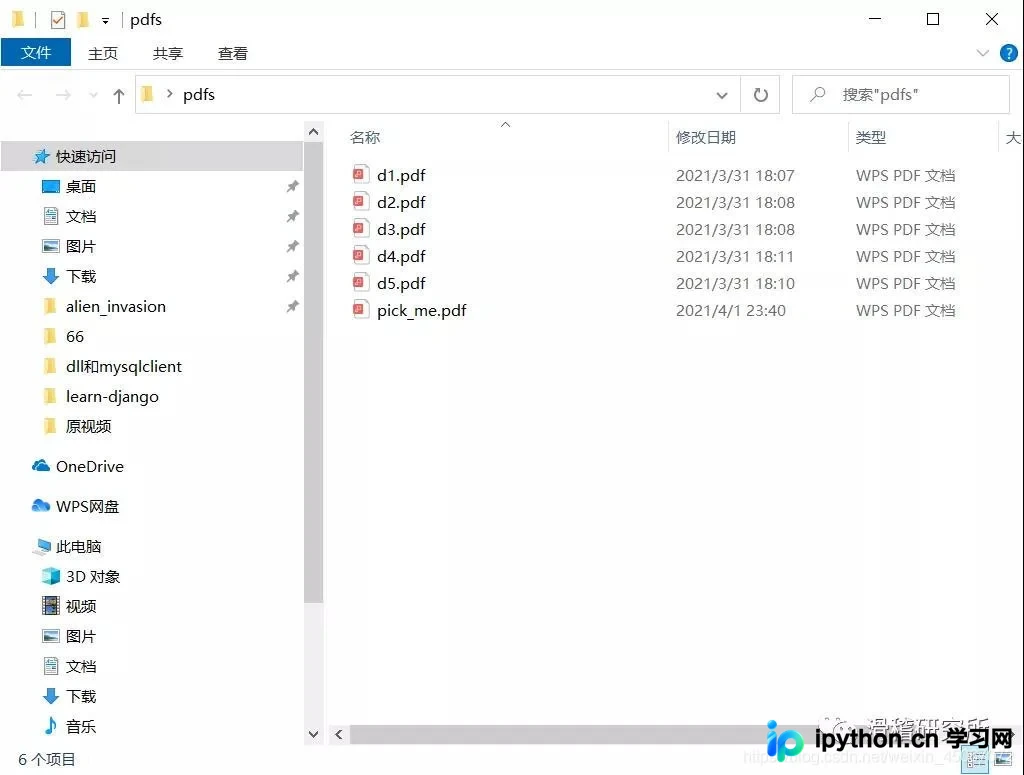
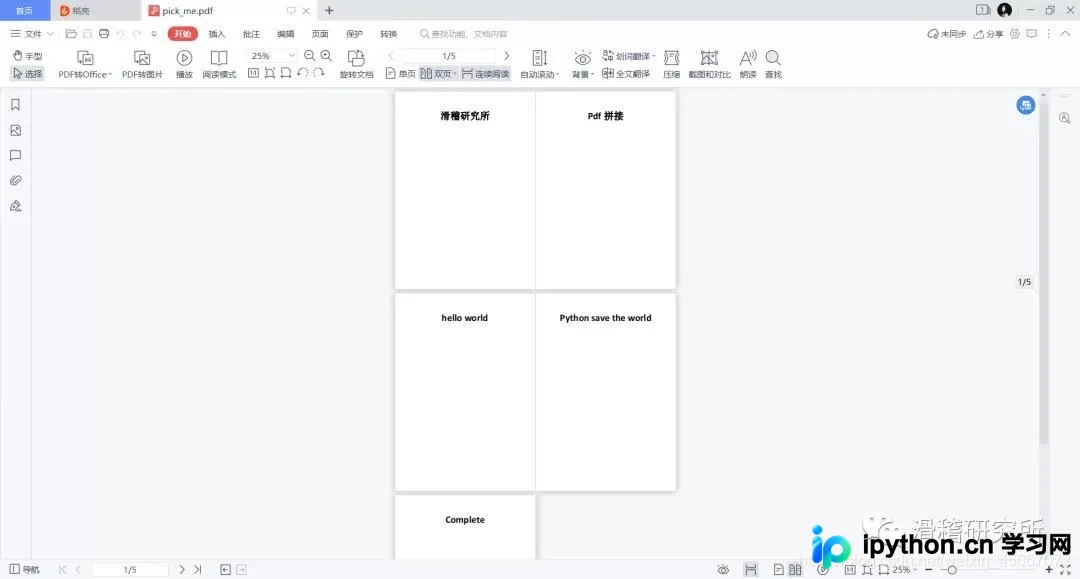
解决PyPDF2多定义报错
运行结果显示5个PDF文件已成功合并。但这是否意味着万事大吉?并非如此。当处理的PDF文件包含较多复杂格式(如多图、Word转换内容等)时,程序可能会抛出以下错误。
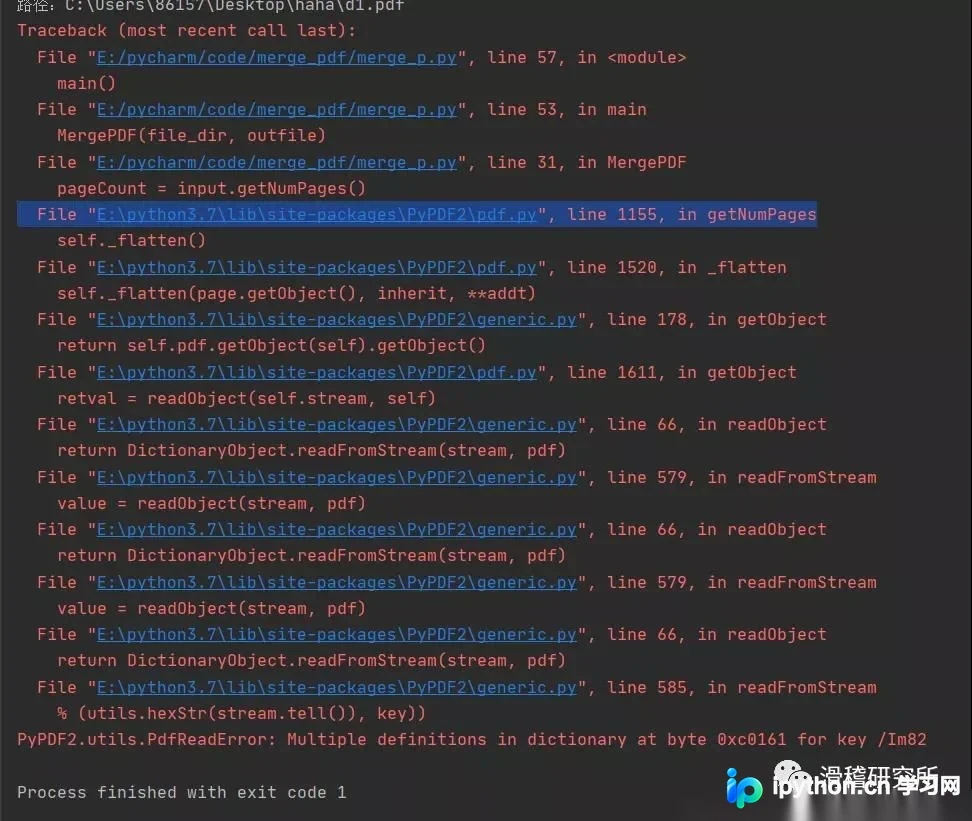
该报错的具体含义如下:
PyPDF2.utils.PdfReadError:对于键/Im82,在字典字节0xc0161处存在多个定义。
通俗来说,这意味着程序遇到了一个“多义词”,无法确定应该提取哪一个定义。此时需要进入pdf.py文件,定位到下图所示的位置进行修改。
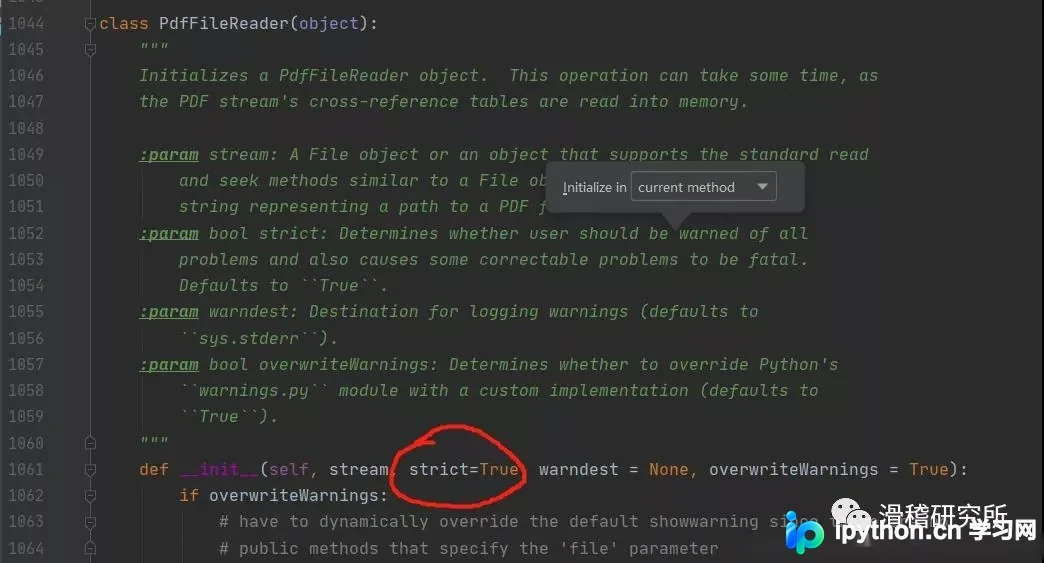
默认情况下,严格模式(strict)是开启的,我们需要将其修改为False。
构造方法说明: PyPDF2.PdfFileReader(stream,strict = True,warndest = None,overwriteWarnings = True) stream:File 对象或支持与 File 对象类似的标准读取和查找方法的对象,也可以是表示 PDF 文件路径的字符串。 strict(bool):确定是否应该警告用户所用的问题,也导致一些可纠正的问题是致命的,默认是 True warndest : 记录警告的目标(默认是 sys.stderr) overwriteWarnings(bool):确定是否 warnings.py 用自定义实现覆盖 Python 模块(默认为 True)
修改参数后,我们重新运行程序。
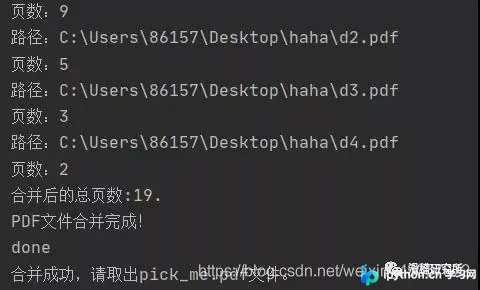
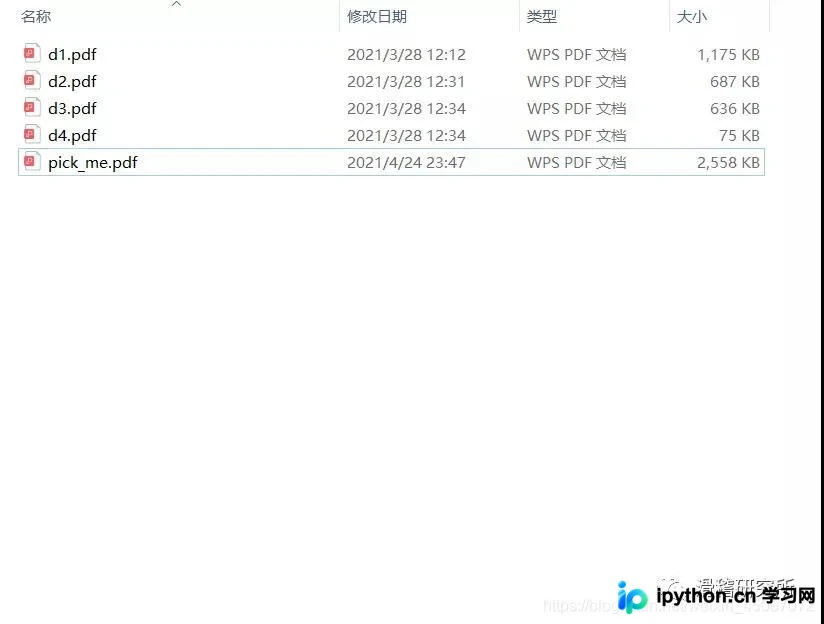
打开输出文件夹,可以看到文件已经合并完成,且打开后的格式没有错误。 至此,问题得到解决。
如果您只需要一个PDF合并工具,可以直接使用上述代码。如果您希望深入学习pypdf2这个实用库,并希望对这段代码进行改进以适配您的特定需求,请继续阅读。
到此这篇关于Python合并pdf文件的文章就介绍到这了,更多相关Python合并pdf文件内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















