


Python利用MD5校验实现文件去重的脚本示例

发布时间:2026-10-14 |
4人浏览过
本文介绍一个Python脚本,通过计算文件的MD5值来识别并去除重复文件。脚本遍历指定目录,将唯一文件复制到桌面的“去重结果”文件夹,重复文件则被标记并忽略。代码可直接运行,旨在提高文件管理效率,适用于处理大量名称不同但内容重复的文件场景。
前言
在日常工作中,我们时常需要处理大量文件去重的问题。面对一堆名称各异但内容重复的文件,手动分析不仅耗时且容易出错,严重影响工作效率。为此,编写了一个Python脚本来自动化这一去重过程。
工作原理
该脚本会遍历用户指定的文件路径下的所有文件,计算每个文件的MD5哈希值,并将这些哈希值存储在一个列表中。
- 当脚本计算出一个文件的MD5值,若该值尚未存在于列表中,则判定该文件为有效文件。脚本会在用户桌面上创建一个名为“去重结果”的文件夹,并将此文件复制至该文件夹中。
- 若计算出的MD5值已存在于列表中,则判定该文件为重复文件。此时,脚本不对该文件进行复制处理,仅记录其存在。
- 该代码可以直接运行,无需进行额外修改(前提是环境中已安装所需的库文件)。
代码
import os
import shutil
import hashlib


# 对文件去重
# 计算每个文件的md5值,据此进行去重
def only_one(test_path):
    md5_list = []
    count = 0
    for current_folder, list_folders, files in os.walk(test_path):
        for file in files:
            file_path = current_folder + '\\' + file  # 获取每个文件的路径
            f = open(file_path, 'rb')  # 开始计算每个文件的md5值
            md5obj = hashlib.md5()
            md5obj.update(f.read())
            get_hash = md5obj.hexdigest()
            f.close()
            md5_value = str(get_hash).upper()
            # 开始去重
            if md5_value in md5_list:  # 如果这个文件的md5值曾经出现过,就不对它做任何处理
                count += 1
                print('\033[31m[-] 发现重复文件:\033[0m' + str(file))
            else:
                md5_list.append(md5_value)  # 如果这个文件的md5值不存在列表中,就添加进列表中
                shutil.copy(file_path, path1)
    print('\033[31m[-] 共发现重复文件:{}个\033[0m'.format(count))


if __name__ == '__main__':
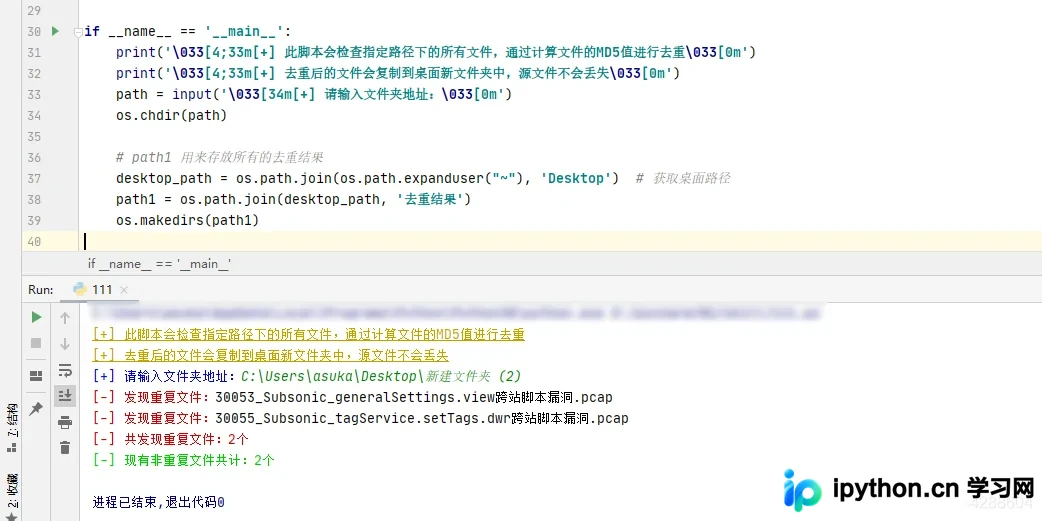
    print('\033[4;33m[+] 此脚本会检查指定路径下的所有文件,通过计算文件的MD5值进行去重\033[0m')
    print('\033[4;33m[+] 去重后的文件会复制到桌面新文件夹中,源文件不会丢失\033[0m')
    path = input('\033[34m[+] 请输入文件夹地址:\033[0m')
    os.chdir(path)

    # path1 用来存放所有的去重结果
    desktop_path = os.path.join(os.path.expanduser("~"), 'Desktop')  # 获取桌面路径
    path1 = os.path.join(desktop_path, '去重结果')
    os.makedirs(path1)

    only_one(path)
    print('\033[32m[-] 现有非重复文件共计:{}个\033[0m'.format(len(os.listdir(path1))))
以上就是本文关于使用Python实现基于MD5的文件去重功能的示例代码。如需了解更多关于Python、MD5及文件去重的相关内容,欢迎查阅本站往期文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















