


Python实现Word文档异或加密与解密教程

本文详细介绍如何使用Python对Word文档进行加密和解密。核心思路是将文档内容转换为二进制,生成随机密钥并进行异或(XOR)运算。文章提供了完整的加密和解密代码示例,包括使用secrets库生成密钥、docx库处理文档以及int.from_bytes进行数据转换。同时说明了加密文件的生成、密钥保存及解密时的注意事项,如仅支持docx格式且密钥文件名不可更改。
Python加密word文档
首先简要介绍异或(XOR)运算的基本概念。当两个操作数的值不同时,异或结果为1;当两个操作数的值相同时,异或结果为0。基于这一特性,我们可以梳理出代码的基本逻辑:整个流程分为加密和解密两个主要部分。
1. 加密过程
加密的第一步是将文件内容转换为二进制格式,并生成一个与原数据等长的随机密钥。随后,对原始二进制数据与随机密钥执行异或操作,从而生成加密后的二进制文件。在此过程中,需要保留的关键数据包括加密后的二进制文件以及生成的随机密钥,二者本质上均为二进制数值。
2. 解密过程
解密过程相对简单。将之前生成的加密二进制文件与原始随机密钥再次进行异或运算,即可还原出最初的二进制数据。最后,将还原后的二进制数据转换回文本格式,即可得到原始文档内容。
综上所述,我们需要编写两个独立的程序。加密程序接收字符串参数(即原始文件路径或内容),运行后输出加密后的二进制Word文档以及用于解密的二进制密钥。解密程序则接收两个整数参数(分别对应加密程序输出的加密数据和密钥),执行异或运算后输出原始文本内容。接下来展示具体代码实现。
加密代码实现
from secrets import token_bytes
from docx import Document
import docx
import time
def random_key(length):
# token_bytes,函数接受一个int参数,用于指定随机字节串的长度。
# int.from_bytes把字节串转换为int,也就是我们需要的二进制数
key = token_bytes(nbytes=length)
key_int = int.from_bytes(key, 'big')
return key_int
def encrypt(raw):
raw_bytes = raw.encode()
#参数big意为正序,little则输出反序。
raw_int = int.from_bytes(raw_bytes, 'big')
key_int = random_key(len(raw_bytes))
return raw_int ^ key_int, key_int
def decrypt(encrypted, key_int):
decrypted = encrypted ^ key_int
length = (decrypted.bit_length() + 7) // 8
decrypted_bytes = int.to_bytes(decrypted, length, 'big')
return decrypted_bytes.decode()
def encrypt_file(path, key_path=None,):
document = Document(path)
all_paragraphs = document.paragraphs
file = docx.Document()
file2 = docx.Document()
jkl = input('请输入希望保存的文件名:') + '.docx'
for paragraph in all_paragraphs:
# 打印每一个段落的文字
zz,key = encrypt(paragraph.text)
#print('加密:',zz)
#print('key:', key)
file.add_paragraph(str(zz))
file.save(jkl)
file2.add_paragraph(str(key))
file2.save("key.docx")
print('滑稽研究所出品!')
print('仅支持英文文件名。')
chenggong = encrypt_file(input('请输入需要加密的文件名:'))
print("已完成!十秒后自动关闭")
time.sleep(10)
#生成加密文件
在代码中,首先通过encode方法将字符串编码为字节串。接着,利用int.from_bytes函数将字节串转换为整数对象(即二进制数值)。最后,对转换后的二进制对象与随机生成的密钥进行异或操作,得到加密文本。
解密代码实现
from secrets import token_bytes
from docx import Document
import docx
import time
def random_key(length):
# token_bytes,函数接受一个int参数,用于指定随机字节串的长度。
# int.from_bytes把字节串转换为int,也就是我们需要的二进制数
key = token_bytes(nbytes=length)
key_int = int.from_bytes(key, 'big')
return key_int
def encrypt(raw):
raw_bytes = raw.encode()
raw_int = int.from_bytes(raw_bytes, 'big')
key_int = random_key(len(raw_bytes))
return raw_int ^ key_int, key_int
def decrypt(encrypted, key_int):
decrypted = encrypted ^ key_int
length = (decrypted.bit_length() + 7) // 8
decrypted_bytes = int.to_bytes(decrypted, length, 'big')
return decrypted_bytes.decode()
jjj = []
kkk = []
def decrypt_file(path_encrypted, key_path=None, *, encoding='utf-8'):
document = Document(path_encrypted)
all_paragraphs = document.paragraphs
do2 = Document('key.docx')
all_p= do2.paragraphs
for i in all_paragraphs:
#str转int
jiam = int(i.text)
jjj.append(jiam)
#print('加密:',jiam)
#print(jjj)
for k in all_p:
#str转int
key = int(k.text)
kkk.append(key)
#print('key:',key)
#print(kkk)
cc = zip(jjj,kkk)
res = list(cc)
return res
#传入元组,或两个int。
print('滑稽研究所出品!')
print('警告,严禁修改密钥文件名!!!')
print('直接输入文件名,无需格式后缀。')
rr1 = decrypt_file(input("请输入需要破解文件的文件名(仅限.docx文件):")+'.docx')
file = docx.Document()
for i in rr1:
ff = decrypt(*i)
#print(ff)
#print(type(ff))
file.add_paragraph(ff)
file.save("res.docx")
print('解密完成,请在当前文件夹下提取文件!')
print('十秒后自动关闭!')
time.sleep(10)
建议将这两个程序打包为exe可执行文件。加密后生成的二进制Word文档可以分发给他人,但密钥必须由持有者妥善保管。当接收方满足特定条件后,方可将密钥和解密程序交予对方。需要注意的是,该方案仅对.docx文件有效,且严禁修改密钥文件的名称,否则会导致报错和解密失败。
运行结果展示
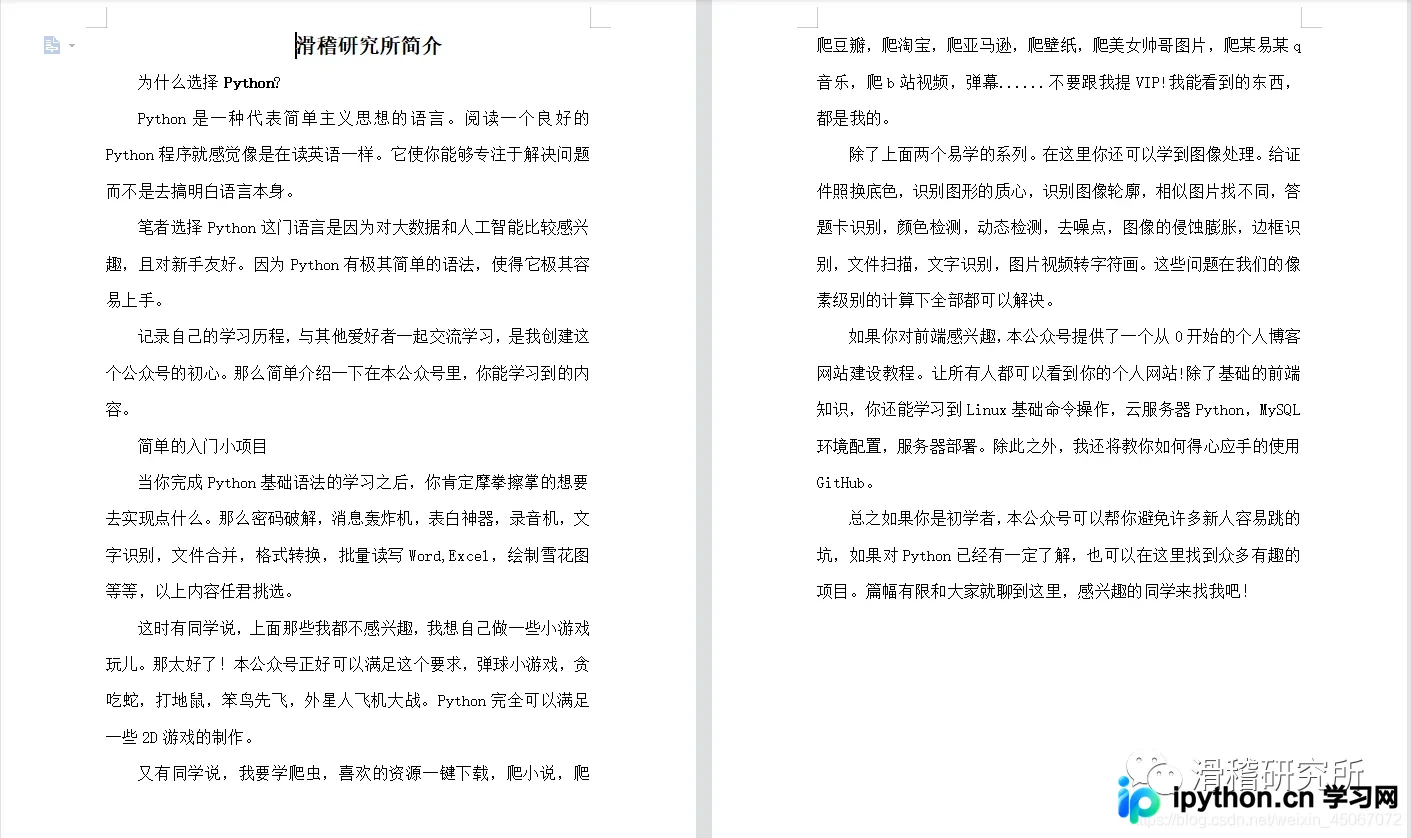
原始Word文件。
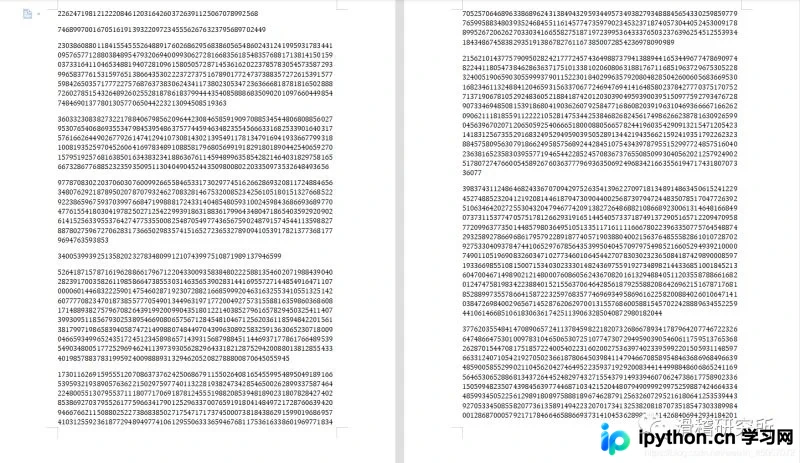
加密后的文件效果。
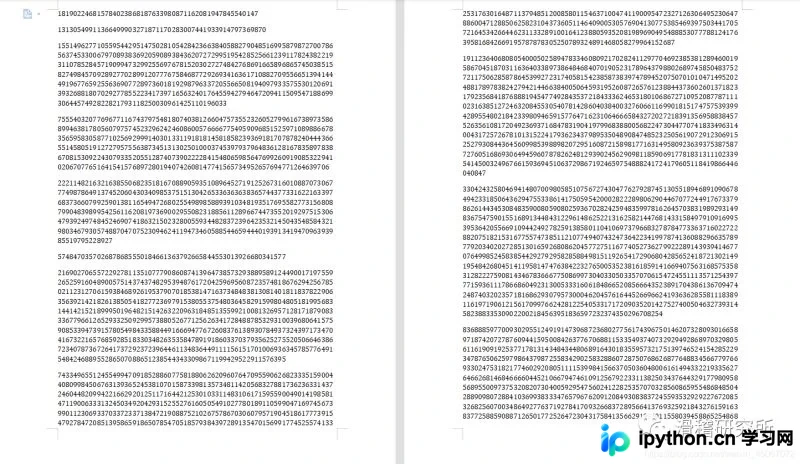
生成的密钥文件内容。
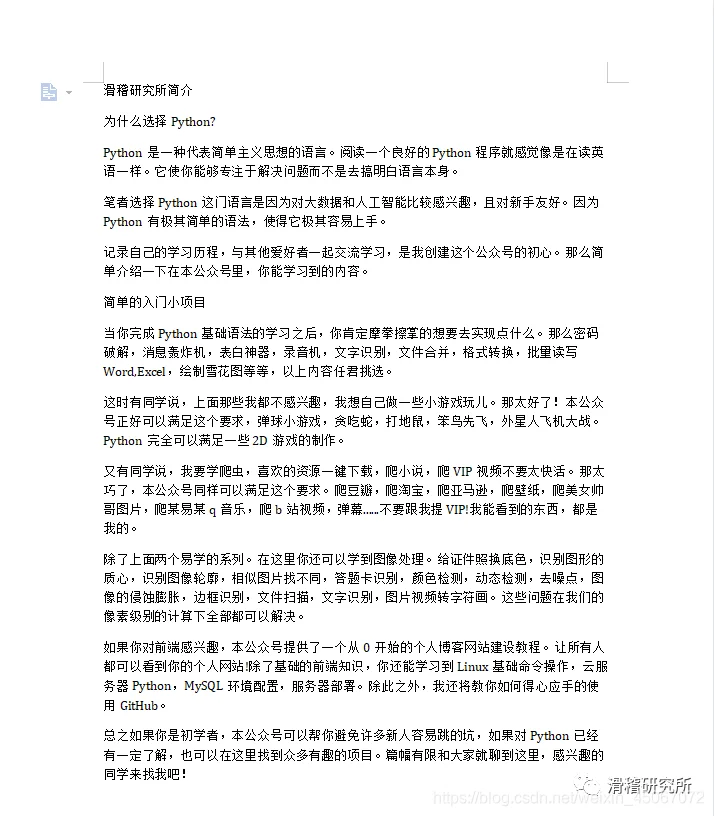
将加密后的文件和生成的密钥放置于解密程序所在的文件夹下后,运行解密程序可得如下结果。我们成功还原了原文件,但美中不足的是,所有段落的原始首行缩进格式丢失,全部变为左对齐。
对于同一个源文件,每次加密都会生成不同的加密文件和对应的密钥。因此,如果加密文件与密钥不匹配,即使源文件相同,也无法成功解密。此外,一旦密钥丢失,加密的文件将永久无法解密。
总结
本文到此结束,希望能为读者提供有益的帮助。同时也欢迎大家关注本站,获取更多技术内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















