


Python线性回归算法实战:从原理到多模型对比评估

本文详细介绍Python中线性回归的应用,涵盖最小二乘法、贝叶斯岭回归、弹性网络及支持向量机回归等多种算法。通过完整代码示例,展示如何生成模拟数据、训练不同回归模型,并利用交叉检验、均方误差及R²等指标评估模型效果,最后实现可视化对比与新数据预测。
内容概览
本文将以Python语言为例,简要介绍线性回归在回归分析中的基础应用。
线性回归旨在通过线性方法,模拟因变量与一个或多个自变量之间的依赖关系。
在模型构建中,自变量作为输入数据,因变量则是模型基于这些输入计算出的输出结果。该方法主要适用于自变量x与因变量y之间存在线性关系的数据场景。
回归模型的核心作用是预测输入变量与输出变量间的关联,尤其适用于当输入变量数值发生变动时,输出变量也随之呈现规律性变化的场景。
从数学角度看,回归模型定义了从输入变量空间到输出变量空间的映射函数。
线性回归是众多模型中最基础的一种,其核心假设是因变量与自变量之间呈现线性关系,通常表现为一条直线,结构简单且易于理解。
典型应用场景
连续性数据预测:常见案例包括房价估算、销售额预测以及贷款额度评估等。
通俗而言,该方法利用历史连续数据来推断未来的特定数值。
线性回归的常见实现算法
常用的线性回归算法包括最小二乘法、贝叶斯岭回归、弹性网络回归、支持向量机回归(SVR)等。
线性回归的代码实现
import numpy as np  # numpy库
from sklearn.linear_model import BayesianRidge, LinearRegression, ElasticNet,Lasso  # 批量导入要实现的回归算法
from sklearn.svm import SVR  # SVM中的回归算法
from sklearn.ensemble.gradient_boosting import GradientBoostingRegressor  # 集成算法
from sklearn.model_selection import cross_val_score  # 交叉检验
from sklearn.metrics import explained_variance_score, mean_absolute_error, mean_squared_error, r2_score  # 批量导入指标算法
import pandas as pd  # 导入pandas
import matplotlib.pyplot as plt  # 导入图形展示库
import random

# 随机生成100组包含5组特征的数据
feature = [[random.random(),random.random(),random.random(),random.random(),random.random()] for i in range(100)]
dependent = [round(random.uniform(1,100),2) for i in range(100)]

# 训练回归模型
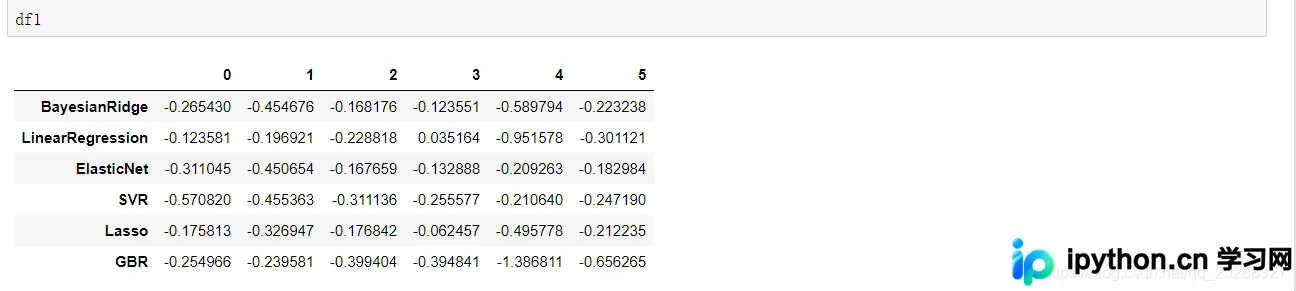
n_folds = 6  # 设置交叉检验的次数
model_br = BayesianRidge()  # 建立贝叶斯岭回归模型对象
model_lr = LinearRegression()  # 建立普通线性回归模型对象
model_etc = ElasticNet()  # 建立弹性网络回归模型对象
model_svr = SVR()  # 建立支持向量机回归模型对象
model_la = Lasso()  # 建立支持向量机回归模型对象
model_gbr = GradientBoostingRegressor()  # 建立梯度增强回归模型对象
model_names = ['BayesianRidge', 'LinearRegression', 'ElasticNet', 'SVR', 'Lasso','GBR']  # 不同模型的名称列表
model_dic = [model_br, model_lr, model_etc, model_svr,model_la, model_gbr]  # 不同回归模型对象的集合
cv_score_list = []  # 交叉检验结果列表
pre_y_list = []  # 各个回归模型预测的y值列表
for model in model_dic:  # 读出每个回归模型对象
    scores = cross_val_score(model, feature, dependent, cv=n_folds)  # 将每个回归模型导入交叉检验模型中做训练检验
    cv_score_list.append(scores)  # 将交叉检验结果存入结果列表
    pre_y_list.append(model.fit(feature, dependent).predict(feature))  # 将回归训练中得到的预测y存入列表
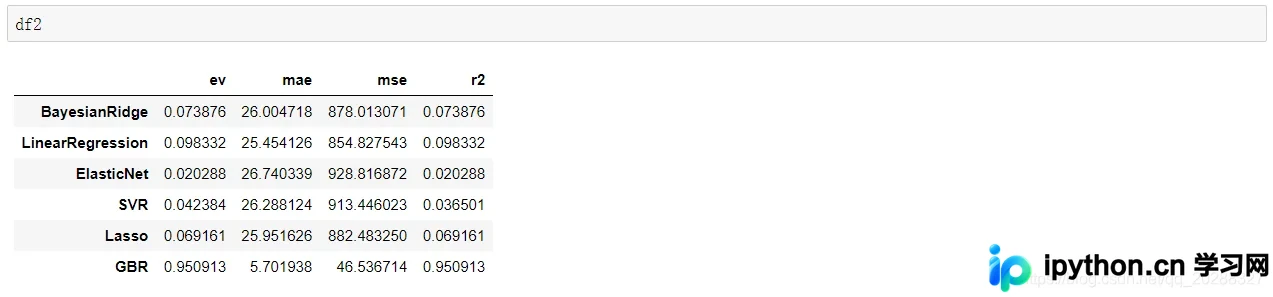
线性回归模型的评估指标
model_gbr: 拟合贝叶斯岭回归模型,并对正则化参数lambda(权重精度)和alpha(噪声精度)进行优化。
model_lr: 线性回归拟合系数w=(w1,…)的线性模型,其目标是将观测到的目标值与线性近似预测值之间的残差平方和降至最小。
model_etc: 采用L1和L2先验组合作为正则项的线性回归方法。
model_svr: 线性支持向量回归(SVR)。
model_la: 使用L1先验作为正则化器(即Lasso回归)训练的线性模型。
# 模型效果指标评估
model_metrics_name = [explained_variance_score, mean_absolute_error, mean_squared_error, r2_score]  # 回归评估指标对象集
model_metrics_list = []  # 回归评估指标列表
for i in range(6):  # 循环每个模型索引
    tmp_list = []  # 每个内循环的临时结果列表
    for m in model_metrics_name:  # 循环每个指标对象
        tmp_score = m(dependent, pre_y_list[i])  # 计算每个回归指标结果
        tmp_list.append(tmp_score)  # 将结果存入每个内循环的临时结果列表
    model_metrics_list.append(tmp_list)  # 将结果存入回归评估指标列表
df1 = pd.DataFrame(cv_score_list, index=model_names)  # 建立交叉检验的数据框
df2 = pd.DataFrame(model_metrics_list, index=model_names, columns=['ev', 'mae', 'mse', 'r2'])  # 建立回归指标的数据框
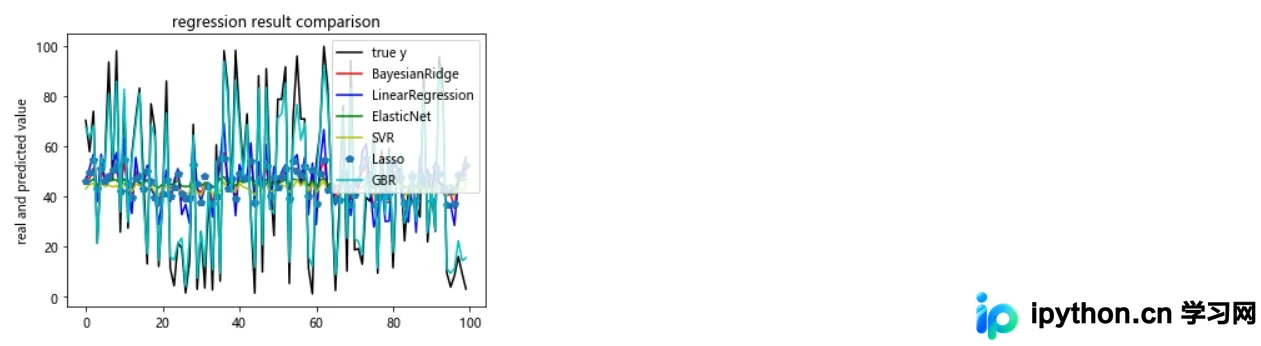
线性回归效果可视化分析
# 模型效果可视化
plt.figure()  # 创建画布
plt.plot(np.arange(len(feature)), dependent, color='k', label='true y')  # 画出原始值的曲线
color_list = ['r', 'b', 'g', 'y', 'p','c']  # 颜色列表
linestyle_list = ['-', '.', 'o', 'v',':', '*']  # 样式列表
for i, pre_y in enumerate(pre_y_list):  # 读出通过回归模型预测得到的索引及结果
    plt.plot(np.arange(len(feature)), pre_y_list[i], color_list[i], label=model_names[i])  # 画出每条预测结果线
plt.title('regression result comparison')  # 标题
plt.legend(loc='upper right')  # 图例位置
plt.ylabel('real and predicted value')  # y轴标题
plt.show()  # 展示图像
数据预测实战
# 模型应用
new_point_set = [[random.random(),random.random(),random.random(),random.random(),random.random()],
                 [random.random(),random.random(),random.random(),random.random(),random.random()],
                 [random.random(),random.random(),random.random(),random.random(),random.random()],
                [random.random(),random.random(),random.random(),random.random(),random.random()]]  # 要预测的新数据集

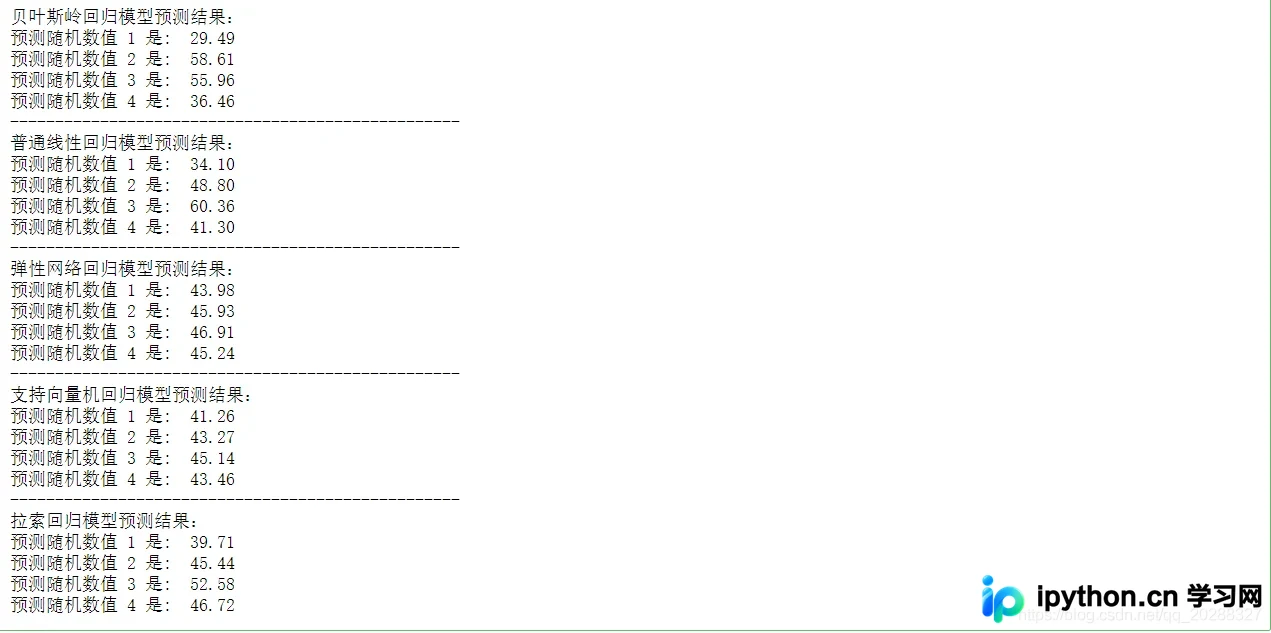
print("贝叶斯岭回归模型预测结果:")
for i, new_point in enumerate(new_point_set):  # 循环读出每个要预测的数据点
    new_pre_y = model_gbr.predict(np.array(new_point).reshape(1,-1))
    print ('预测随机数值 %d 是:  %.2f' % (i + 1, new_pre_y))  # 打印输出每个数据点的预测信息
print (50 * '-')
print("普通线性回归模型预测结果:")
for i, new_point in enumerate(new_point_set):  # 循环读出每个要预测的数据点
    new_pre_y = model_lr.predict(np.array(new_point).reshape(1,-1))
    print ('预测随机数值 %d 是:  %.2f' % (i + 1, new_pre_y))  # 打印输出每个数据点的预测信息
print (50 * '-')
print("弹性网络回归模型预测结果:")
for i, new_point in enumerate(new_point_set):  # 循环读出每个要预测的数据点
    new_pre_y = model_etc.predict(np.array(new_point).reshape(1,-1))
    print ('预测随机数值 %d 是:  %.2f' % (i + 1, new_pre_y))  # 打印输出每个数据点的预测信息
print (50 * '-')
print("支持向量机回归模型预测结果:")
for i, new_point in enumerate(new_point_set):  # 循环读出每个要预测的数据点
    new_pre_y = model_svr.predict(np.array(new_point).reshape(1,-1))
    print ('预测随机数值 %d 是:  %.2f' % (i + 1, new_pre_y))  # 打印输出每个数据点的预测信息
print (50 * '-')
print("拉索回归模型预测结果:")
for i, new_point in enumerate(new_point_set):  # 循环读出每个要预测的数据点
    new_pre_y = model_la.predict(np.array(new_point).reshape(1,-1))
    print ('预测随机数值 %d 是:  %.2f' % (i + 1, new_pre_y))  # 打印输出每个数据点的预测信息
以上即为回归预测分析中Python数据化运营线性回归的详细内容,更多关于python数据化运营线性回归的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















