


mysqldump全库、单库及单表备份与还原命令详解

在日常数据库维护中,无论是整库迁移、灾难演练,还是修复误删的一张业务配置表,mysqldump 都是最基础且直接的逻辑导出工具。它的本质不是复制物理磁盘块,而是把数据库对象反向解析为一条条标准的 SQL 语句(DDL 建表语句与 DML 插入语句)。理解它在全库、单库与单表三个不同颗粒度下的语法差异与还原逻辑,能够避免诸如“导出的文件不知道还原到哪个库”或“导入单表直接冲掉全库”的运维失误。
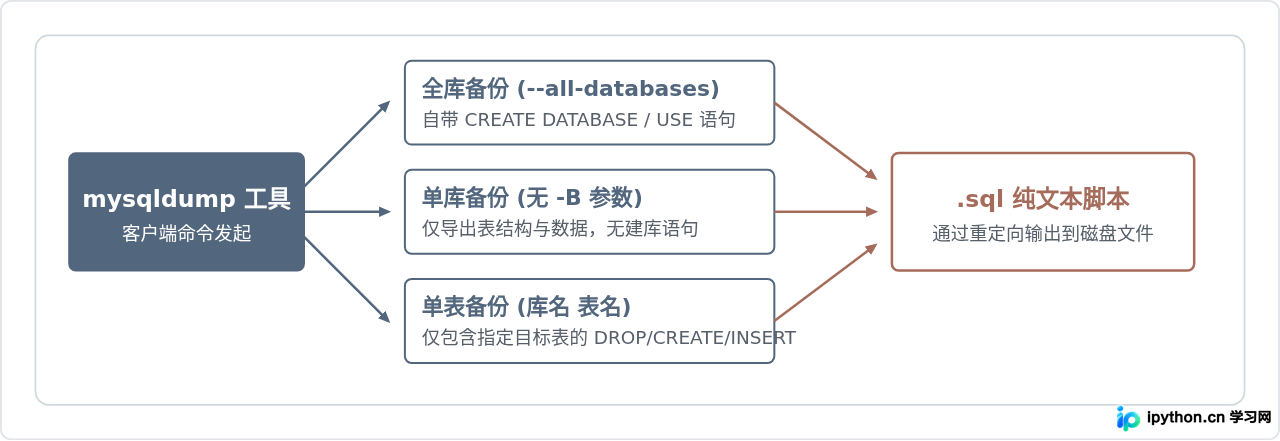
一、三个核心备份场景命令详解
1. 全库备份(All Databases)
全库备份通常用于整机数据库迁移或日常完整性归档。当指定 --all-databases(或简写 -A)参数时,mysqldump 会遍历 MySQL 实例中的所有系统库(如 mysql、sys)及用户业务库,并在导出的 SQL 脚本中显式写入 CREATE DATABASE IF NOT EXISTS 和 USE `dbname` 语句。
# 语法:备份整个实例内的所有数据库
mysqldump -u root -p \
  --single-transaction \
  --quick \
  --routines \
  --events \
  --triggers \
  --all-databases > /backup/mysql/all_databases_$(date +%F).sql
输出的文件中已经内嵌了指向各个库的切换逻辑,因此该文件具有完备的自包含性。
2. 单库备份(Single Database)
对单一业务库的备份有两种常见写法。很多初学者容易忽略 -B(--databases)参数的作用,这会导致备份文件中缺少建库与切库指令:
# 方式 A(标准单库,推荐):包含建库语句
mysqldump -u root -p --single-transaction --quick -B app_db > /backup/mysql/app_db_with_create.sql

# 方式 B(纯对象备份):不包含建库语句,只导出表结构与数据
mysqldump -u root -p --single-transaction --quick app_db > /backup/mysql/app_db_tables_only.sql
如果使用方式 B,导出的 SQL 文件第一行直接是 DROP TABLE IF EXISTS ...,它假定你在还原时会显式指定库名。如果要在异机将现有业务库恢复成一个新名字(例如还原为 app_db_test),方式 B 反而更加灵活。
3. 单表与指定多表备份(Single & Specific Tables)
当只针对某个有异常风险的表(如支付流水表或大配置表)进行操作前快照时,无需备份全库。只需在库名后直接追加表名,中间用空格隔开:
# 语法:mysqldump [连接参数] [库名] [表1] [表2 ...] > 备份文件.sql
mysqldump -u root -p --single-transaction --quick app_db user_orders > /backup/mysql/app_db_user_orders.sql

# 备份单库下的多张关联表
mysqldump -u root -p --single-transaction --quick app_db user_orders order_items > /backup/mysql/app_db_orders_tables.sql
单表备份生成的文件完全依赖于具体库。它不包含数据库定义语句,仅包含目标表的建表结构定义及连续的 INSERT 批量插入块。
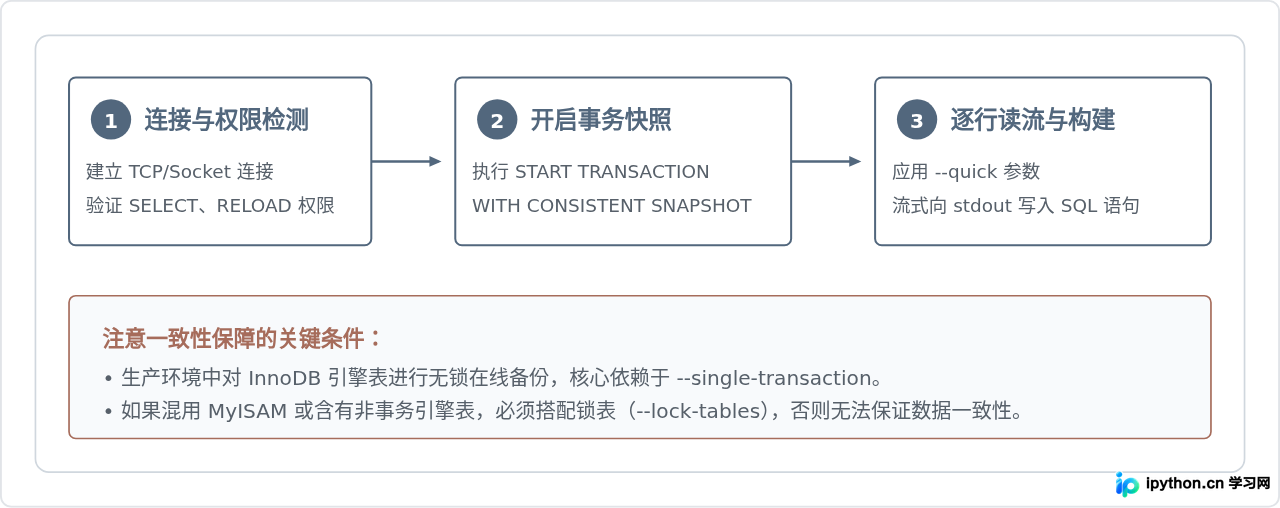
二、关键生产参数作用与解析
许多线上备份事故并不是因为命令拼错,而是忽略了参数背后的性能与逻辑影响。在线上生产库执行导出时,务必清楚以下核心参数的意义:
| 参数选项 | 核心功能与机制 | 推荐配置与原因 |
|---|---|---|
--single-transaction |
在导出前开启一个可重复读的事务快照(REPEATABLE READ),读取快照视图。 |
InnoDB 必加。可实现在线热备而不堵塞业务读写,彻底告别锁全表。 |
--quick(-q) |
不将整个结果集一次性读入本地内存,而是采用流式机制逐行拉取数据并输出。 | 必加。大表导出时防止客户端机器发生 OOM(内存溢出)崩溃。 |
--master-data=2 或 --source-data=2 |
在 SQL 文件头部以注释形式记录导出瞬间对应的 Binlog 坐标与文件名。 | 主从复制同步或增量恢复时必备,可准确定位恢复起点。 |
--routines / --events |
一并导出存储过程、自定义函数与调度定时事件。 | 默认不导出。如果业务依赖此类服务端对象,迁移时必须显式开启。 |
--set-gtid-purged=OFF |
控制是否向导出文件中写入 @@GLOBAL.gtid_purged。 |
跨实例迁移非核心库或单表时推荐关闭,避免因 GTID 冲突报错中止。 |
三、对应的还原命令与逻辑差异
很多人误以为还原无论什么文件都只要 mysql -u root -p < file.sql 即可。但实际上,还原命令的写法严格取决于导出时是否包含了环境切换语句。如果执行方式不对,要么数据会导入到错误的库中,要么会报 ERROR 1046 (3D000): No database selected。
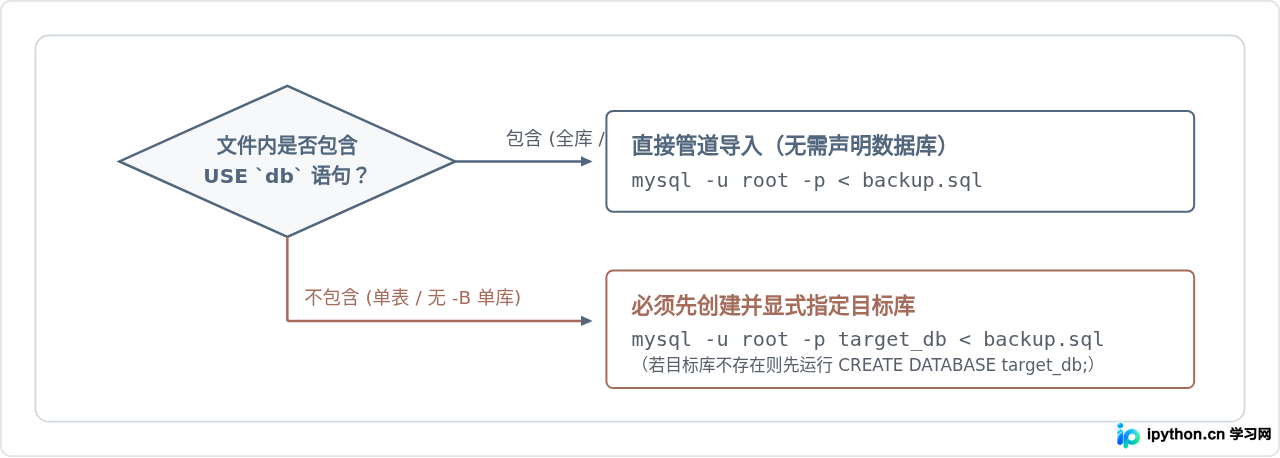
1. 全库与带 -B 备份的还原
这类文件内已经明确声明了要创建的库以及每个表属于哪个库,还原时不需要也不应该在命令行结尾绑定具体库名:
# 命令行标准导入
mysql -u root -p < /backup/mysql/all_databases_2026-09-18.sql

# 或者进入 MySQL 交互式控制台通过 source 执行
mysql> source /backup/mysql/all_databases_2026-09-18.sql;
2. 不带 -B 单库的还原
如果导出时没有使用 -B,文件内不含建库语法。还原前必须确认目标库已建立,并在执行导入时传入库名:
# 第一步:确保目标库存在
mysql -u root -p -e "CREATE DATABASE IF NOT EXISTS app_db CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;"

# 第二步:显式指定目标库导入
mysql -u root -p app_db < /backup/mysql/app_db_tables_only.sql
3. 单表还原
单表备份文件中默认会包含 DROP TABLE IF EXISTS `表名`; 和 CREATE TABLE ... 语句。将单表导入指定库时,命令格式与无 -B 的单库一致:
# 将 user_orders 恢复至主生产库 app_db
mysql -u root -p app_db < /backup/mysql/app_db_user_orders.sql

# 如果仅用于临时比对排错,也可以将其恢复至测试库中,避免覆盖原生产表
mysql -u root -p app_db_sandbox < /backup/mysql/app_db_user_orders.sqlDROP TABLE IF EXISTS 具有破坏性。如果不希望直接覆盖现有线上表,可在还原前用文本编辑器检查备份文件首部,将建表语句重命名为 user_orders_recovery,再执行导入。
四、排错、安全与数据完整性检验
完成了导出和导入指令并不意味着数据保护工作闭环。在实际工程落地中,以下四道验证步骤用于确保备份是完整可用的:
-
检查备份文件的尾部标记:
由于
mysqldump执行过程通过流式输出,如果在导出中途进程被系统杀掉(例如爆内存或网络断开),生成的文件往往只写入了一半。正常结束的 SQL 文件最后一行必定会输出执行完成的时间戳标记:tail -n 2 /backup/mysql/app_db_user_orders.sql # 正常输出示例: # -- Dump completed on 2026-09-18 10:30:00 -
临时关闭外键检查加速导入:
大表或多关联表在还原时,默认每次插入都会校验外键约束与唯一索引,极大地拖慢还原速度。通常导出的 SQL 开头会自动包含
SET FOREIGN_KEY_CHECKS=0;,但如果手动编写恢复脚本,应确保在执行还原会话中将外键检查与自动提交进行暂时挂起:SET FOREIGN_KEY_CHECKS = 0; SET UNIQUE_CHECKS = 0; SET AUTOCOMMIT = 0; -- 执行导入数据... COMMIT; SET FOREIGN_KEY_CHECKS = 1; SET UNIQUE_CHECKS = 1; -
字符集明确声明:
避免源库与导入端系统默认编码不一致产生中文乱码。如果数据包含 Emoji 或多语言字符,建议在导出与导入两端均显式加上
--default-character-set=utf8mb4。 -
行数对账抽检:
还原完成后,通过简单的统计查询对比核心表在源库与目标库的行数(Row Count),确保还原没有中断:
SELECT count(*) FROM app_db.user_orders;
五、全库、单库与单表对比总结
最后,我们将三种粒度备份的核心特征与适用场景进行横向对照,方便在具体维护工作中快速做技术决策:
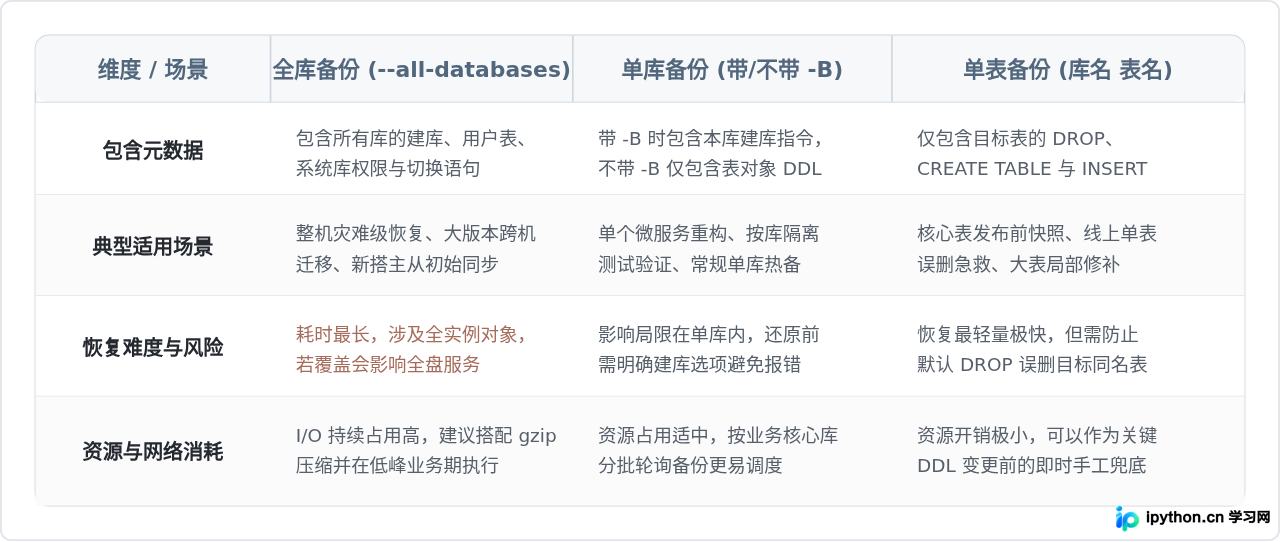
掌握了命令与参数的区别后,编写定时任务或手动应急导出时就会游刃有余。面对大规模数据库时,逻辑备份随着数据量增长在耗时和恢复吞吐上会遇到瓶颈,但对于中小数据量以及绝大部分特定模块、单库的日常维护,mysqldump 依然是保证数据安全底线最可靠、最透明的工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















