


Python计算双重差分模型DID及其对应P值使用详解

本文详解如何利用Python的statsmodels库进行双重差分模型(DID)计算及P值获取。通过构建时间、分组及交互项,使用OLS多项式拟合方法评估政策干预效果,并解读回归结果中的系数与显著性。
1. DID(Differences-in-Differences)定义
双重差分法主要应用于社会学领域的政策效果评估。该方法依赖于两个「差异」数据:一是干预前后自身的「差异」,二是干预组与对照组之间的「差异」。DID通过计算这两个「差异」的差值来推断干预的实际效果,因此得名双重差分法。
其原理基于反事实框架,评估政策发生与未发生时观测因素y的变化。若外生政策冲击将样本分为受干预的Treat组和未受干预的Control组(且政策前两组y无显著差异),则可将Control组在政策前后的y变化视为Treat组未受冲击时的反事实状态。通过比较Treat组y的变化(D1)与Control组y的变化(D2),即可得出政策冲击的实际效果(DD=D1-D2)。
注意:仅在满足“政策冲击前Treat组和Control组的y没有显著差异”(即平行性假定)的条件下,所得的双重差分估计量才是无偏的。
如下图所示:
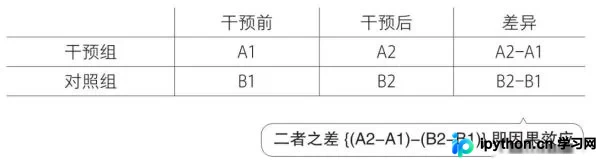
设干预组实验前为A1,实验后为A2;对照组实验前为B1,实验后为B2。干预组实验前后差异为A2-A1,对照组实验前后差异为B2-B1。两者之差(A2-A1)-(B2-B1)即为DID结果,代表因果效应或处理效应,如图中所示部分。
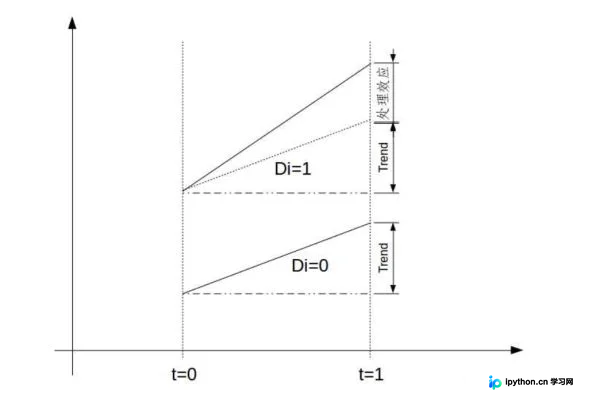
2. DID模型形式
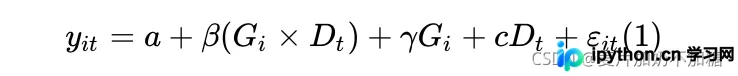
 为分组虚拟变量(处理组=1,控制组=0);
 为分期虚拟变量(政策实施后=1,政策实施前=0);
交互项  表示处理组在政策实施后的效应,其系数即为双重差分模型重点考察的处理效应。
3. OLS多项式拟合
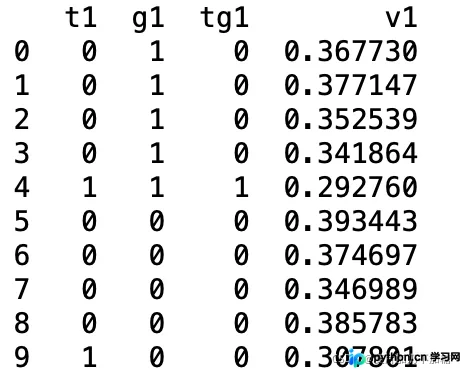
根据DID公式,可通过多项式拟合方法求得DID及其P值。以下为Python实现方法:使用statsmodels库中的ols方法,需按上述公式准备数据。其中t代表时间(干预前=0,干预后=1),g代表分组(干预组=1,对照组=0),以及交叉项tg(计算t*g即可)。
代码如下:
import statsmodels.formula.api as smf
import pandas as pd
v1 =[0.367730,0.377147,0.352539,0.341864,0.29276,0.393443,0.374697,0.346989,0.385783,0.307801]
t1 = [0,0,0,0,1,0,0,0,0,1]
g1 =[1,1,1,1,1,0,0,0,0,0]
tg1 = [0,0,0,0,1,0,0,0,0,0]
aa = pd.DataFrame({'t1':t1,'g1':g1,'tg1':tg1,'v1':v1})
X = aa[['t1', 'g1','tg1']]
y = aa['v1']
est = smf.ols(formula='v1 ~ t1 + g1 + tg1', data=aa).fit()
y_pred = est.predict(X)
aa['v1_pred'] = y_pred
print(aa)
print(est.summary())
print(est.params)
准备数据格式如下:
OLS结果Summary如下:
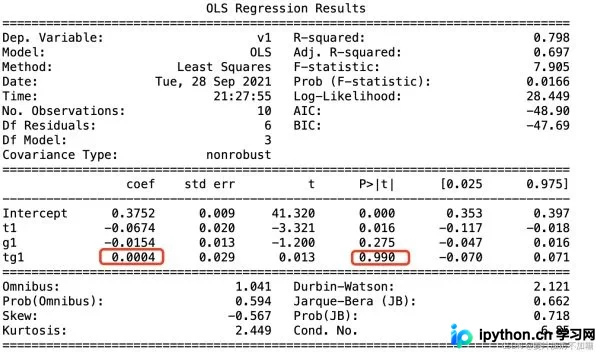
交叉项的系数即为DID结果(处理效应)。P>| t |为其P值,若小于0.05则表示差异显著。
参考资料:
1. 双重差分法(DID)入门必看 - 知乎
2. 什么是双重差分模型(:difference-in-differences model)? - 知乎
3. Python 普通最小二乘法(OLS)进行多项式拟合的方法
以上就是Python计算DID及其对应P值使用详解的详细内容,更多关于Python计算DID及对应P值的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















