


Python五种下划线用法详解:从命名规范到魔术方法

本文详细解析Python中五种下划线的使用场景。涵盖后单下划线避免关键字冲突、前单下划线提示内部使用、前双下划线实现名称修饰防止子类覆盖、前后双下划线定义魔术方法,以及单下划线在交互模式和循环中的临时变量作用。
网络上关于Python下划线的资料众多,但大多相互复制,甚至直接翻译官方文档,导致许多读者感到困惑。本文将用通俗易懂的方式,逐一厘清这几种下划线的具体用法和含义。
1、后单下划线(例如:data_)
这种用法的主要目的是避免与Python的关键字发生命名冲突。例如,Python中保留有 `class` 关键字,如果用户希望将变量命名为 `class`,直接赋值会引发语法错误。此时,在变量名后添加下划线变为 `class_`,即可成功定义该变量。
这一机制对于具备基础编程经验的开发者而言,属于常识性操作。
2、前单下划线(例如:_data)
前导下划线主要用于向其他开发者发出“内部使用”的提示。它表明该变量或函数仅供模块内部调用,不建议在外部直接访问。尽管这是一种约定而非强制限制,外部代码仍可通过 `_data` 直接访问,但遵循良好的编程规范应尊重这一提示。对于函数而言,道理相同。
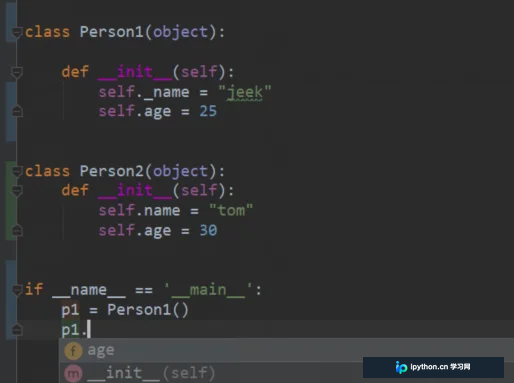
在交互式环境中,输入 `_data` 时系统可能不会自动补全或高亮显示,但这并不意味着无法调用。只要明确知道变量名,外部代码依然可以强制访问它。
3、前双下划线(例如:__data)
前导双下划线的作用更为特殊,它触发了Python的名称修饰机制(Name Mangling)。这通常用于定义类的“私有”属性或方法。其核心目的是防止子类在重写父类方法时意外覆盖父类的内部实现。如果子类尝试直接访问或覆盖以双下划线开头的属性,通常会引发错误或行为不符合预期。
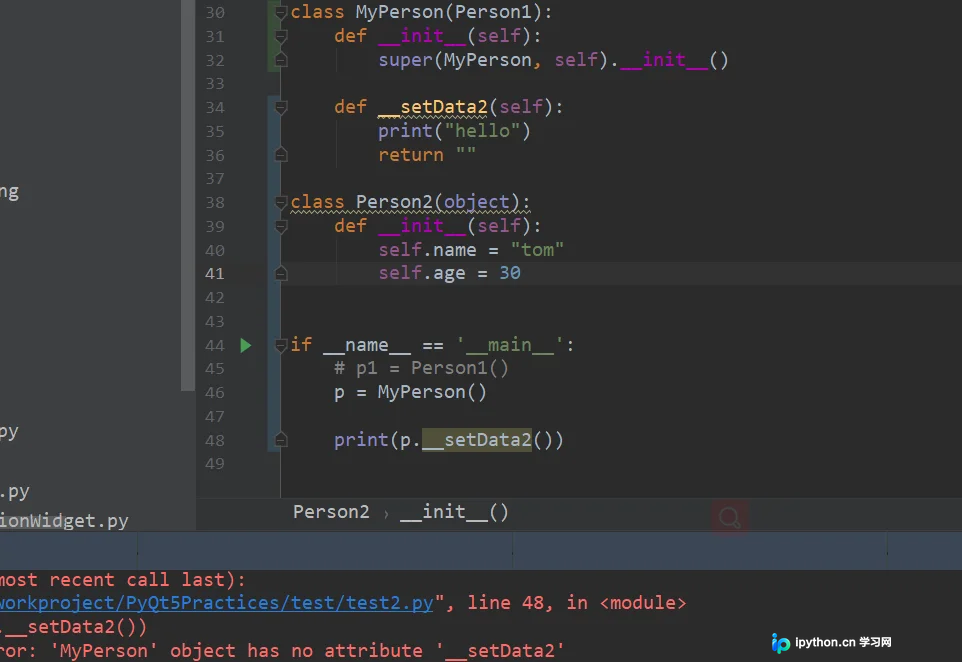
理解这一点即可,其本质是Python解释器在内部对属性名进行了重命名处理。
4、前后双下划线(例如:__data__)
这种形式的下划线包裹的变量或方法,通常是Python解释器预留的“魔术方法”或特殊属性。开发者一般不应自定义此类名称,以免与Python内置机制冲突。例如:
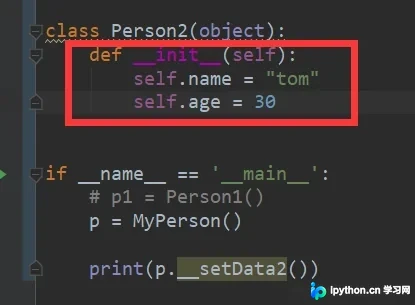
这些由双下划线包裹的方法由系统内部调用。当我们实例化对象如 `Person()` 时,解释器会自动调用 `__init__` 构造函数;当调用内置函数 `len()` 时,解释器内部也会调用相应的 `__len__` 方法。了解这些魔术方法的触发时机即可,无需手动调用。
5、单下划线(例如:_)
单下划线在Python中有两种常见用途:
首先,它可作为临时变量名。例如在 `for _ in "hongbiao":` 中,下划线表示循环中不需要使用迭代变量的值,这与普通变量命名无本质区别,仅用于忽略不需要的返回值。
其次,在交互式解释器中,单下划线 `_` 代表最近一次表达式的计算结果。如前文截图所示,这一特性方便开发者快速复用上一步的计算值。
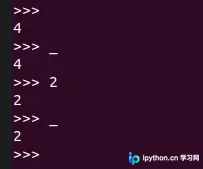
需要注意的是,如果用户显式地对 `_` 进行了赋值操作,它将不再自动指向最近一次的计算结果,而是存储用户赋予的新值。
总结
本文至此结束,希望能为读者提供清晰的指引。欢迎持续关注本站,获取更多技术干货。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















